如何对 TPU 程序进行性能分析(How to Profile TPU Programs)#
《How To Scale Your Model》系列第 9 部分(第 8 部分:Serving LLaMA | 第 10 部分:JAX)
到目前为止,本系列的内容完全是理论性的:基于硬件 roofline(屋顶线)的粗略估算。这种理解能让你走得很远,但许多优化最终都要落到实际细节上:XLA 编译器是如何工作的,以及当它出问题时如何使用 JAX/Tensorboard Profiler 这类性能分析工具来定位问题。我们将在这里讨论这些内容。
目录
TPU 软件栈的高空鸟瞰视角(A Thousand-Foot View of the TPU Software Stack)
JAX Profiler:一款多用途的 TPU 性能分析器(The JAX Profiler: A Multi-Purpose TPU Profiler)
- Trace Viewer(轨迹查看器)
- 如何阅读一个 XLA op(How to read an XLA op)
- Graph Viewer(图查看器)
- 看一个真实(一点)的示例 profile(Looking at a real(ish) example profile)
- Memory Profile(内存分析)
TPU 软件栈的高空鸟瞰视角#
Google 提供了一组用于编程 TPU 的 API,从高层的 JAX 代码一直到底层的 Pallas 或 HLO。大多数程序员只编写 JAX 代码,它允许你写抽象的 NumPy 风格的线性代数程序,这些程序会被自动编译以高效地运行在 TPU 上。
下面是一个简单的例子,一个将两个矩阵相乘的 JAX 程序:
import jax
import jax.numpy as jnp

def multiply(x, y):
  return jnp.einsum('bf,fd->db', x, y)

y = jax.jit(multiply)(jnp.ones((128, 256)), jnp.ones((256, 16), dtype=jnp.bfloat16))
通过调用 jax.jit,我们告诉 JAX 去 trace(追踪)这个函数,并发出一种称为 StableHLO 的较低级 IR(中间表示),它是一个面向机器学习计算的、与平台无关的 IR,随后由 XLA 编译器进一步降低为 HLO。编译器会运行许多 pass(编译阶段)来决定 fusion(融合)、layout(布局)以及其他因素,从而生成可以在 JAX profile 中观察到的 HLO。这种 HLO 以 LLVM 风格的图视图表示了 JAX 代码中所有核心的线性代数操作(matmul、pointwise op、卷积等)。例如,下面是上述程序对应 HLO 的简化版本(要获取这个 HLO,可以运行 jax.jit(f).lower(*args, **kwargs).compile().as_text()):
ENTRY %main.5 (Arg_0.1: f32[128,256], Arg_1.2: bf16[256,16]) -> f32[16,128] {
  %Arg_1.2 = bf16[256,16]{1,0} parameter(1), metadata={op_name="y"}
  %convert.3 = f32[256,16]{1,0} convert(bf16[256,16]{1,0} %Arg_1.2),
  %Arg_0.1 = f32[128,256]{1,0} parameter(0), metadata={op_name="x"}
  ROOT %dot.4 = f32[16,128]{1,0} dot(f32[256,16]{1,0} %convert.3, f32[128,256]{1,0} %Arg_0.1), lhs_contracting_dims={0}, rhs_contracting_dims={1},
}
我们稍后会解释 HLO 的语法,但现在只需注意它实际上与上面的 JAX 代码相当吻合。例如:
ROOT %dot.4 = f32[16,128]{1,0} dot(f32[256,16]{1,0} %convert.3, f32[128,256]{1,0} %Arg_0.1), lhs_contracting_dims={0}, rhs_contracting_dims={1}就是上面那段代码里实际的矩阵乘法,将两个 f32 矩阵分别沿第 0 维和第 1 维相乘。
为了把这段 HLO 转换成可以在 TPU 上执行的代码,XLA 编译器首先将其降低为 LLO(low-level optimizer,低层优化器)IR。LLO 直接编程 TPU,调度内存之间的拷贝、把数组推入脉动阵列(systolic array)等等。LLO 代码包含将缓冲区推入脉动阵列的原语、从脉动阵列取回结果的原语,以及调度在不同 TPU 内存之间通信的 DMA。一旦降低到 LLO,它就会被编译成机器码,加载到 TPU 的 IMEM 中并执行。
当一个程序运行得比我们期望的慢时,我们主要在 JAX 层进行性能优化。然而要做到这一点,往往需要理解一些 HLO 的语义以及代码在 TPU 上实际是如何运行的。当问题发生在更底层时,我们会使用另一个 escape hatch(逃生口)——用 Pallas 编写自定义 kernel。要查看一个程序的 HLO 及其运行时统计信息,我们使用 JAX profiler。
JAX Profiler:一款多用途的 TPU 性能分析器#
JAX 提供了一款多用途的 TPU profiler,它带有一系列有用的工具,帮助你理解程序运行时 TPU 上发生了什么。你可以使用 jax.profiler 模块在程序运行时对其进行 trace,并记录从每个子部分的耗时、每个程序的 HLO、内存使用等等所有信息。例如,下面这段代码会把一个 trace 转储到 /tmp/tensorboard 中的某个文件,可以在 TensorBoard 中查看(这里是一份分步指南)。
import jax
with jax.profiler.trace("/tmp/tensorboard"):
  key = jax.random.key(0)
  x = jax.random.normal(key, (1024, 1024))
  y = x @ x
  y.block_until_ready()

# Now you can load TensorBoard in a Google Colab with
#
# !pip install tensorboard tensorboard-plugin-profile
# %load_ext tensorboard
# %tensorboard --logdir=/tmp/tensorboard
#
# or externally with
#
# > tensorboard --logdir=/tmp/tensorboard
#
这里是 profiler 中你可以做的事情的一个概览:
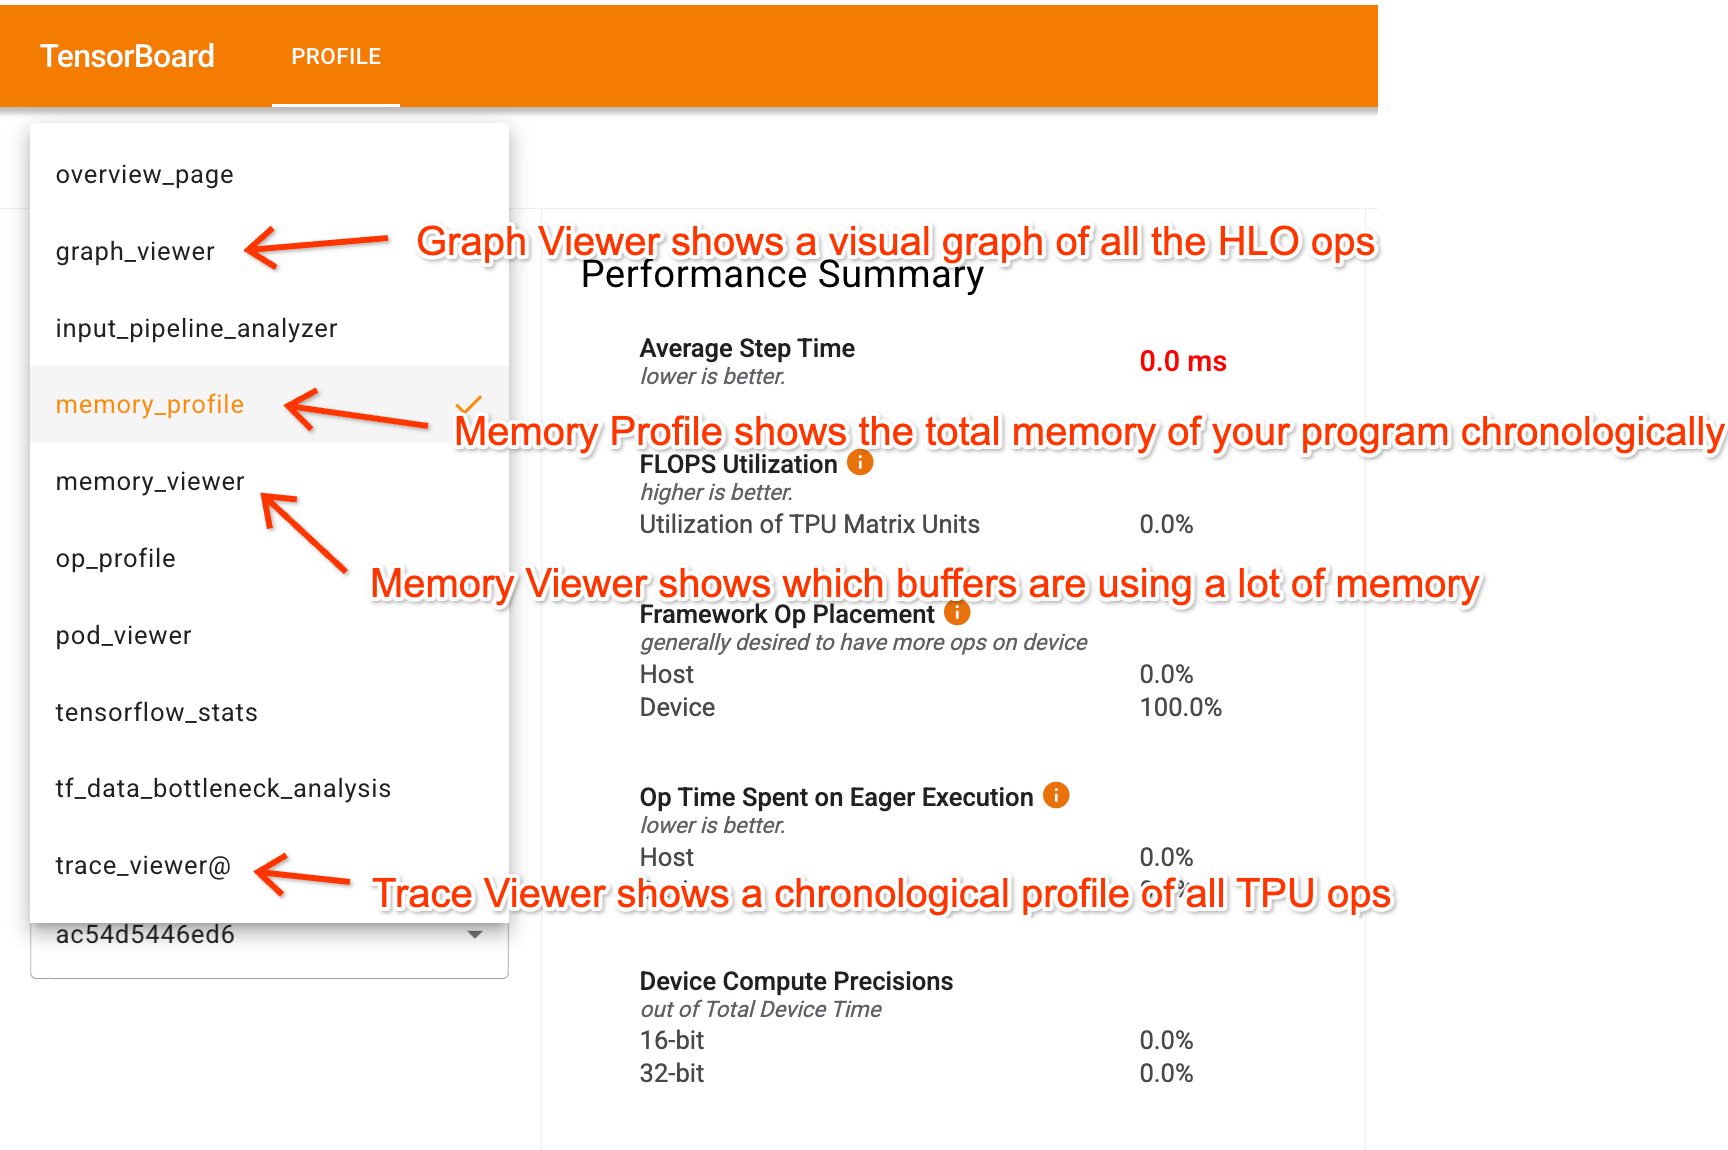
进入 TensorBoard 后,profiler 有几个关键的标签页可以帮你理解你的程序:
- Trace Viewer 显示 TPU 上实际发生事情的详细时间线。
- Graph Viewer 显示 HLO 图,让你能看到程序的哪些部分相互依赖以及它们是如何分片(sharded)的。
- Memory Profile 和 Memory Viewer: 这些显示你的程序使用了多少内存。
虽然分享 profile 有点困难,但这里有一个 Perfetto 链接,至少包含了一个简单 Transformer 的 Trace Viewer 部分。这个 Colab 可以让你生成完整的 JAX/TensorBoard trace 并把玩它。
Trace Viewer(轨迹查看器)#
Trace Viewer 大概是 profiler 中最有用的部分。 下面的示例展示了一个简单的 Transformer,并对其各部分进行了标注。这些名字来自代码中提供的标签。
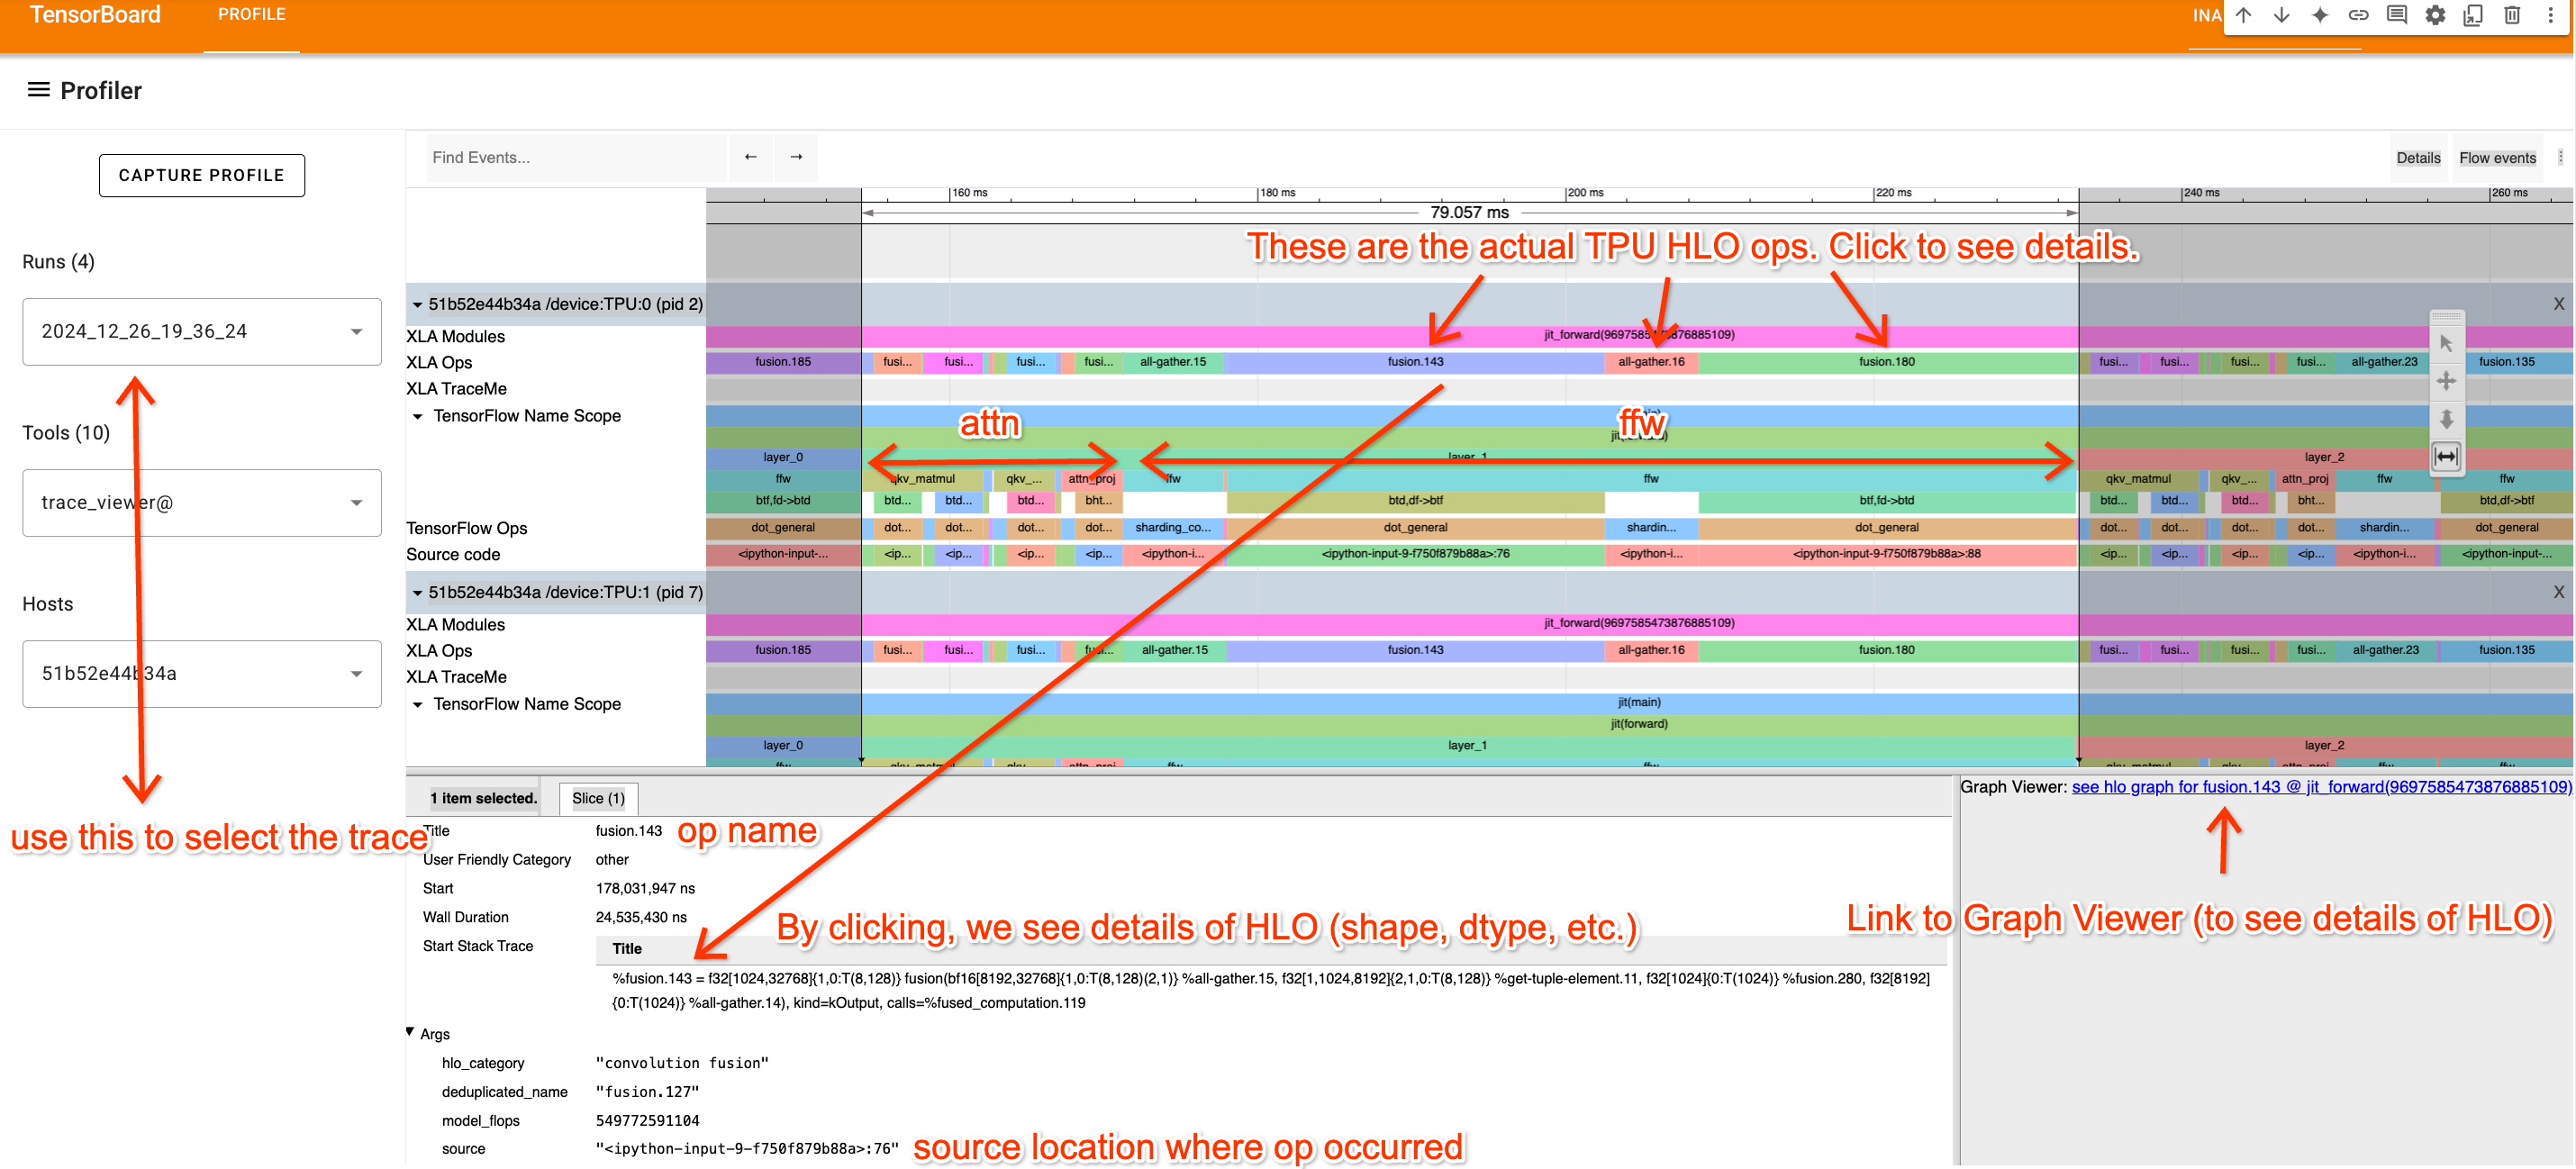
Trace Viewer 按时间顺序展示了每个 TPU core 上的所有动作。我们这里只看 TPU:0,因为通常所有 TPU 都执行相同的指令。几个关键点:
- 顶部一行(XLA Ops)显示真实的 TPU 操作(名字是 HLO 名)。其他所有内容都是基于
jax.named_scope、jax.named_call和 Python 调用栈的近似 trace。 - 注意那些重复的块,我们可以从中分离出一个单独的 layer。我们也可以(通过查看代码/理解 Transformer 工作方式)看出哪些部分是 attention,哪些是 MLP。
- 通过点击一个 XLA op,我们可以查看它来自代码的哪个位置(对于理解 trace 很有用),并看到指向 Graph viewer 的链接。
小贴士: 你可以用"游戏式"控制方式来浏览 Trace Viewer,A/D 左右平移,W/S 缩小放大。这些控制方式让浏览变得轻松得多。
如何阅读一个 XLA op#
HLO 其实并不难读,而且对于理解上面 trace 中某一部分对应什么非常有帮助。下面是一个名为 fusion.3 的示例 op。
%fusion.3 = bf16[32,32,4096]{2,1,0:T(8,128)(2,1)S(1)} fusion(bf16[32,32,8192]{2,1,0:T(8,128)(2,1)S(1)} %fusion.32), kind=kCustom, calls=%all-reduce-scatter.3让我们把它拆开来看。
- Op 名字(Op Name):fusion.3
- 一个 dot 或 fusion op 是一组操作,最多包含 1 次矩阵乘法,可能还有一些相关的 pointwise VPU 操作。
- 形状/布局(Shape/layout):
bf16[32,32,4096]- 这是 op 的输出形状。我们可以看到 dtype 是 bf16(每个参数 2 字节),
[32,32,4096]是形状。
- 这是 op 的输出形状。我们可以看到 dtype 是 bf16(每个参数 2 字节),
- 布局(Layout):
{2,1,0:T(8,128)(2,1)}{2,1,0:T(8,128)(2,1)}告诉我们各轴在内存中的顺序(列主序、行主序等)以及数组的填充。下面会详细说明。
- 内存位置(Memory location): S(1)
- S(1) 告诉我们这个数组存放在 VMEM 中。S(0)(有时被省略)是 HBM。S(2) 和 S(3) 是其他内存空间。
- 参数(Arguments):
bf16[32,32,8192]{2,1,0:T(8,128)(2,1)S(1)} %fusion.32- 这个 op 有一个输入,一个名为 fusion.32 的 bf16 数组,具有特定的形状。这告诉我们什么函数喂给了这个 op。
让我们更深入地理解一下这种记法。我们以这个为简单例子:
f32[3,5]{1,0:T(2,2)}
它再次告诉我们这个 op 返回一个形状为 [3, 5] 的 float32 数组,具有特定的 tiling(分块){1,0:T(2,2)}。虽然 tiling 没那么重要,但简单地说,tiling 告诉我们一个 N 维数组在内存中是如何顺序排布的。这里有一张图,展示了这个数组是如何排布的:
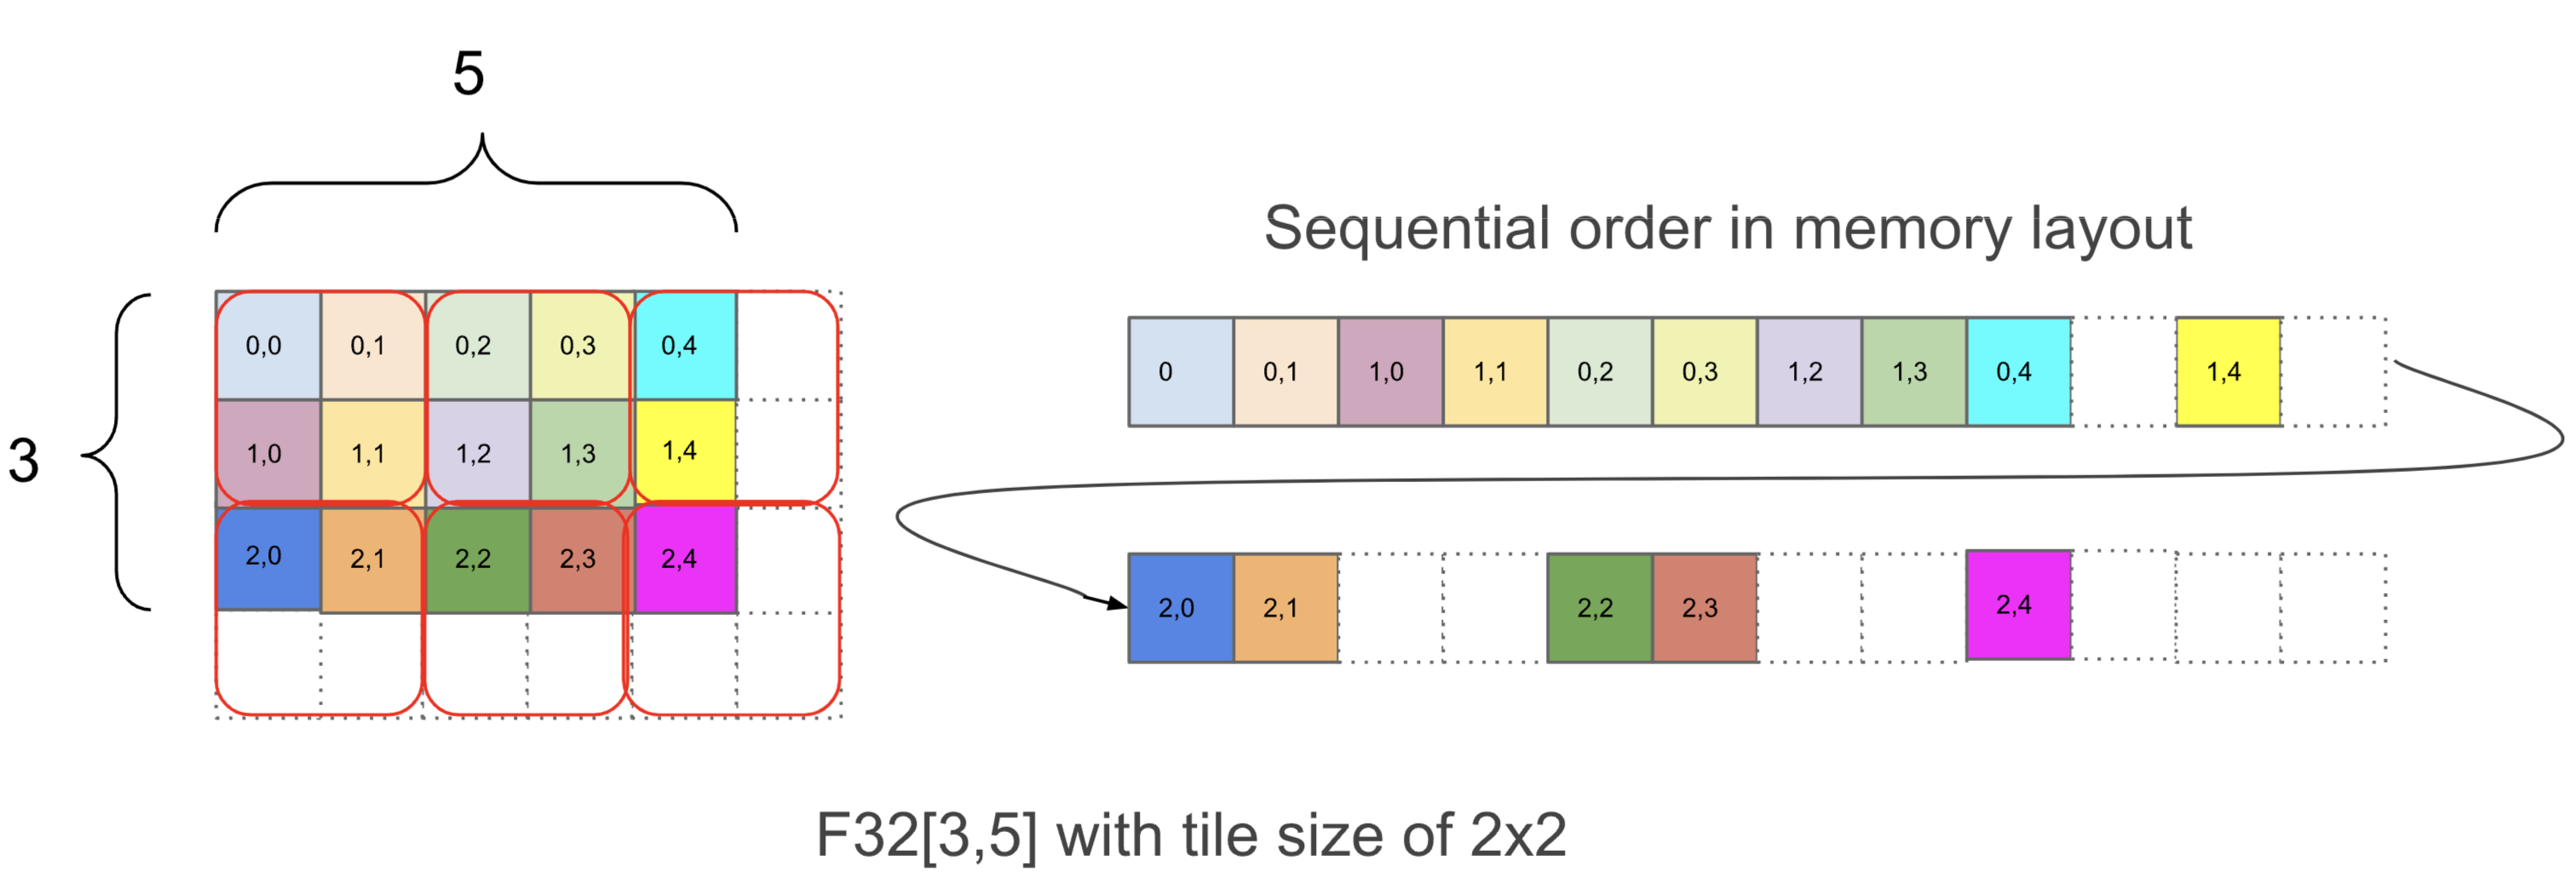
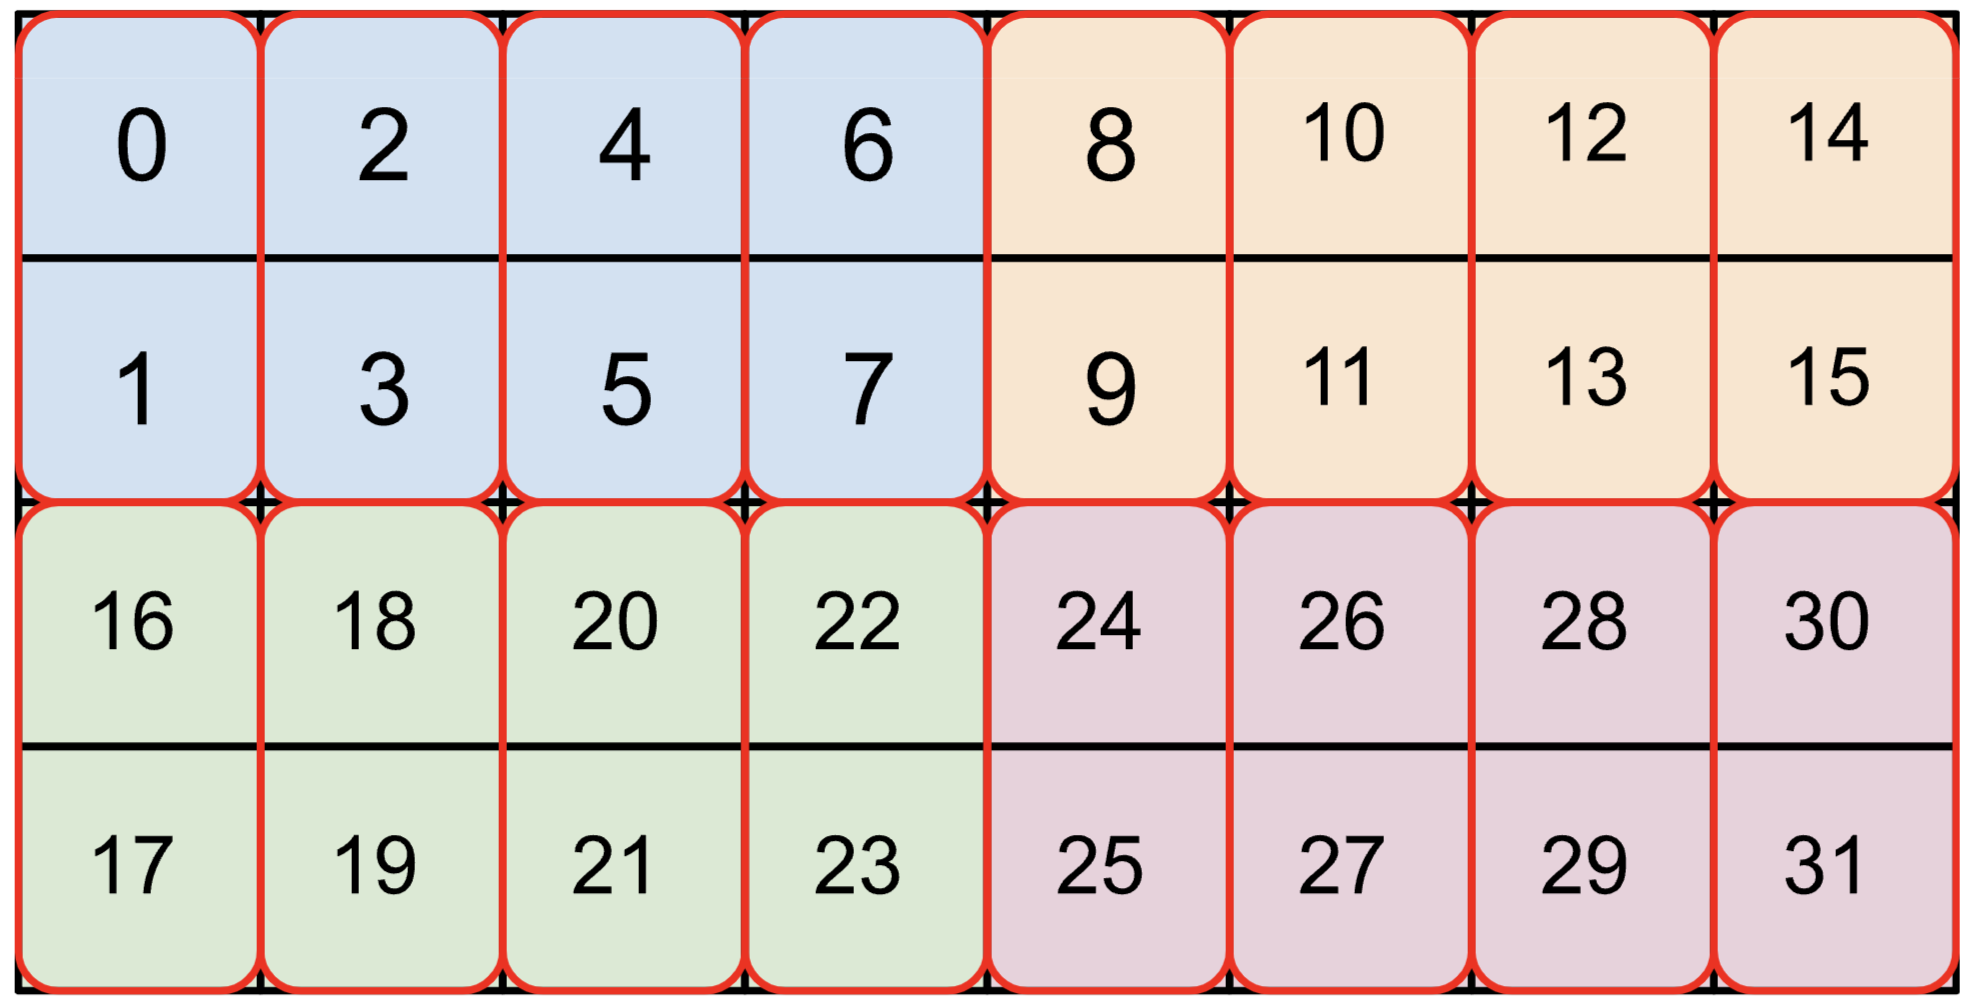
在 {1,0:T(2,2)} 中,1,0 部分告诉我们数组各维度在物理内存中的顺序,从最次(minor)到最主(major)。你可以从右往左读这部分,并在 f32[3,5] 中找到对应的维度,从而搞清楚数组的物理布局。在这个例子里,物理布局是 [3,5],与逻辑形状相同。之后,T(2,2) 告诉我们数组以 (2, 2) 的小块为单位进行分块,每个小块内部数组先按行(行主序)再按列排布,即 (0, 0) 后面跟着 (0, 1),然后是 (1, 0) 和 (1,1)。由于 T(2, 2) 的 tiling,数组被填充到 [4, 6],内存使用扩大了大约 1.6 倍。对于上面给出的那个大 bf16 数组 bf16[32,32,8192]{2,1,0:T(8,128)(2,1)S(1)},我们用 T(8,128)(2,1),它告诉我们这个数组有两层 tiling,外层是 (8, 128) 的 tiling,每个单元内部还有 (2, 1) 的 tiling(用于 bf16,使我们的 load 始终是 4 字节的倍数)。例如,下面是 bf16[4,8]{1,0:T(2,4)(2,1)}(颜色表示 (2,4) 块,红框表示 (2,1) 块):
Tiling 会影响张量的某些块加载到 VMEM 的效率,XLA 有时会在程序中插入 copy 操作来"重新分块"或"重新布局"一个张量,有时开销不可忽略。JAX 提供了一个实验性特性来解决这个问题,它允许 XLA 计算它对程序输入的"首选"布局。当你用 jax.jit 即时编译一个程序时,你通常会传入"模拟"输入,告诉 JAX 期望什么形状和 dtype。这些输入通常也带有 tiling 信息,但可能并不是最优的。你可以将输入布局指定为 AUTO,jax.jit 会返回 jit 后程序首选的布局。然后你可以显式地以该布局加载张量,从而避免在程序内部产生 copy。
Graph Viewer(图查看器)#
虽然上面的一些 fusion 看起来可能很复杂,但 XLA Graph Viewer 让它们更容易解析。例如,下面是一个相当复杂的 fusion 的视图:
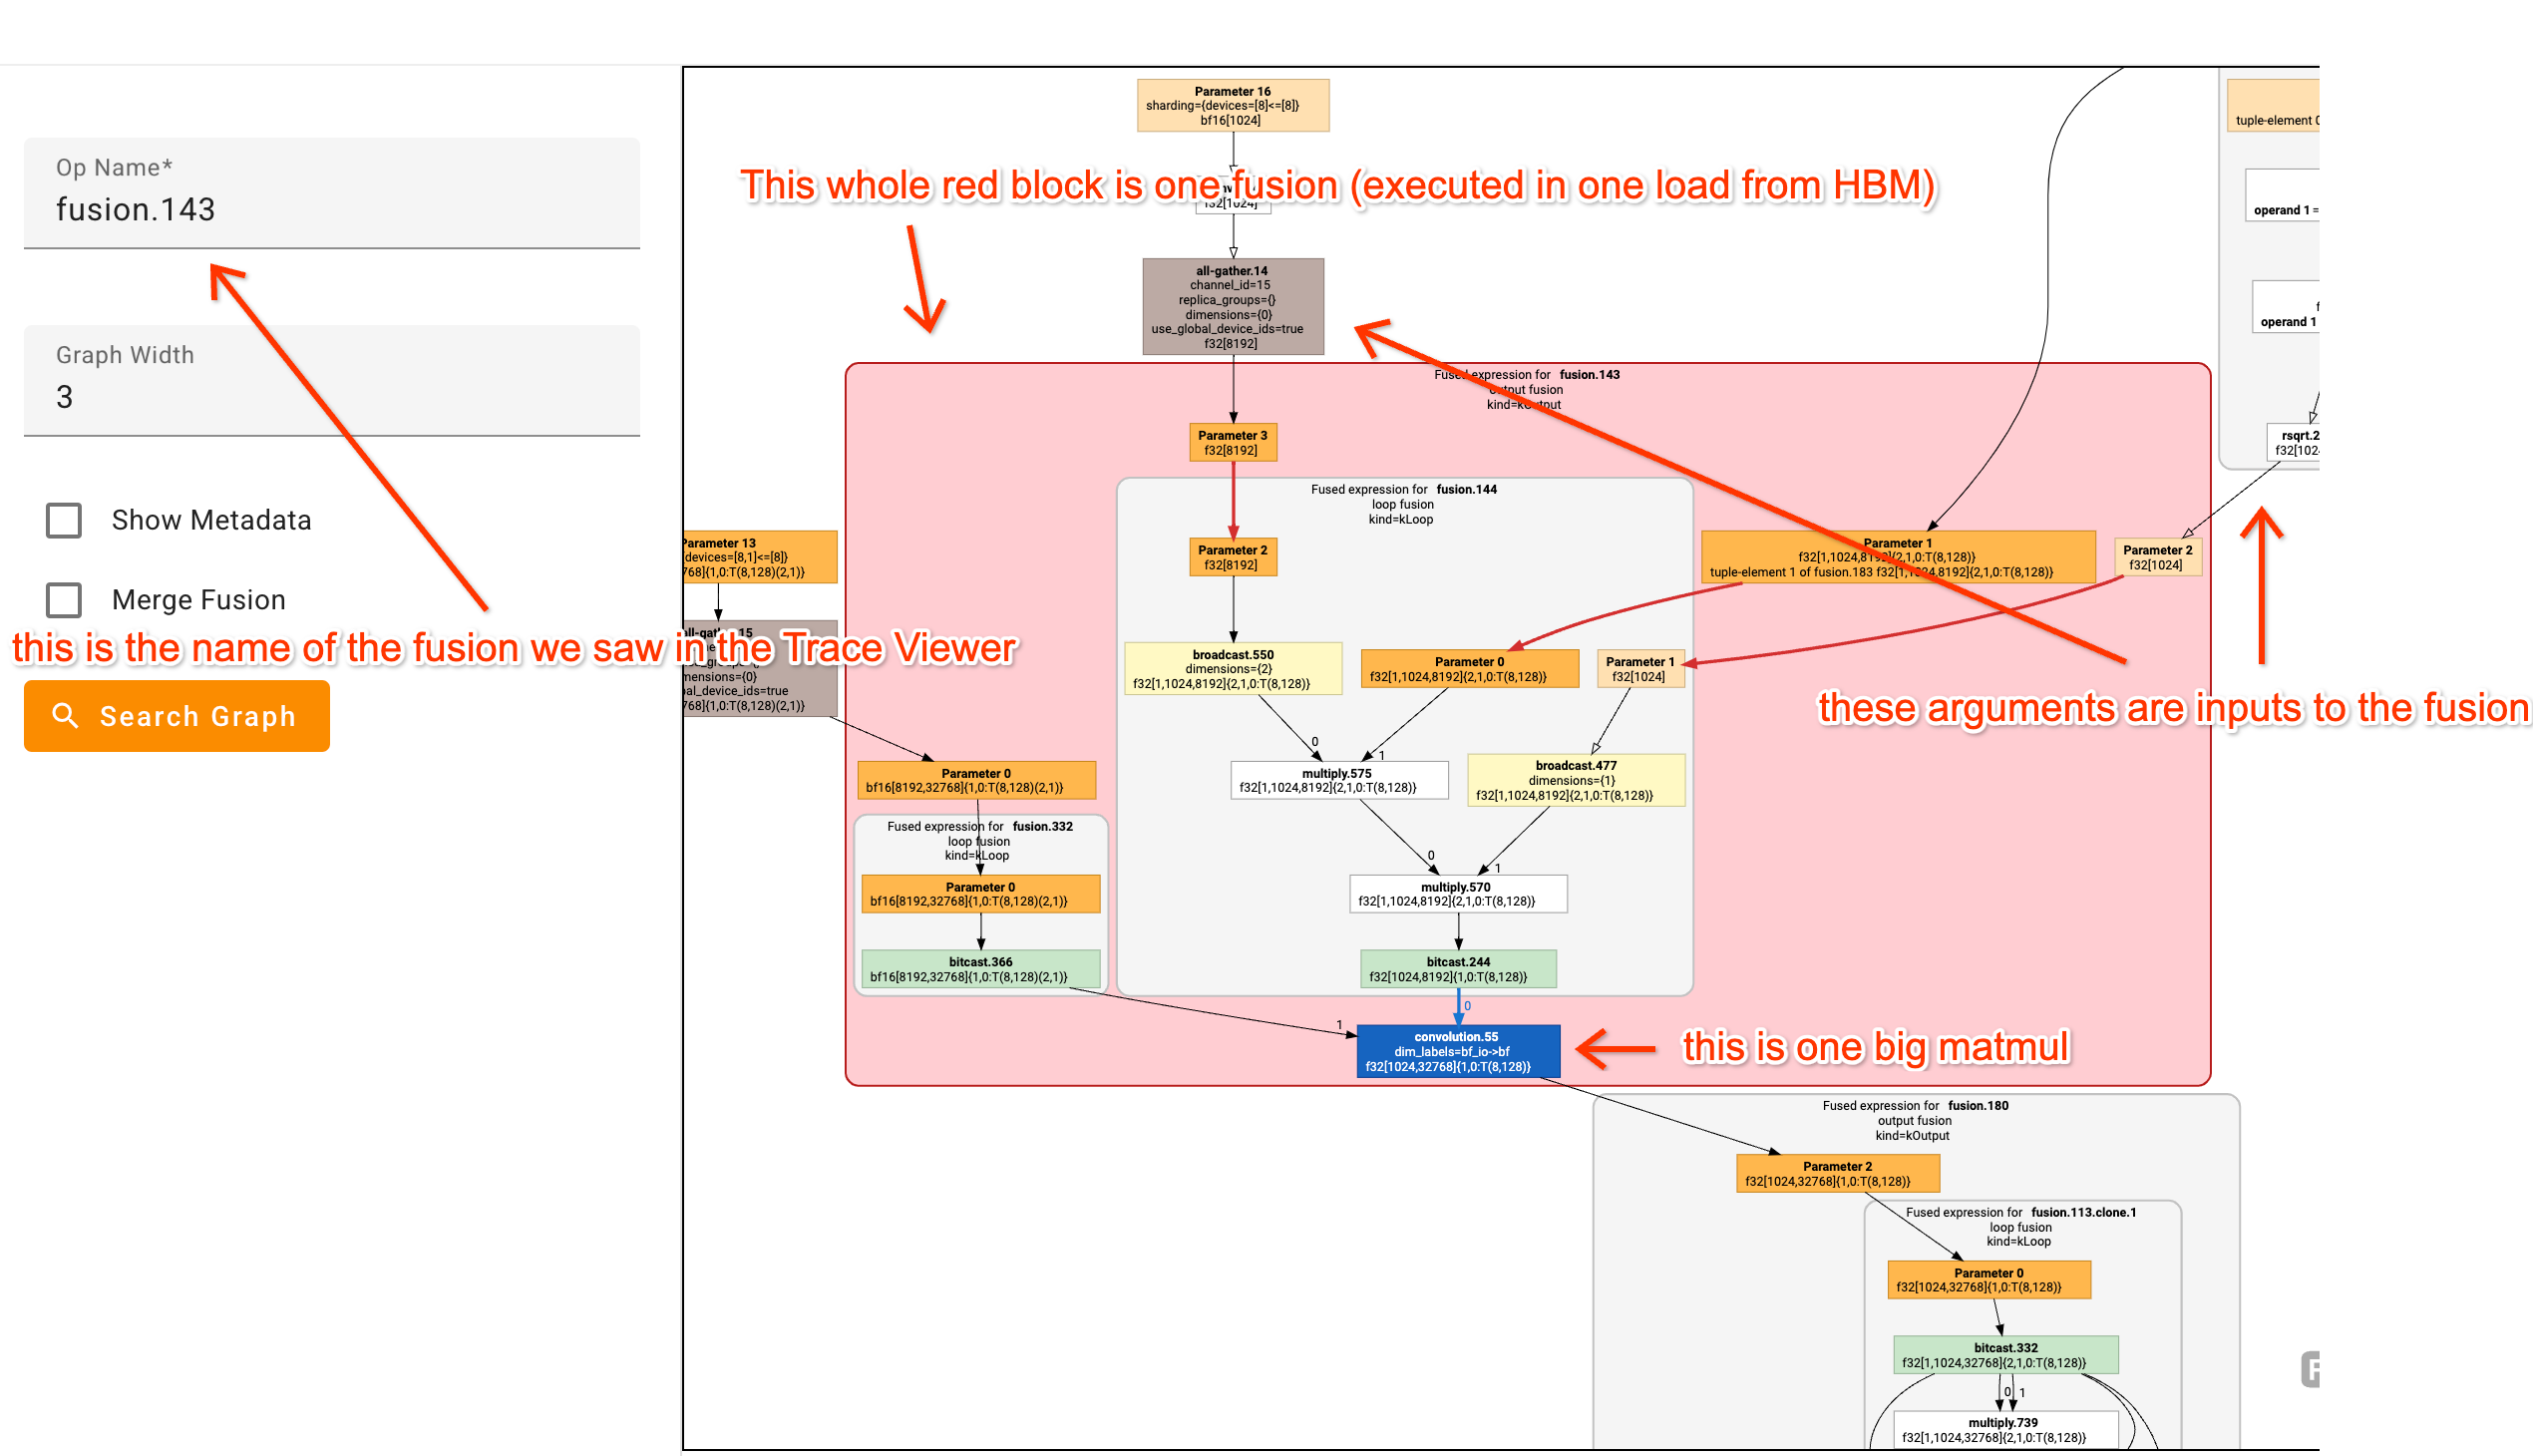
盯着一堆 HLO 图,并尝试把 HLO op 映射到你正在 profile 的代码上,是非常有帮助的。把鼠标悬停在某个框上,你通常会看到该函数定义所在的代码行。
看一个真实(一点)的示例 profile#
这个 Colab 包含了一个虚构 Transformer 的示例 profile。如果你时间紧迫,这里有一个 Perfetto 链接,至少能让你看到 Trace Viewer。我比平时花了更多功夫用 jax.named_scope 调用来标注这个 trace,这样你能识别出正在发生什么。
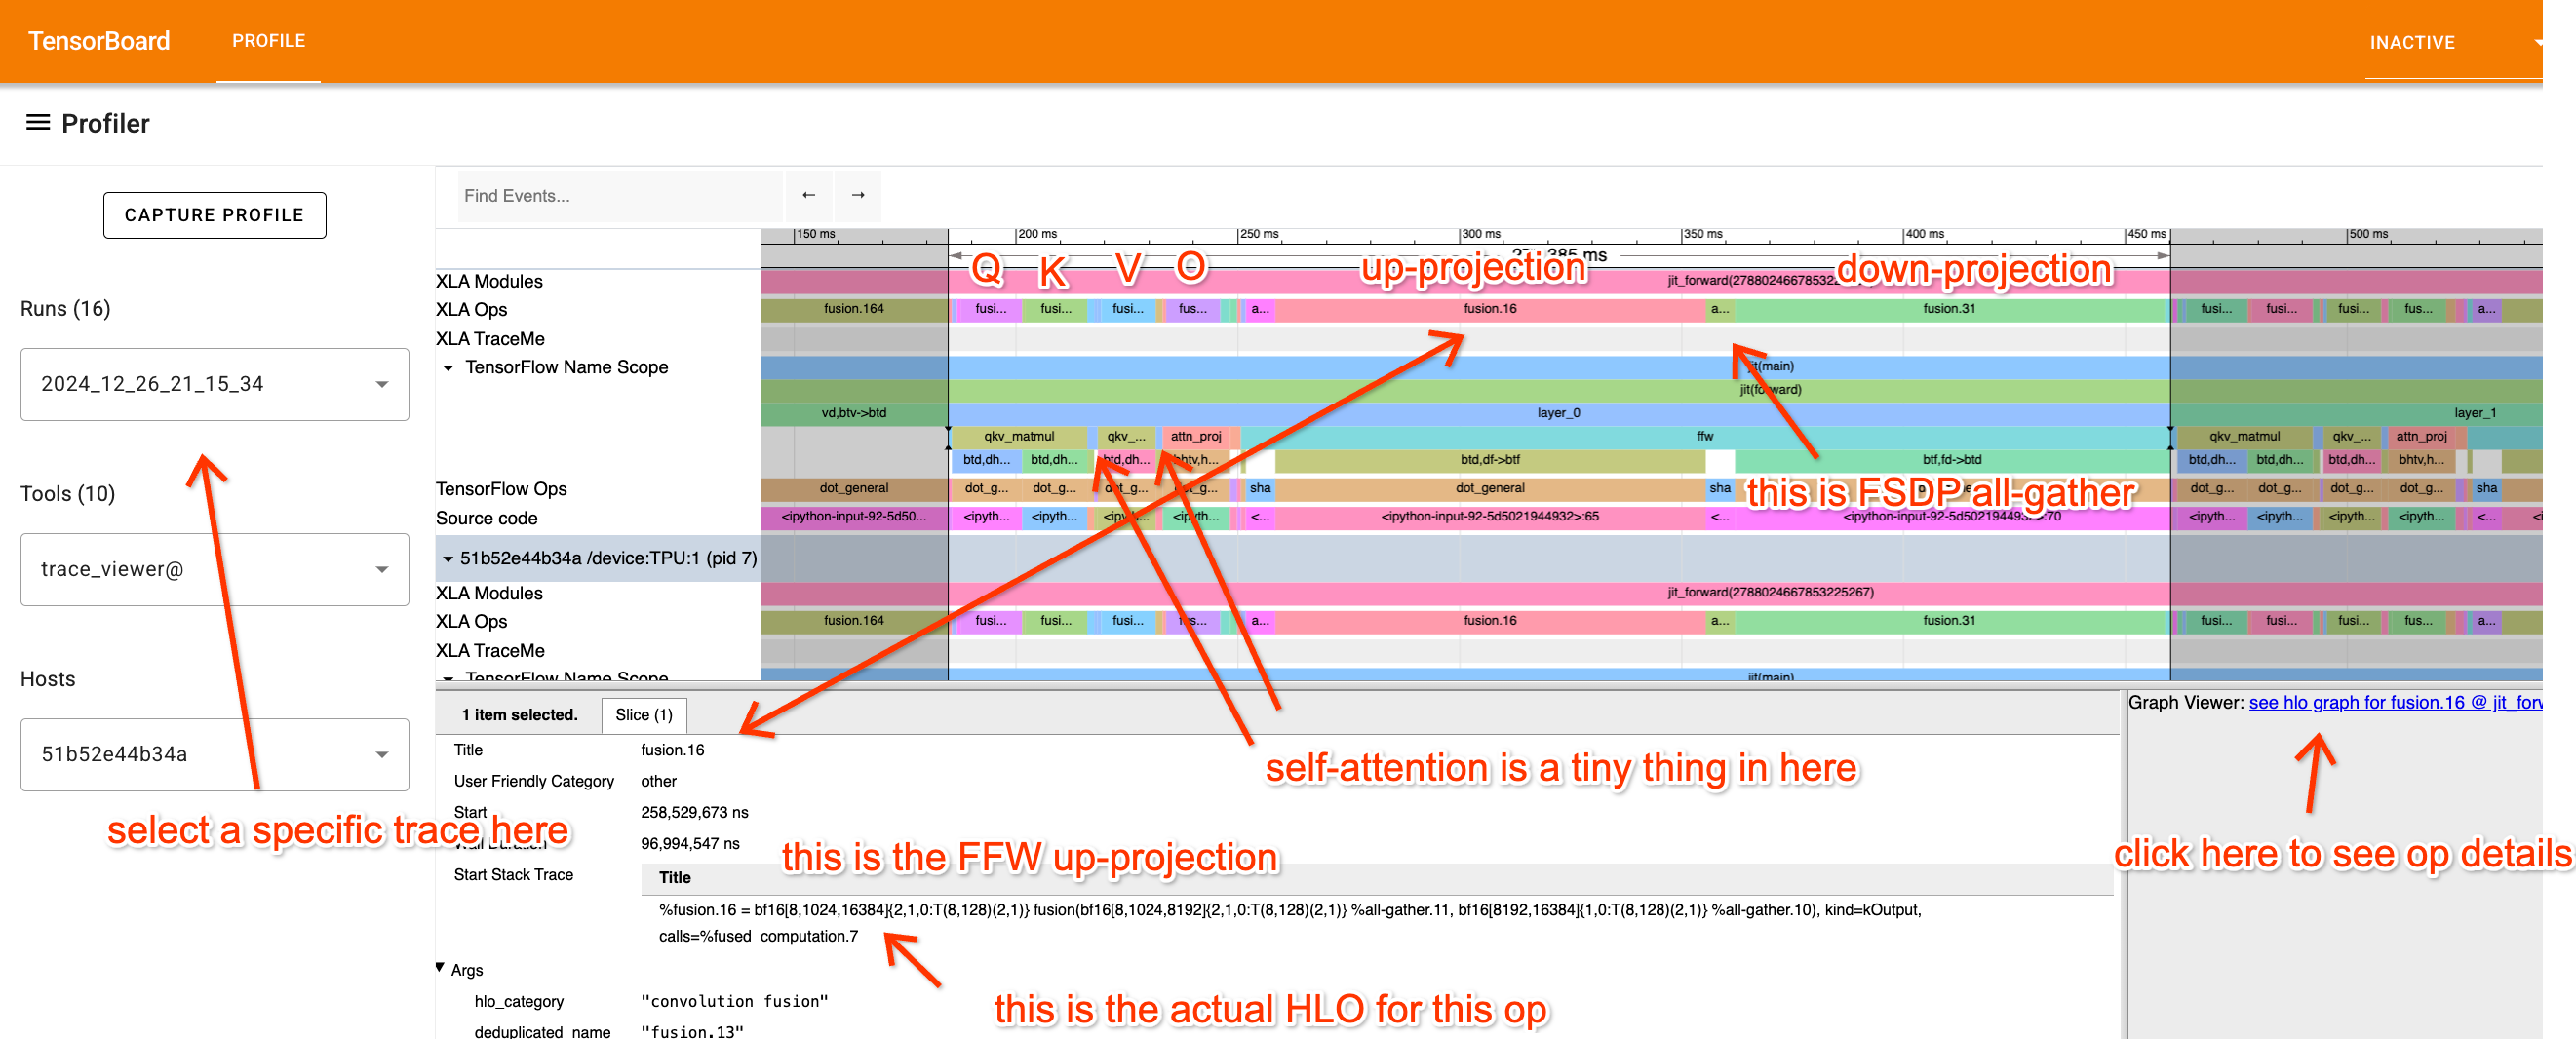
看一下这个 profile,并尝试真正理解每一部分在做什么。让我们稍微拆解一下,从 FFW 块开始:
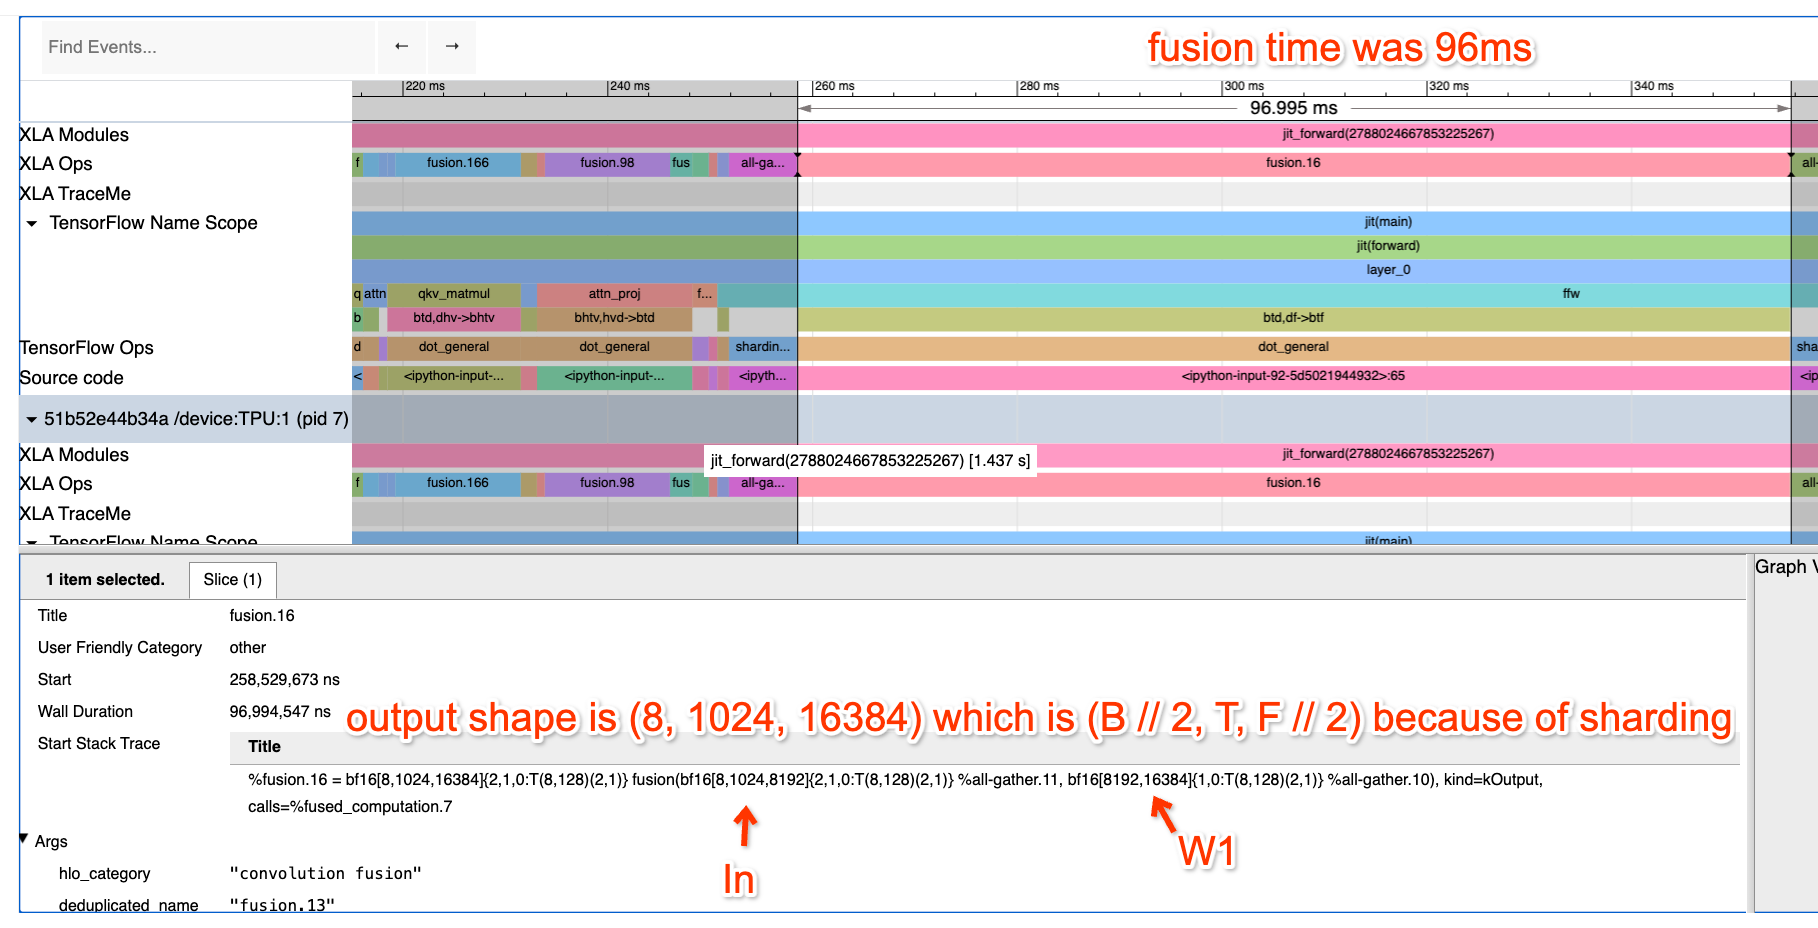
我们这里放大到了 FFW 块。你会看到 up-projection Op 是一个 fusion(matmul),输入为 bf16[8, 1024, 8192] 和 bf16[8192, 16384],输出为 bf16[8, 1024, 16384]。我知道(因为是我写的这段代码)这是一个 4-way DP、2-way MP 分片的 matmul 的本地视图,所以我们实际做的是
X: bf16[32, 1024, 8192] * Win:bf16[8192, 32768] -> Tmp:bf16[32, 1024, 32768]
我们期望它需要多长时间? 首先,每个数据并行 shard 上的 batch size 是 8 * 1024 = 8192,所以我们应该是稳稳的 compute-bound(计算受限)。这是在 8 个 TPUv2 core 上跑的(在 Google Colab 上免费可用),所以我们期望它大约需要 2 * 32 * 1024 * 8192 * 32768 / (23e12 * 8) = 95.6ms,这几乎正是它实际花费的时间(96ms)。太棒了!这意味着我们获得了非常出色的 FLOPs 利用率!
那通信呢? 你会注意到第二个 matmul 末尾隐藏的那个小 fusion。如果点开它,你会看到
%fusion.1 = bf16[8,1024,4096]{2,1,0:T(8,128)(2,1)} fusion(bf16[8,1024,8192]{2,1,0:T(8,128)(2,1)} %fusion.31), kind=kCustom, calls=%all-reduce-scatter.1这基本上是一个小的 ReduceScatter(这里是 Graph Viewer):
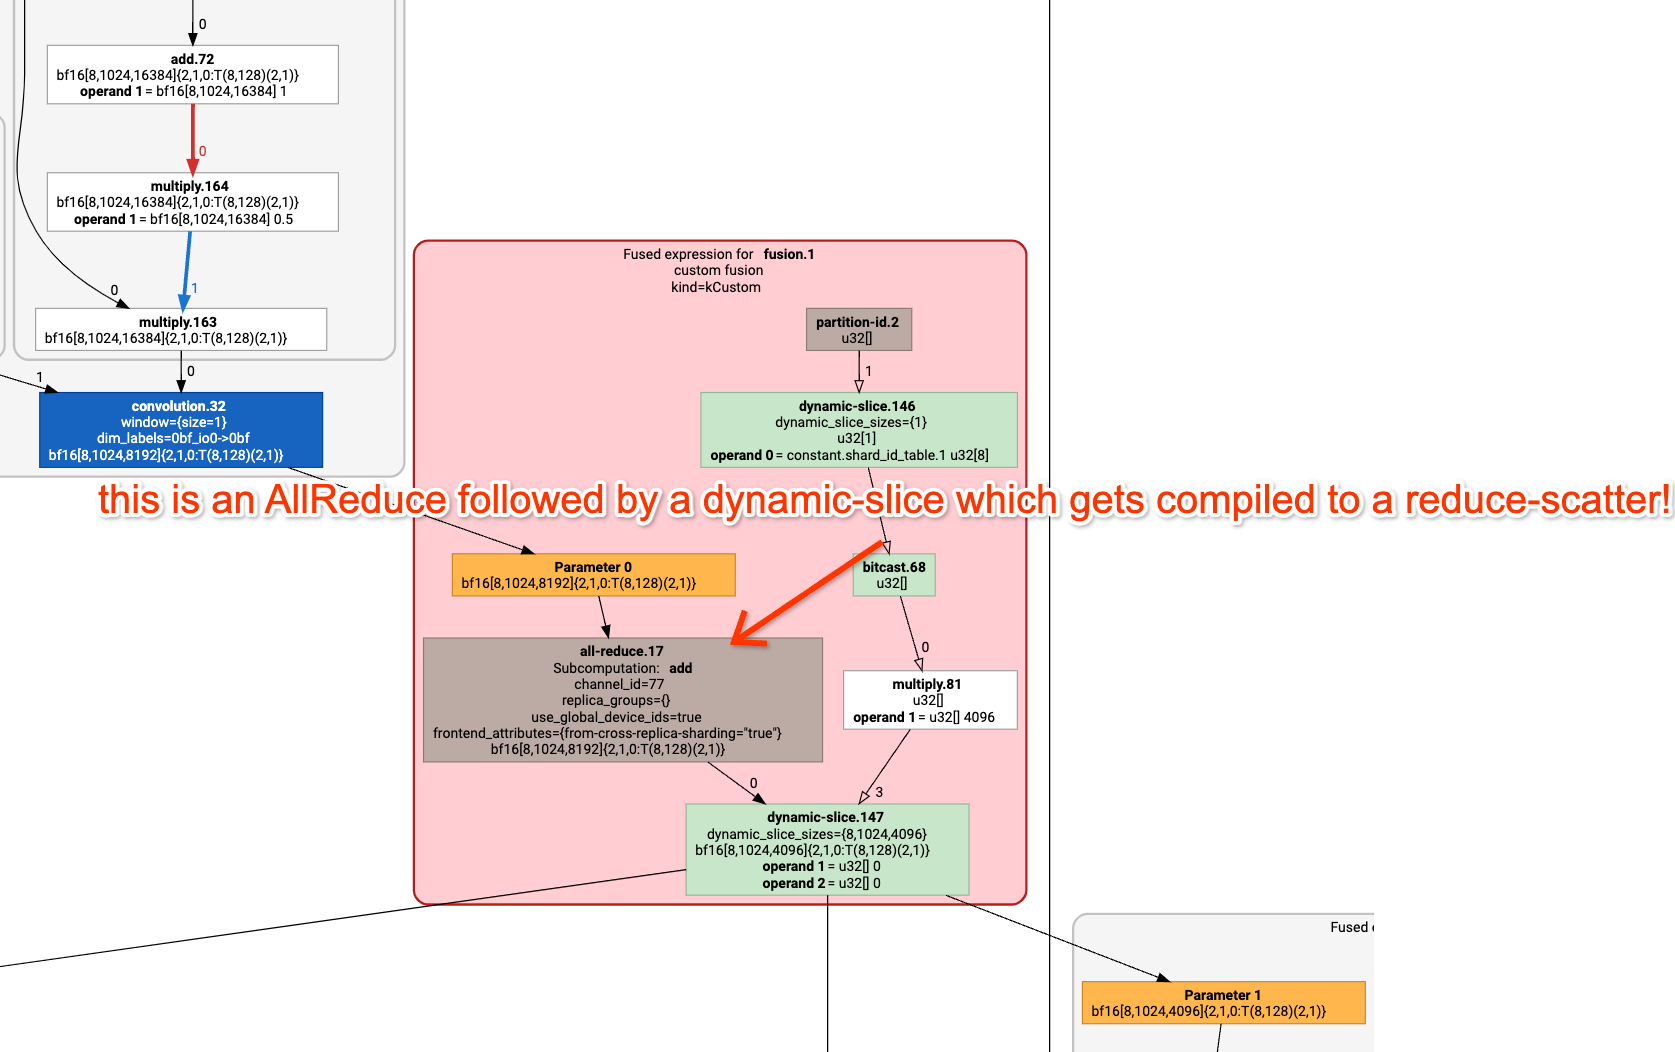
我们期望这需要多长时间?嗯,我们在 TPUv2 4x2 上做 ReduceScatter,应该只需要在 1.2e11 双向带宽上 hop 一次。数组大小是 2*32*1024*8192,batch 轴 4 路分片,所以每个 shard 是 2*8*1024*8192=128MB。所以这大约需要 1.1ms。实际花了多久? profile 中报告的是 1.13ms。所以我们非常接近 roofline!
让我们也看看 attention! 下面是 attention 部分的 profile:
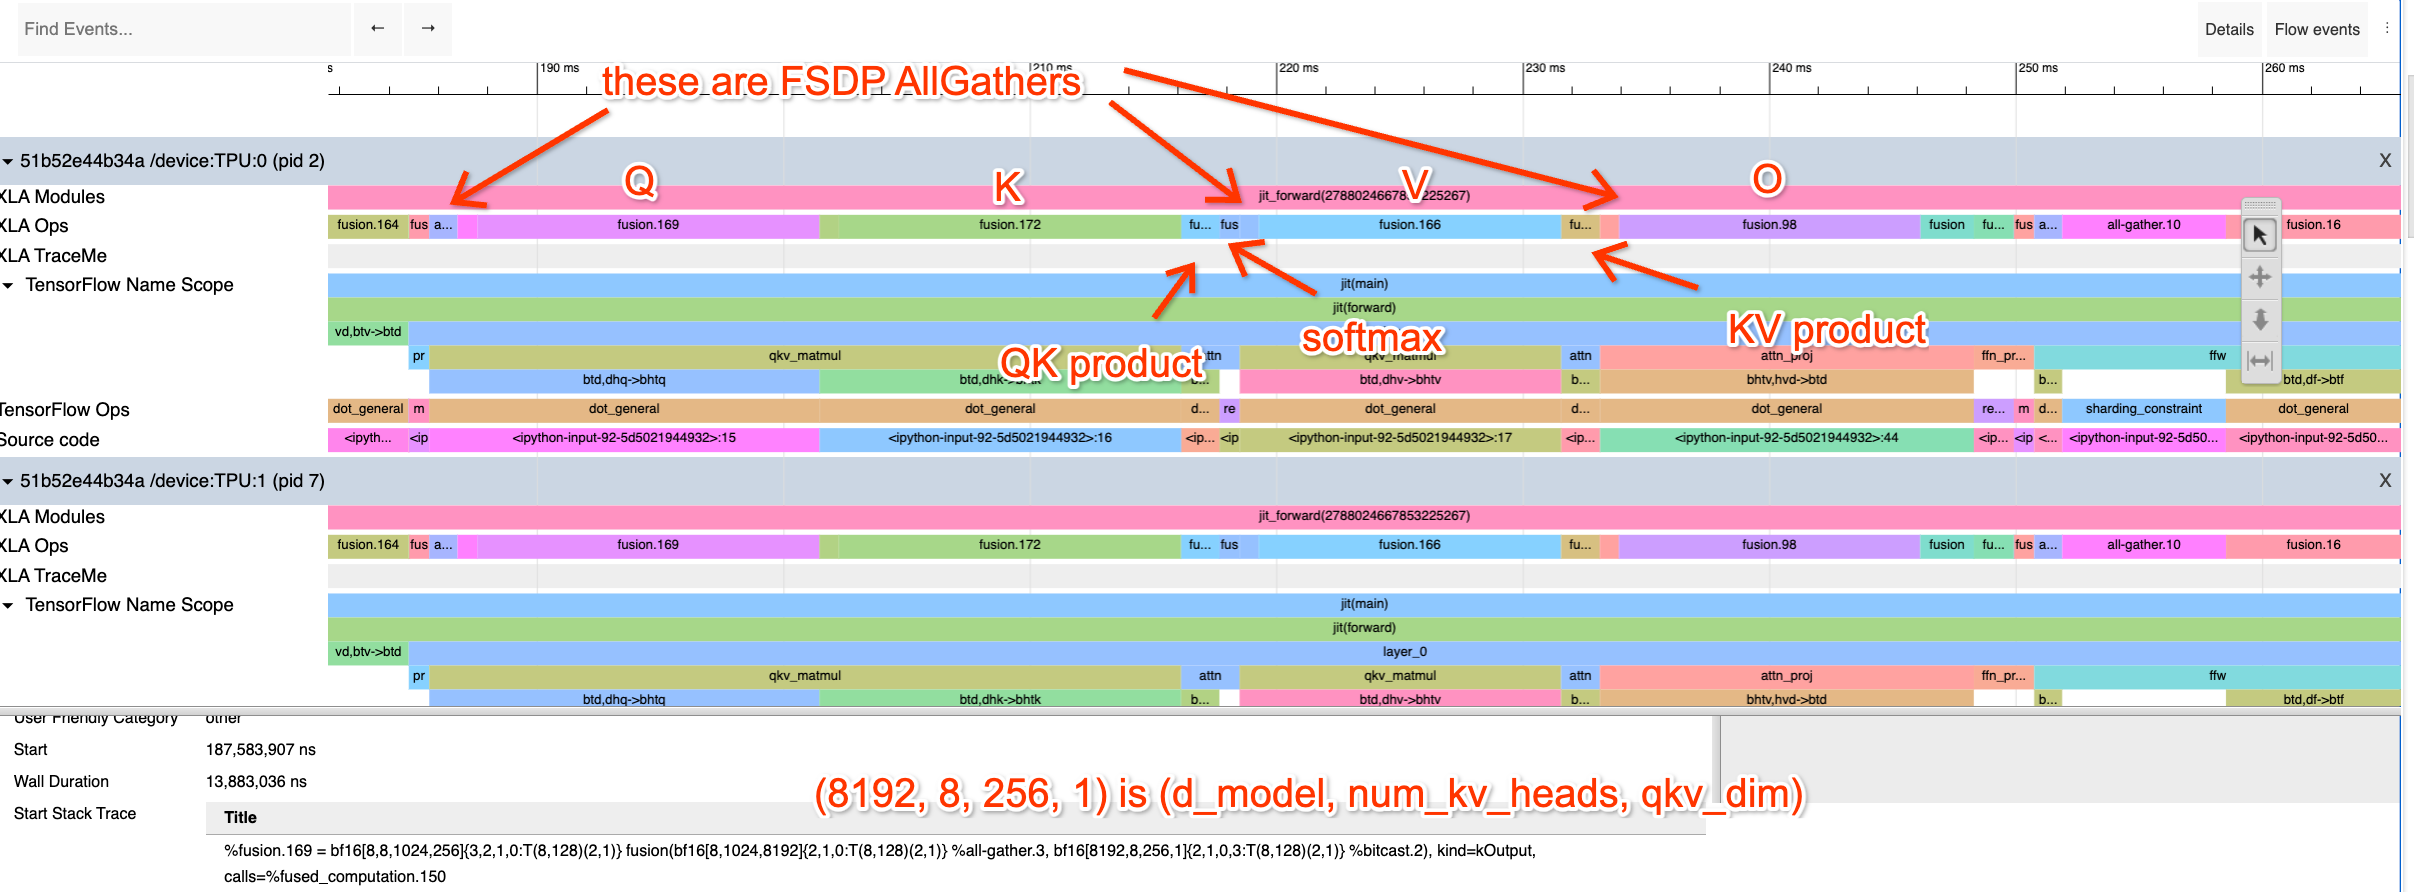
我点开了 Q projection op,它使用的矩阵 $W_Q$ 形状为 [dmodel = 8192, nheads = 32, dqkv = 256]。我们沿着 head 维度做 Megatron 分片。试着做同样的练习,计算这些应该需要多长时间。
Memory Profile(内存分析)#
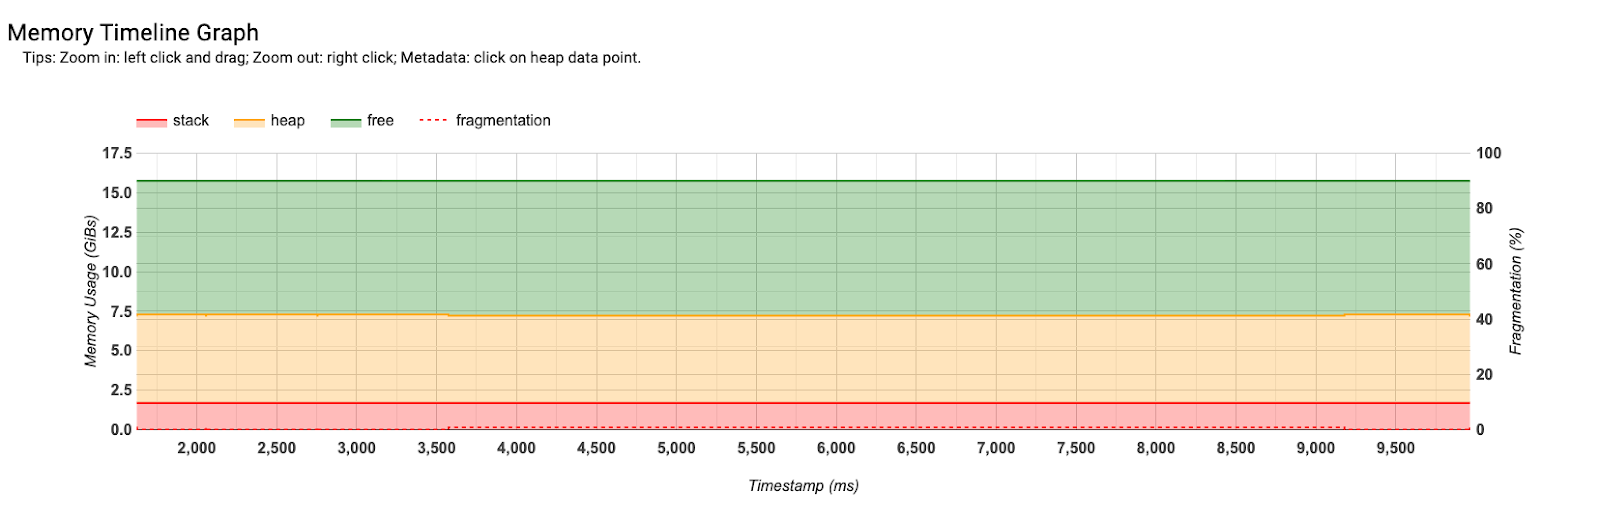
Memory Profile 让你很容易看到程序内存随时间的变化。这对调试 OOM(内存溢出)非常有帮助。你可以在这里看到大约 7.5GB 分配给了模型参数,大约还有 10GB 空闲。所以我们还能装下更多东西到内存里。
实战练习#
问题 1:看一下这个 Colab/profile,弄清楚什么看起来可疑,以及这里到底发生了什么。你能告诉我究竟在进行什么计算,每个操作在做什么吗?涉及的每个矩阵的真实形状是什么,它们是如何分片的?先不要看代码,试着只看 profile。
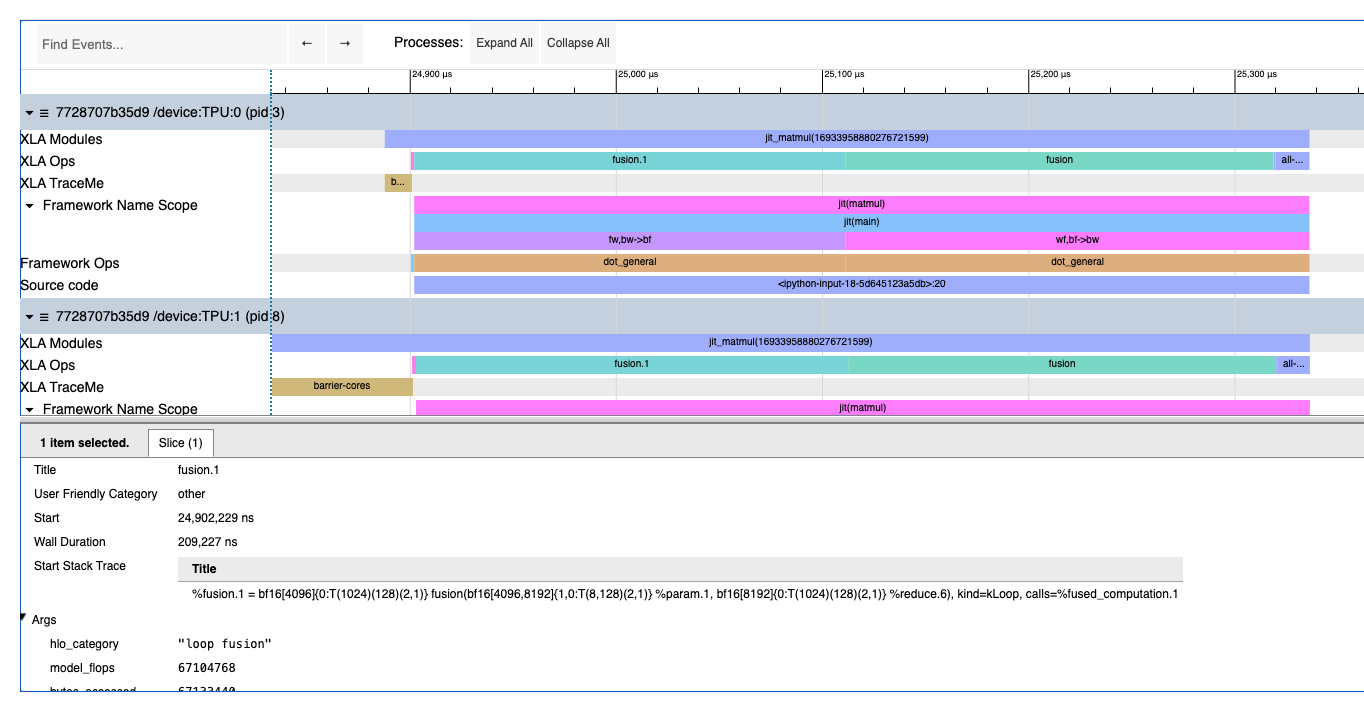
点击这里查看答案。
这是两次矩阵乘法,具体地说是这样:
def matmul(w1, w2, x):
  return jnp.einsum('wf,bf->bw', w2, jnp.einsum('fw,bw->bf', w1, x))
你可以看到一个 reduce、两个大 fusion 和一个 all-reduce。第一个大 fusion 是:
%fusion.1 = bf16[4096]{0:T(1024)(128)(2,1)} fusion(bf16[4096,8192]{1,0:T(8,128)(2,1)} %param.1, bf16[8192]{0:T(1024)(128)(2,1)} %reduce.6), kind=kLoop, calls=%fused_computation.1
它告诉我们每个 shard 的形状是 bf16[8192] * bf16[4096, 8192] -> bf16[4096](沿 8192 维做收缩)。通过观察最后的 AllReduce,其 replica_groups=\{\{0,16,32,48,64,80,96,112\}, ...\},我们可以判断这是 8-way 模型并行,因此真实形状是 [8, 8192] * bf16[32768, 8192] -> bf16[8, 32768]。
问题 2: 前面提到的 Transformer Colab 实现了一个简单的虚构 Transformer。按照 Colab 中的说明,对使用 GSPMD 分区的朴素 Transformer 进行 benchmark。每个部分需要多长时间?应该需要多长时间?正在使用哪种 sharding?尝试修复 sharding!提示:使用 jax.lax.with_sharding_constraint 来约束行为。修复后,你能得到的最好的 MXU 是多少?
作为参考,初始版本大约每层 184ms,优化后的 profile 是每层 67ms。完成这些之后,盯着 profile 看一看,试着只从 profile 回答这些问题:
- 这是什么 sharding 策略?
- batch size、$d_\text{model}$、$d_\text{ff}$ 分别是多少?
- attention 与 MLP 块各占多少时间?
- 在 roofline 下,每个 op 应该占多少时间?
注意: 自从这个问题写出来以后,XLA 编译器变得更好了。初始版本现在大约每层 90ms,优化后的 profile 也只快了大约每层 10ms(80ms / layer)。不过仍然值得把玩一下,看看你能不能做得更好。
第 9 部分到此结束。第 10 部分将深入探讨 JAX 并行,点击这里查看。
杂项#
*在 Google DeepMind 完成的工作,现就职于 MatX。
引用#
在学术场景下进行引用,请将本工作引用为:
Austin et al., "How to Scale Your Model", Google DeepMind, online, 2025.或作为 BibTeX 条目:
@article{scaling-book,
  title = {How to Scale Your Model},
  author = {Austin, Jacob and Douglas, Sholto and Frostig, Roy and Levskaya, Anselm and Chen, Charlie and Vikram, Sharad
  and Lebron, Federico and Choy, Peter and Ramasesh, Vinay and Webson, Albert and Pope, Reiner},
  publisher = {Google DeepMind},
  howpublished = {Online},
  note = {Retrieved from https://jax-ml.github.io/scaling-book/},
  year = {2025}
}