Transformer 推理全解(All About Transformer Inference)#
《How To Scale Your Model》第 7 部分(第 6 部分:Training LLaMA | 第 8 部分:Serving LLaMA)
在 Transformer 上做推理与训练有很大不同。部分原因在于推理引入了一个新的考量因素:延迟(latency)。本节我们将从对模型采样一个新 token 开始,一直讲到如何把一个大型 Transformer 高效地扩展到多片加速器上,作为推理引擎的一部分。
目录
Transformer 推理基础#
你已经训练好了一个 Transformer,想用它生成新的序列。说到底,benchmark 分数上升、loss 曲线下降都只是代理指标,真正能不能产生有趣的东西,要看实际部署后的表现!
采样的概念其实很简单。我们把一段序列输入进去,Transformer 会输出 $\log p(\text{next token}_i \vert \text{previous tokens})$,也就是所有可能下一个 token 的对数概率。从这个分布中采样就得到一个新 token。把它追加到末尾,重复这个过程,就得到一个延续 prompt 的 token 序列。
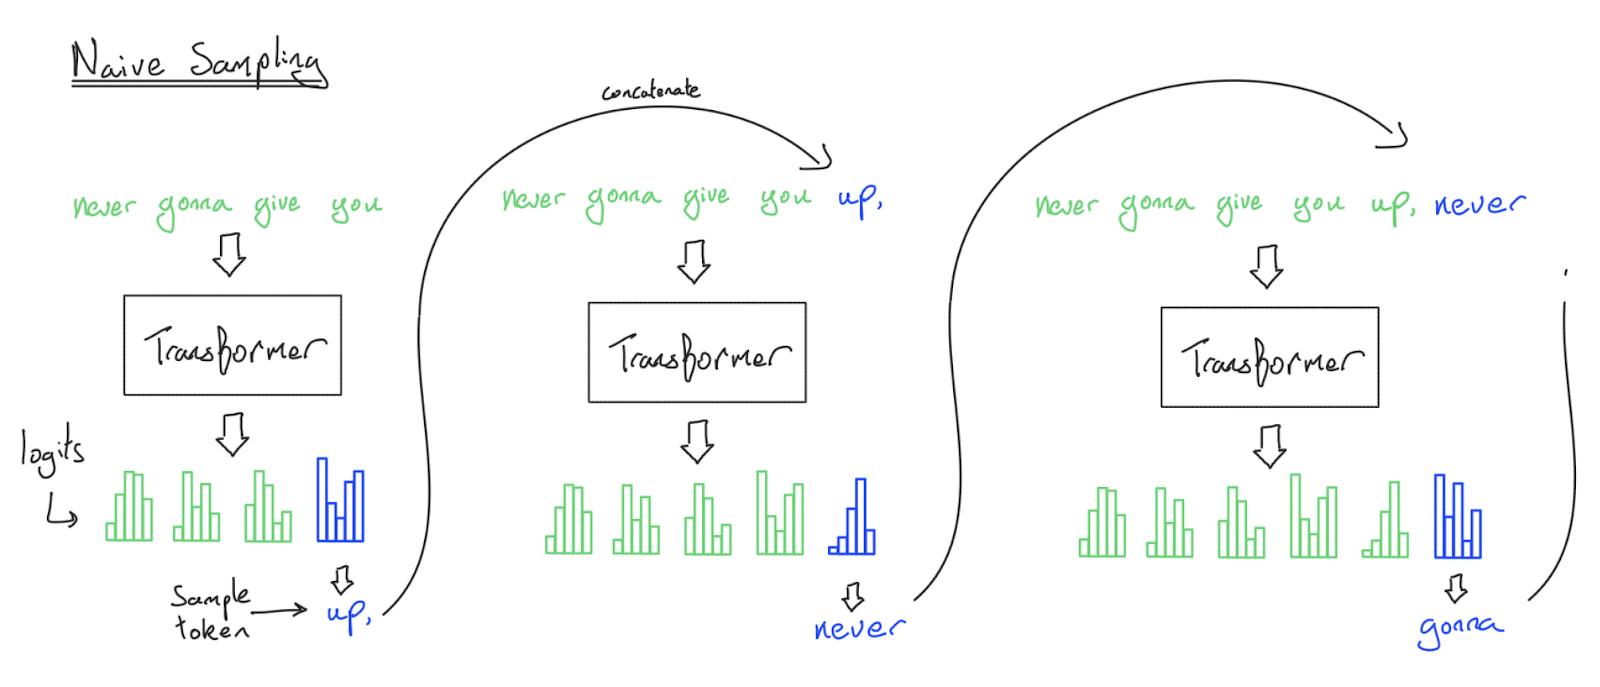
图: 朴素的 Transformer 采样。蓝色的 logits 给出下一个 token 的分布,我们可以从中采样。注意每一步都要重新处理整个前缀,导致整体算法的运行时间是 $\Theta(n^2)$。
刚才描述的就是 Transformer 采样的朴素实现,虽然能用,但实际中我们从不这样做,因为每生成一个 token 就要重新处理整个序列。这个算法生成 $n$ 个 token,FFW 上是 $O(n^2)$,注意力上是 $O(n^3)$!
怎么避免? 与其每次都做完整的前向传递,我们可以保存每次前向中的一些中间激活值,避免重复处理之前的 token。具体地说,由于在点积注意力中,一个 token 只关注它之前的 token,我们可以把每个 token 的 key 和 value 投影写到一个新的数据结构里,称为 KV cache。一旦把过去 token 的 key/value 投影保存下来,未来的 token 只需要计算 $q_i \cdot k_j$ 内积,无需再对早先的 token 做新的 FLOPs。妙!
基于此,推理可以分为两个关键阶段:
- Prefill(预填充):给定一段较长的 prompt,我们一次性处理所有 prompt 中的 token,把得到的激活值(具体来说是 key-value 投影)保存进 “KV cache”。同时保存最后一个 token 的 logits。
- Generation(生成):给定 KV cache 和上一步的 logits,我们从 logits 中增量采样一个 token,把这个 token 喂回 Transformer,产生下一步的新 logits。同时把这个新 token 的 KV 激活值追加到 KV cache。重复直到遇到特殊的
<EOS>token 或达到最大长度限制。
下面是带 KV cache 的采样图示:
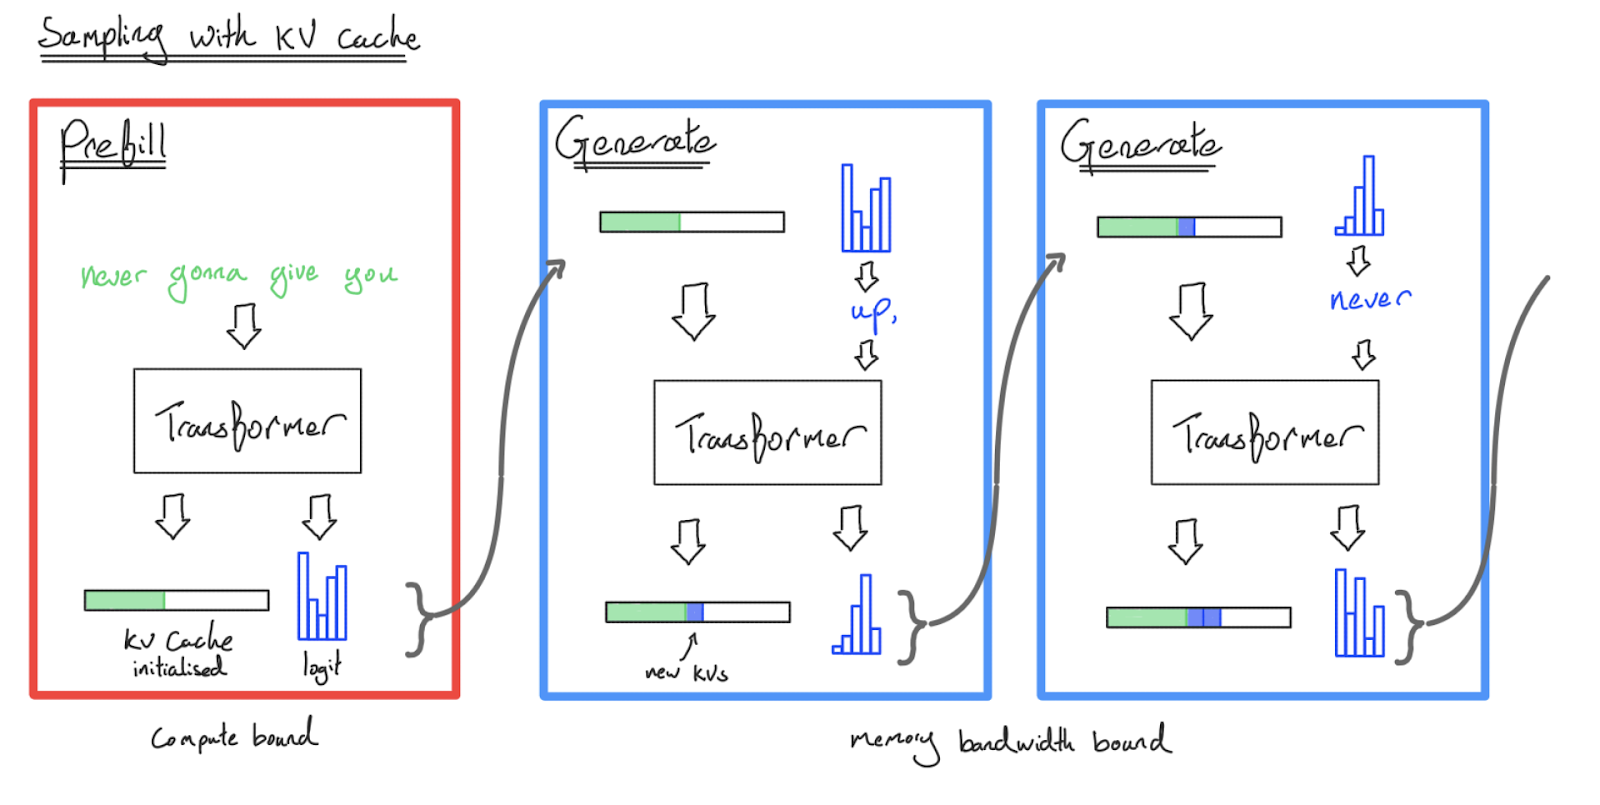
图: 使用 KV cache 的高效 Transformer 采样示意图。Prefill 处理 prompt 并把每个 token 的 key-value 激活值保存进 cache。Generation 取这个 cache(和最后一个 token 的 logits),采样一个新 token,把它过一遍模型,关注 KV cache 并把新 token 的 key-value 投影写回 cache。这在 MLP 块中是 $O(n)$ 算法。
通过带 KV cache 的采样,我们把生成 $n$ 个 token 的时间复杂度降到了 FFW 上的 $O(n)$ 和注意力上的 $O(n^2)$,因为我们再也不会重新处理之前的 token。但生成一个序列仍需要很多次前向传递——这就是你查询 Gemini 或 ChatGPT 时结果流式返回时正在发生的事。每个 token(通常)都是一次独立的(但部分被 cache 的)大模型 Transformer 调用。
我们很快就会看到,prefill 和 generation 是两个性质截然不同的"野兽"——Transformer 推理其实是两个伪装在一起的任务!相比训练,KV cache 也是一个新出现且影响重大的复杂性来源。
我们到底想优化什么?#
在继续之前,有必要强调推理中一个全新的方面:延迟。训练时我们只关心吞吐(每秒每芯片处理的总 token 数),但推理时我们必须关心 token 产生的速度(既包括首 token 时间(Time To First Token,TTFT),也包括每 token 延迟)。例如:
- 离线批量推理用于评测和数据生成时,只关心推理的总成本,对单条样本的延迟不敏感。
- 聊天界面/流式任务需要在大规模下低成本运行,同时具备低 TTFT 并以快于人类阅读速度生成 token。
- 边缘推理(例如笔记本上跑
llama.cpp)一次只服务一个用户,追求最低延迟,可能伴有严格的硬件约束。
最大化硬件利用率仍然至关重要,对成本和 TTFT 都有帮助;但与训练不同,它不一定_必然_意味着对单个用户的更好体验。在加速器、系统和模型架构层面有许多优化都需要在延迟、吞吐、上下文长度甚至模型质量之间做取舍。
更细粒度地看 Transformer#
到目前为止我们大多把 Transformer 当作一堆前馈块来对待。从 FLOPs 和内存的角度看这通常没问题,但用来精确建模推理就不够了。如 Part 4 所述,Transformer 前向传递的主要组成部分是:
- 一堆线性运算,包括 MLP($W_{in}$、$W_{out}$)和注意力的 QKV 投影、输出投影($W_Q$、$W_K$、$W_V$、$W_O$)。它们都涉及从 HBM 读取参数和一批激活,做一些 FLOPs,把结果写回 HBM。
- 点积注意力。我们需要从 HBM 读一批 key-value 投影和一批 query 激活,做一些内积和 softmax,然后把注意力结果写回 HBM。
- 其他一切,包括应用 layer norm、激活函数、token 采样、更新 KV cache、位置编码等。它们也消耗一些 FLOPs,但被前两部分主导,或被融合进去。
接下来几节,我们会分别在 prefill 和 generation 的语境下审视这些操作,看看可能成为性能瓶颈的是什么。在单张加速器内部,我们是 compute-bound 还是 memory-bound?我们想强调 prefill 和 generation 的答案有多么不同。
线性运算:瓶颈在哪?#
我们所有的线性运算在概念上都是相同的,无论它们在 MLP 块中还是在注意力中。它们的算术强度依赖 batch size。来看一次单一的矩阵乘:$\text{bf16[B, D]}$ 的 batch 乘以 $\text{bf16[D, F]}$ 的矩阵。要做这次 matmul,我们需要把这两个数组从 HBM 加载到 MXU 中,做乘法,然后把结果写回 HBM。和之前一样:
$$T_\text{math} = \frac{\text{Computation FLOPs}}{\text{Accelerator FLOPs/s}} = \frac{2BDF}{\text{Accelerator FLOPs/s}}$$$$T_\text{comms} = \frac{\text{Communication Bytes}}{\text{Bandwidth Bytes/s}} = \frac{2BD + 2FD + 2BF}{\text{Bandwidth Bytes/s}}$$TPU 或 GPU 可以一边加载一边计算,所以要 compute-bound 我们需要 $T_\text{math} \geq T_\text{comms}$,即:
$$\frac{2BDF}{2BD + 2DF + 2BF} \geq \frac{\text{Accelerator FLOPs/s}}{\text{Bandwidth Bytes/s}} \underset{\text{TPU v5e}}{=} \frac{1.97E+14}{8.20E+11} = 240$$右边是硬件的算术强度。现在假设 $D$ 和 $F$ 远大于 $B$(通常 batch 最多 500 而 $D$ 和 $F > 10k$),分母可以用 $\small{2BD + 2DF + 2BF \approx 2DF}$ 简化,得到:
$$\begin{align*} \frac{2BDF}{2BD + 2DF + 2BF} \approx \frac{2BDF}{2DF} \geq \frac{\text{Accelerator FLOPs/s}}{\text{Bandwidth Bytes/s}} \\ \underset{\text{TPU v5e}}{=} \frac{1.97E+14}{8.20E+11} \implies B \geq 240 = B_{\text{crit}} \end{align*}$$如果我们对权重做量化或用更低精度做 FLOPs,这个临界 batch size 会变。例如把权重量化到 int8 或 fp8,$B_\text{crit}$ 减半。如果 FLOPs 是用 int8 或 fp8 算,$B_\text{crit}$ 会翻倍。所以若令 $\beta = \text{bits per param} / \text{bits per activation}$ 且 $\alpha_\text{hbm} = C / W_\text{hbm}$,临界 batch size 实际上是 $B_\text{crit} = \beta \alpha_\text{hbm}$。
要点: Transformer matmul 是 compute-bound 的_当且仅当_每副本的 token batch size 大于 $B_\text{crit} = C / W_\text{hbm} \cdot (\text{bits per param} / \text{bits per activation}) = \beta \cdot \alpha_\text{hbm}$。对 TPU v5e 上的 bf16 激活,这是 240 个 token;对 H100 大约是 280 个 token。
训练期间,由于我们在很大的 batch 上重用同一组权重,所有矩阵乘的算术强度都很高。这种高算术强度也延续到 prefill,因为用户 prompt 通常长达数百乃至数千 token。 如前所见,TPUv5e 的硬件算术强度是 240,所以只要喂给在该硬件上以 bf16 运行的稠密模型超过 240 个 token 的序列,我们就预期 compute-bound,一切都好。短于此长度的 prompt 技术上可以拼到一起以提高利用率,但通常不必。
要点: 在 prefill 期间,所有矩阵乘几乎总是 compute-bound 的。因此,只要最大化硬件利用率或 MFU(Model FLOPs Utilization)就足以最大化每芯片吞吐(成本)和延迟(即 TTFT)。除非 prompt 极短,否则在 prompt 级别再做 batch 只会增加延迟,对 prefill 吞吐的提升有限。
但在 generation 期间,对每个请求我们一次只能做一个 token 的前向,因为各步之间存在顺序依赖!要获得好的利用率,我们只能(轻易地)通过把多个请求 batch 到一起、在 batch 维度上并行来实现。我们稍后会详谈,但实际上把许多并发请求 batch 到一起又不影响延迟是很难的。因此,让 generation 把硬件 FLOPs 跑满要难得多。
要点: 在 generation 期间,要让线性/前馈运算 compute-bound,token 总 batch size 必须大于 $B_{\text{crit}}$(TPU v5e 上 bf16 参数为 240)。由于 generation 是 token 接 token 的串行过程,这要求我们把多个请求 batch 起来,而这是困难的!
值得注意的是这个数有多大! 生成 batch 240 意味着同时有 240 个并发请求在生成,对稠密模型来说就是 240 份独立的 KV cache。除了少数批量推理场景,实际上很难达到。相比之下,让 prefill 一次过 240 个以上的 token 就很常见,不过随着稀疏度上升仍需小心。
注意这个具体的数字会因量化方式和硬件而异。 加速器在低精度下往往能提供更多算力。例如,若参数是 int8 但计算用 bf16,临界 batch size 降到 120。若激活和参数都是 int8,又回到 240,因为 TPUv5e 能提供 400 TOPs/s 的 int8×int8。
注意力呢?#
当我们看点积注意力时事情就更复杂了,尤其要把 KV cache 算进去。先看纯多头注意力下的单个注意力头。在一次 Flash Attention fusion 里,我们:
- 从 HBM 读形状为 $\text{bf16[B, T, D]}$ 的 $Q$ 激活。
- 从 HBM 读 $KV$ cache,是一对 $\text{bf16[B, S, D]}$ 张量。
- 在 $QK$ matmul 中执行 $2BSTD$ FLOPs。借助 Flash Attention,无需把 $\text{bf16[B, S, T]}$ 的注意力矩阵写回 HBM。
- 在注意力的 $AV$ matmul 中再执行 $2BSTD$。
- 把得到的 $\text{bf16[B, T, D]}$ 张量写回 HBM。
合起来:
$$\text{Multiheaded Attention Arithmetic Intensity} = \frac{4BSTD}{4BSD + 4BTD} = \frac{ST}{S+T}$$对 prefill,$S=T$(自注意力),化简为 $T^2 / 2T = T / 2$。这很棒,意味着prefill 中注意力的算术强度是 $\Theta(T)$。这意味着很容易就能 compute-bound。只要序列长度合理就没问题!
但 generation 的序列维是平凡的,$B$ 和 $D$ 也抵消了,可以近似为:
$$S \gg T = 1 \implies \frac{ST}{S+T} \approx 1$$这就糟糕了,因为我们没有任何办法提高 generation 期间注意力的算术强度。我们只做极少量的 FLOPs,却要加载一个庞大的 KV cache。所以 generation 期间的注意力基本永远是 memory bandwidth-bound 的!
要点: prefill 期间,对任何合理的序列长度(大致 $\gt 480$ tokens),注意力通常是 compute-bound;generation 期间算术强度低且为常数,所以始终是 memory bandwidth-bound。
为什么会这样,从概念上看? 主要原因是模型的线性部分之所以 compute-bound,是因为参数(内存带宽密集的部分)被 batch 中的多个样本复用。但 KV cache 是每个 batch 项独有的,batch 越大 KV cache 越多。除非架构作激进调整,否则这里几乎_总是_受内存带宽限制。
这也意味着,一旦参数所占内存与 KV cache 所占内存可比,再增大 batch size 对吞吐的回报会递减。递减的程度取决于单个序列下参数字节数与 KV cache 字节数之比,大致就是 $2DF / SHK$ 的比例。由于 $HK\approx D$,这大致取决于 $F$ 与序列长度 $S$ 之比。当然也取决于那些把 KV cache 变小的架构修改(稍后会谈)。
LLM 延迟与吞吐的理论估计#
由这套数学,我们可以对优化时所追求的步时给出相当好的下界。(注意:如果整章只能让读者带走一件事,就是这个)。 对 generation 时常见的小 batch,我们可以假设注意力和 MLP 块都是 memory bandwidth bound 的,从而给出每步延迟下界:
$$\text{Theoretical Min Step Time} = \frac{\text{Batch Size} \times \text{KV Cache Size} + \text{Parameter Size}}{\text{Total Memory Bandwidth}}$$类似的吞吐:
$$\text{Theoretical Max Tokens/s} = \frac{\text{Batch Size} \times \text{Total Memory Bandwidth}}{\text{Batch Size} \times \text{KV Cache Size} + \text{Parameter Size}}$$最终,随着 batch size 增大,FLOPs 会盖过参数加载时间,所以在实际中我们有更通用的方程:
$$\small \text{Theoretical Step Time (General)} = \underbrace{\frac{\text{Batch Size} \times \text{KV Cache Size}}{\text{Total Memory Bandwidth}}}_{\text{Attention (always bandwidth-bound)}} + \underbrace{\max\left(\frac{2 \times \text{Batch Size} \times \text{Parameter Count}}{\text{Total FLOPs/s}}, \frac{\text{Parameter Size}}{\text{Total Memory Bandwidth}}\right)}_{\text{MLP (can be compute-bound)}}$$其中注意力部分(左侧)永远不会 compute-bound,因此不需要 FLOPs roofline。这些公式对粗略估算非常有用,例如:
小测验: 假设我们要在 TPU v5e 4x4 slice 上对一个 30B 参数的稠密模型做一次 generate 步,batch 4 个 token,int8 参数、bf16 FLOPs、8192 上下文、每 token 100 kB 的 KV cache。这一操作延迟的合理下界是多少?如果改成 batch 256 token 呢?
答案: int8 下我们的参数占 30e9 字节,按上述规格 KV cache 各占 100e3 * 8192 = 819MB。我们有 16 张芯片,每张 8.1e11 字节/秒带宽和 1.97e14 bf16 FLOPs/s。由上面的方程,由于 batch 较小,预期步时至少为 (4 * 819e6 + 30e9) / (16 * 8.1e11) = 2.5 ms。在 256 token 下我们已进入 MLP 块的 compute-bound 区,步时大约 (256 * 819e6) / (16 * 8.1e11) + (2 * 256 * 30e9) / (16 * 1.97e14) = 21ms。
可以看到,这里吞吐与延迟之间存在明显的 trade-off。小 batch 快但硬件利用率低。大 batch 慢但高效。下面是一些较老 PaLM 模型的延迟-吞吐 Pareto 前沿(取自 ESTI 论文):
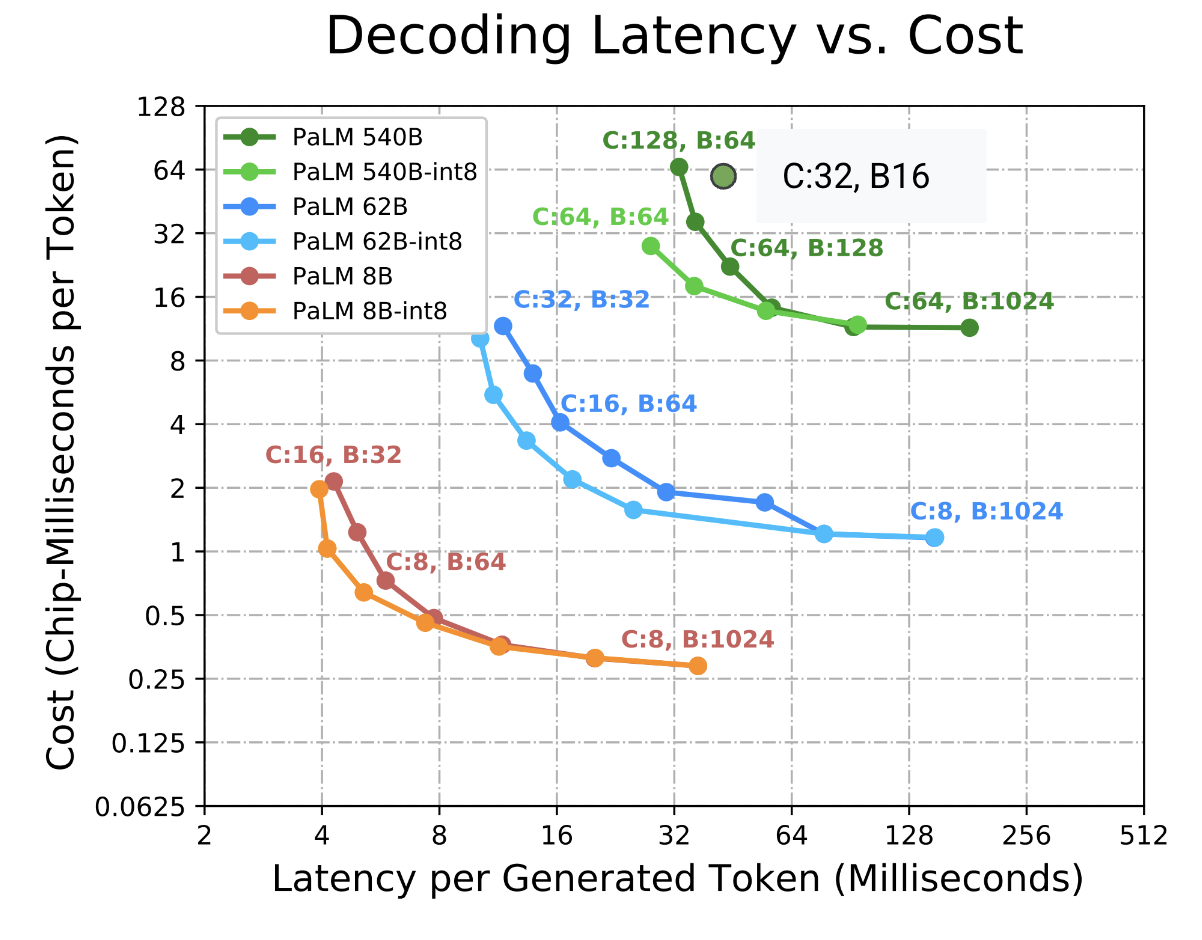
图: 几个 PaLM 模型的成本(即吞吐)-延迟 Pareto 前沿。注意 chip 数(C)和 batch size(B)会让你沿着 Pareto 前沿移动;绿点(PaLM 540B 的 C:32 B:16)除外,那里可用内存阻止了配置达到合适的 batch size,吞吐因而受损。注意吞吐通常在 batch 240 附近趋平。int8 权重提供了更优的延迟-吞吐 Pareto 最优,但并非更高的最大吞吐。
我们不仅以 batch size 为旋钮在延迟和吞吐间取舍,若发现自己受 HBM 限制,也可能更倾向于较大的拓扑以容纳更大的 batch。下一节对此有更详细的探讨。
要点: 如果你关心 generation 吞吐,使用尽可能大的每芯片 batch size。任何高于 TPU 算术强度($B_\text{crit}$,通常是 120 或 240)的每芯片 batch size 都能最大化吞吐。可能需要扩展拓扑才能达到。较小的 batch size 让你以吞吐为代价换取更好的延迟。
从硬件视角还有一些注意事项:
以上都相当理论化。实际中 roofline 往往不会那么锐利,原因有几条:
- 我们假设 HBM 读取与 FLOPs 完美重叠是不现实的,因为编译器(XLA)会出错。
- 对分片模型,XLA 也常常无法把模型分片矩阵乘所需的 ICI 通信与 FLOPs 高效重叠,因此线性层在 $\text{BS}=32$ 以上往往就开始有延迟代价。
- 由于重叠不完美,超过理论 roofline 的 batch size 仍会带来一些吞吐改进,但这是个不错的经验法则。
内存怎么算?#
我们花了不少时间看带宽和 FLOPs,却还没看内存。推理时的内存图景看起来很不一样,这要归功于我们的新数据结构 KV cache。本节我们以一个真实模型(LLaMA 2-13B)为例,演示情况有多不同:
| 超参 | 取值 |
|---|---|
| L (num_layers) | 40 |
| D (d_model) | 5,120 |
| F (ffw_dimension) | 13,824 |
| N (num_heads) | 40 |
| K (num_kv_heads) | 40 |
| H (qkv_dim) | 128 |
| V (num_embeddings) | 32,000 |
推理时谁在用内存?显然首先是参数。计数如下:
| 参数 | 公式 | 大小(字节) |
|---|---|---|
| FFW 参数 | d_model² × ffw_multiplier × 3(SwiGLU 的 gate、up、down 投影) × n_layers | 5,120 × 5,120 × 2.7 × 3 × 40 = 8.5e9 |
| 词表参数 | 2(输入和输出嵌入) × n_embeddings × d_model | 2 × 32,000 × 5,120 = 0.3e9 |
| 注意力参数 | [2(q 和 output) × d_model × n_heads × d_qkv + 2(k 和 v) × d_model × n_kv_heads × d_qkv] × n_layers | (2 × 5,120 × 40 × 128 + 2 × 5,120 × 40 × 128) × 40 = 4.2e9 |
加起来:8.5e9 + 4.2e9 + 0.3e9 = 总计 13e9 个参数,正如预期。如前面章节所述,训练时我们可能用 bfloat16 存参数,optimizer state 用 float32,约用 100GB 内存。这与 gradient checkpoints 相比微不足道,后者可能用掉数 TB。
推理有什么不同? 推理时我们存一份参数,假设是 bfloat16,占 26GB——实际通过量化往往可以做得更好。没有 optimizer state 或梯度需要追踪。由于我们不做 checkpoint(不为反向传递保留激活),prefill 和 generate 的激活占用都可以忽略。如果我们 prefill 8k 个 token,单个激活只占大约 8,192 × 5,120 × 2 字节 = 80MB。更长的 prefill 可拆成多个小前向,所以长上下文也不成问题。Generation 用的 token 比这还少,激活同样可以忽略。
主要差别在 KV cache。 这些是过去所有 token 的 key 和 value 投影,其大小只受最大允许序列长度限制。$T$ 个 token 的总大小为:
$$\text{KV cache size} = 2 \cdot \text{bytes per float} \cdot H \cdot K \cdot L \cdot T$$其中 $H$ 是每个 head 的维度,$K$ 是 KV head 的数量,$L$ 是层数,2 来自同时存 key 和 value。
即便适中的 batch size 和上下文长度,这也会迅速变得很大。 对 LLaMA-13B,bf16 下单个 8192 序列的 KV cache 是
$$8192\ (T) \times 40\ (K) \times 128\ (H) \times 40\ (L) \times 2\ (\text{bytes}) \times 2 = 6.7 \text{GB}$$仅 4 个就超过了参数的内存占用! 需要说明的是,LLaMA 2 并未为长上下文下的 KV cache 大小做特别优化(情况并不总是这么糟,因为 $K$ 通常比这小得多,比如 LLaMA-3),但这仍然很有代表性。我们在内存或延迟估算中不能忽略它们。
对 LLaMA 2-13B 的吞吐与延迟建模#
来看看在 8 张 TPU v5e 上、不同 batch size(直到上面推导出的临界 batch 240)下完美高效执行 generation 的情形:
| Batch Size | 1 | 8 | 16 | 32 | 64 | 240 |
|---|---|---|---|---|---|---|
| KV Cache 内存 (GiB) | 6.7 | 53.6 | 107.2 | 214.4 | 428.8 | 1608 |
| 总内存 (GiB) | 32.7 | 79.6 | 133.2 | 240.4 | 454.8 | 1634 |
| 理论步时 (ms) | 4.98 | 12.13 | 20.30 | 36.65 | 69.33 | 249.09 |
| 理论吞吐 (tokens/s) | 200.61 | 659.30 | 787.99 | 873.21 | 923.13 | 963.53 |
8 张 TPU v5e 共有 128GiB HBM、6.5TiB/s HBM 带宽(每张 0.82TiB/s)、1600TF/s 算力。
对这个模型,增大 batch size 确实带来更好的吞吐,但回报迅速递减。batch 16 之后就 OOM 了,要逼近 240 还得多一个数量级的内存。更大的拓扑能改善延迟,但每芯片吞吐已经撞墙。
假设我们让总参数量不变,但魔法般地把 KV cache 缩小 5 倍(比如用 1:5 的 GMQA,即 8 个 KV head 由 40 个 Q head 共享——下一节有更多细节)。
| Batch Size | 1 | 8 | 16 | 32 | 64 | 240 |
|---|---|---|---|---|---|---|
| KV Cache 内存 (GiB) | 1.34 | 10.72 | 21.44 | 42.88 | 85.76 | 321.6 |
| 总内存 (GiB) | 27.34 | 36.72 | 47.44 | 68.88 | 111.76 | 347.6 |
| 理论步时 (ms) | 4.17 | 5.60 | 7.23 | 10.50 | 17.04 | 52.99 |
| 理论吞吐 (tokens/s) | 239.94 | 1,429.19 | 2,212.48 | 3,047.62 | 3,756.62 | 4,529.34 |
在更小的 KV cache 下,回报仍然递减,但每芯片理论吞吐能持续扩展到 batch 240。我们能装下 64 这样大得多的 batch,所有 batch size 下延迟也都更好。延迟、最大吞吐、最大 batch size 都大幅改善!实际上后来的 LLaMA 系列正用了这一优化——LLaMA-3 8B 有 32 个 query head 和 8 个 KV head(来源)。
要点: 除了参数,KV cache 大小对模型最终的推理性能影响巨大。我们应当通过架构决策与运行时优化的组合把它压住。
提升生成吞吐与延迟的技巧#
自原始 Attention is All You Need 论文以来,已经发展出许多让模型更高效的技术,常常专门针对 KV cache。一般而言,更小的 KV cache 让我们更容易在不损害延迟的情况下提高 generation 步的 batch size 和上下文长度,也让 Transformer 周边的系统(如请求缓存)日子更好过。先不论对质量的影响,我们大致可以看到:
分组多查询注意力(aka GMQA、GQA): 我们可以减少 KV head 的数量,把它们与多个 Q head 共享。极端情况下可以让单个 KV head 共享给所有 Q head。这相对于纯 MHA 把 KV cache 缩小 Q:KV 比例的倍数,且观察到模型性能对此变化相对不敏感。
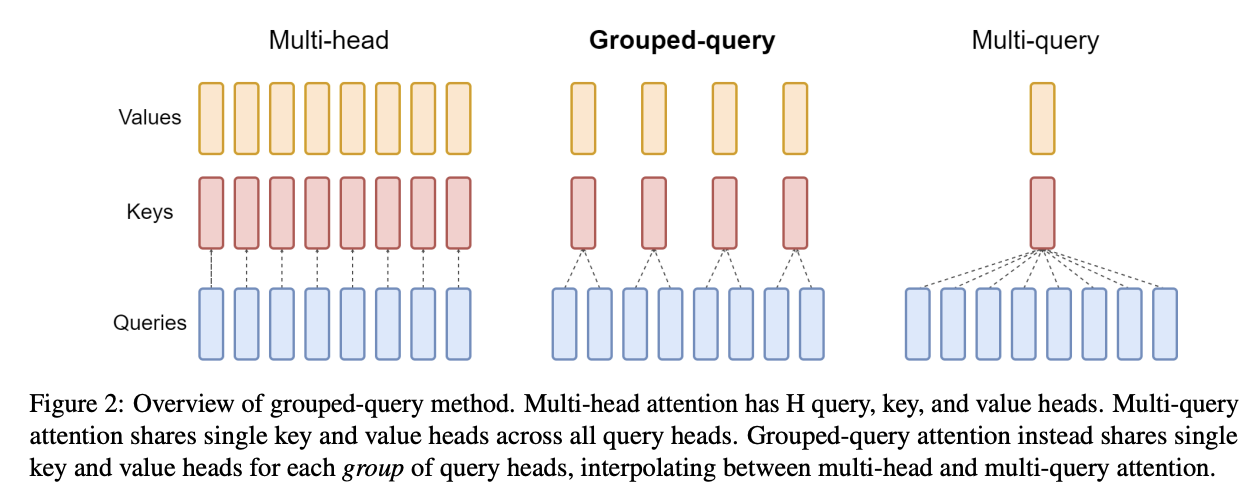
这也有效提高了注意力计算的算术强度(参见 Section 4 第 4 题)。
混入一些局部注意力层: 局部注意力把上下文限制到一个较小到中等的最大长度。在训练和 prefill 时,这相当于把注意力矩阵从三角形遮罩到对角带。这有效封顶了局部层 KV cache 的最大长度。把若干局部层与全局层混入模型,KV cache 在长于局部窗口的上下文下显著缩小。
层间共享 KV: 模型可以学着按某种模式跨层共享同一份 KV cache。虽然这能缩小 KV cache、并在增大 batch size、缓存、离线存储等方面带来好处,但共享的 KV cache 可能要从 HBM 多次读取,所以并不一定改善步时。
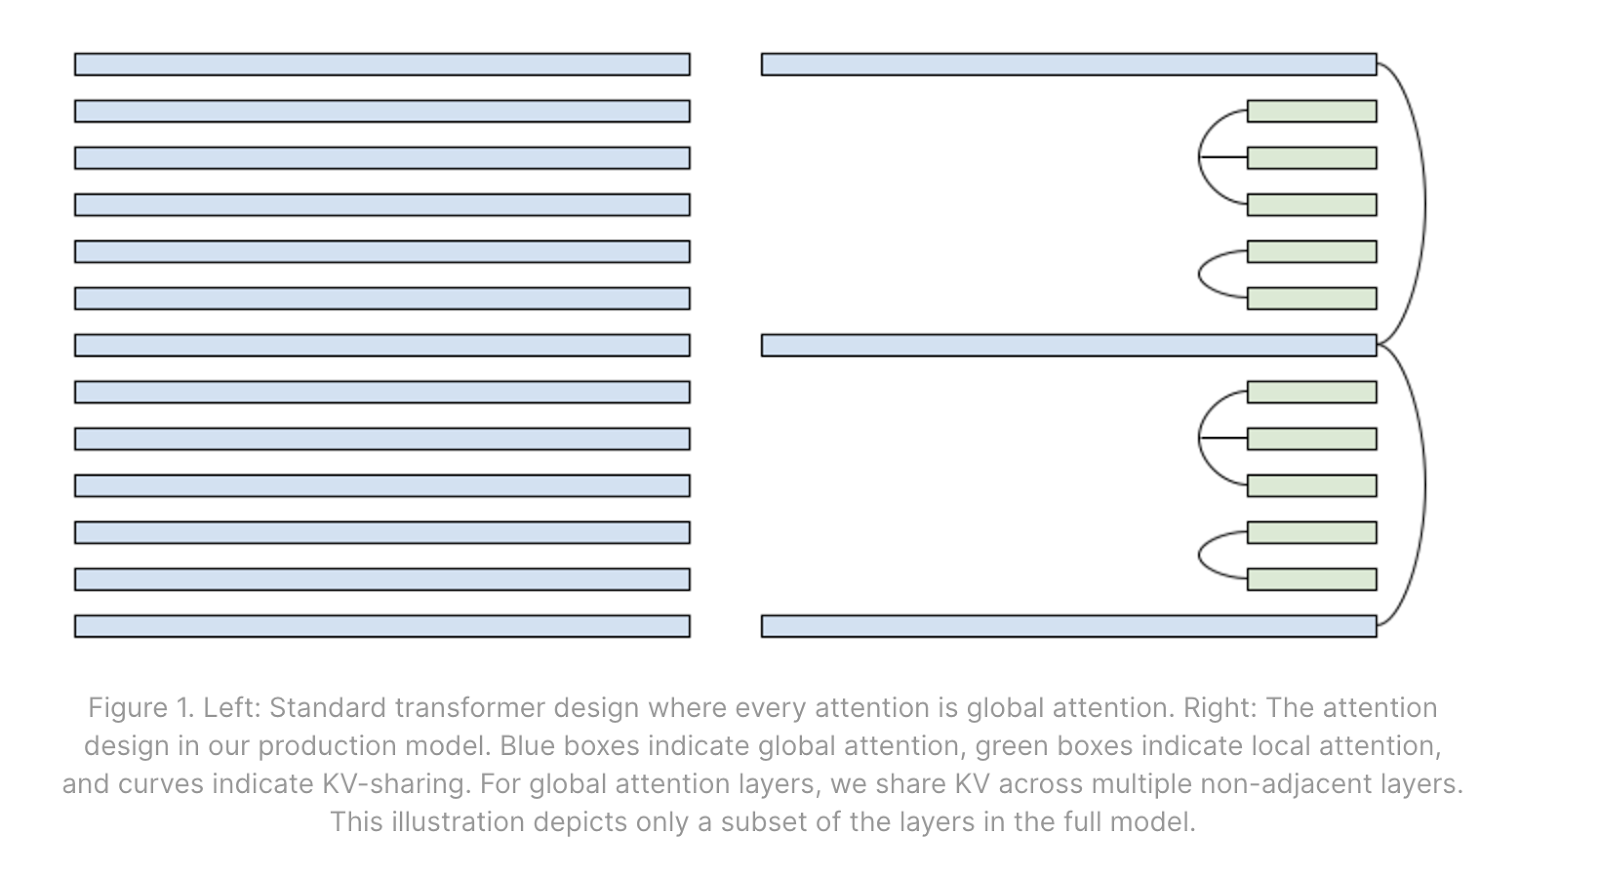
左: 多层纯全局注意力。右: 一种全局/局部交错并与相邻层共享的示例模式。来源:Character.ai blog。
量化: 推理对参数和 KV 的精度通常不那么敏感。通过把参数和 KV cache 量化(如 int8、int4、fp8 等),我们可以在两者上节省内存带宽,降低达到 compute roofline 所需的 batch size,并节省内存以跑更大的 batch。量化的另一好处是即便模型未做量化训练,也常可在训练后应用。
使用 ragged HBM 读取与 Paged Attention: 上面计算时我们给每个 KV cache 分配了 8k 上下文,但通常不必从内存读取整个 KV cache——请求长度分布很广,并不会用到模型的最大上下文,因此我们常可实现只读取 KV cache 中非 padding 部分的 kernel(如各种 Flash Attention 变体)。
Paged Attention 是这一思想的细化:把 KV cache 存进操作系统风格的页表,几乎完全避免对 KV cache 做 padding。这增加了不少复杂度,但意味着每个 batch 只用它真正需要的内存。这是运行时优化,因此与架构无关。
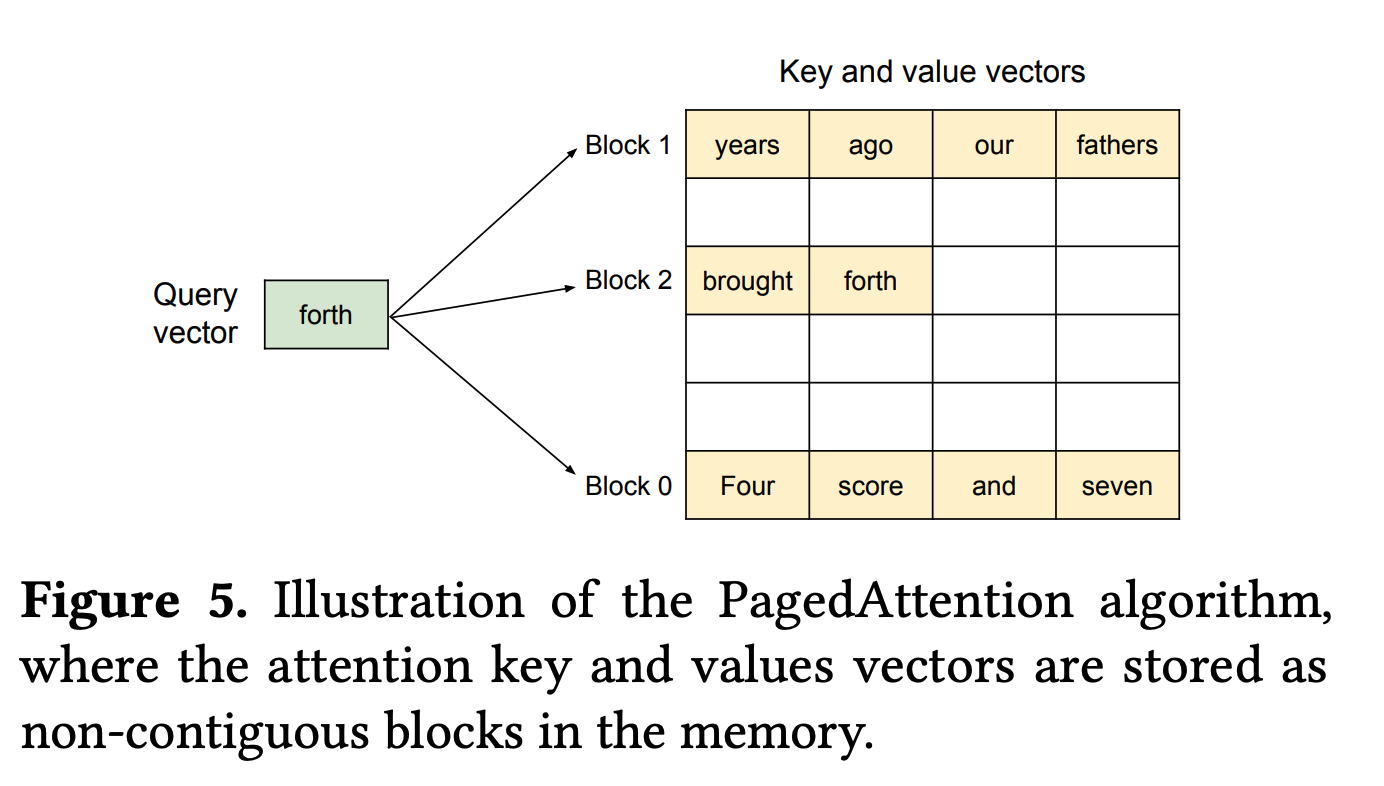
图: generation 期间,单个 token(“forth”)attend 多个 KV cache 块/页。通过对 KV cache 分页,我们避免加载或存储多于所需的内存。摘自 PagedAttention 论文。
总图景: 综合起来,这些 KV cache 优化相比标准 MHA Transformer 可以把 KV cache 大小压缩一个数量级以上。这可以带来 Transformer 总体成本一个数量级的改善。
把推理分布到多张加速器上#
到目前为止我们都对如何扩展到单芯片之外含糊带过。沿用 Section 5,我们来探讨可用的不同策略及其取舍。和往常一样,我们分别考察 prefill 与 generation。
Prefill#
从 roofline 视角看,prefill 几乎与训练相同,几乎所有同样的技术与取舍都适用——模型(Megatron)并行、序列分片(足够长上下文时)、流水线、甚至 FSDP 都可行!你只需要把 KVs 留下来供后续 generation 用。和训练一样,增加芯片数提供更多 FLOPs/s(潜在更低 TTFT),但也带来通信开销(潜在降低每芯片吞吐)。
prefill 分片的一般规则: 这里给出一组 prefill 的通用规则。假设我们只对单个序列做 prefill(无 batch 维):
- 模型分片: 通常先做一定量的模型并行,直到 ICI-bound。如 Section 5 所述,单轴大约是 $F / 2200$(通常 4–8 路分片)。
- 序列并行: 超出此后做序列并行(类似数据并行,但沿序列维分片)。虽然序列并行在注意力中引入额外通信,长上下文下通常很小。和训练一样,我们可以重叠通信与计算(分别用 collective matmul 替代 Megatron 和用 ring attention 替代)。
要点: prefill 期间,几乎任何在训练时可行的分片在这里都行。先做模型并行直到 ICI 上限,然后做序列并行。
Generation#
Generation 比 prefill 复杂得多。一方面,要拿到大 batch 更难,因为我们需要把许多请求 batch 到一起。延迟目标更低。综合起来,我们通常更受内存限制,对通信开销也更敏感,这限制了我们的分片策略:
- FSDP 不可行: 由于我们在把参数和 KV cache 从 HBM 加载到 MXU 时是 memory-bound 的,我们不希望通过比 HBM 慢几个数量级的 ICI 来搬运它们。我们想搬运激活而不是权重。 这意味着 FSDP 类方法在 generation 中通常完全不可行。
- 没有理由做数据并行: 纯数据并行没有用,因为它复制了我们的参数,并不能帮我们更快加载参数。不如启动多份模型副本。
- 没有 sequence = 没有 sequence sharding。 序列分片,祝你好运。
这基本就只剩下稠密模型 generation 的各种模型分片变体了。 与 prefill 类似,最简单的做法就是简单的模型并行(激活完全复制,MLP 权重沿隐藏维完全分片)做到 4–8 路直到 ICI bound。但由于我们常常 memory bandwidth bound,实际上可以越过这个上限以改善延迟!
关于 generation 的 ICI 上限: 训练时我们想 compute-bound,所以 roofline 看 ICI 通信何时长于 FLOPs。但 generation 时,如果我们因参数加载而 memory bandwidth bound,可以把模型分片提高到这个点之上,以极小的吞吐代价(按 tokens/sec/chip 计)改善延迟。更多模型分片意味着用更多 HBM 来加载权重,FLOPs 不重要。来看在它成为瓶颈之前我们能做多少模型并行。
$$\begin{align*}T_\text{HBM comms} = \frac{2DF}{Y \cdot W_\text{hbm}} && T_\text{ICI comms} = \frac{2BD}{W_\text{ici}}\end{align*}$$$$T_\text{ICI comms} > T_\text{HBM comms} \rightarrow \frac{W_\text{hbm}}{W_\text{ici}} > \frac{F}{Y \cdot B} \rightarrow Y > F / (B \cdot \beta)$$其中 $\beta = W_\text{hbm} / W_\text{ici}$。对 TPU v5e 和 TPU v6e 这个数大约是 8。也就是说,例如 $F$ 是 16,384、$B$ 是 32 时,理论上我们可以做最多 16384 / (32 * 8) = 64 路模型并行而吞吐没有显著损失。这假设我们能把 KV cache 完全 64 路分片,这是困难的:下面会讨论。
对注意力层,我们也以 Megatron 方式按 head 模型分片 $W_Q$ 和 $W_O$。KV 权重相当小,复制它们往往比超过 $K$ 路分片更便宜。
要点: generation 期间,我们唯一的选择是各种模型并行变体。我们倾向于搬运激活而不是较大的 KV cache 或参数。当 batch size 较大时,把模型并行做到 FLOPs-ICI 上限($F / \alpha$)。当 batch size 较小时,可以通过更多模型分片(以适度吞吐代价)改善延迟。当我们想做超过 KV head 数量的模型分片时,可以同时沿 batch 维分片 KV。
对 KV Cache 进行分片#
我们还有一个需要分片的额外数据结构——KV cache。 同样,我们几乎总是希望避免复制 cache,因为它是注意力延迟的主要来源。为此我们先沿 head 维 Megatron 分片 KVs。这受限于 $K$ 路分片,所以对 head 数较少的模型,我们尽量沿 head 维分片,然后再沿 batch 维分片,即 $\text{KV}[2, B_Z, S, K_Y, H]$。这意味着 KV cache 完全分布。
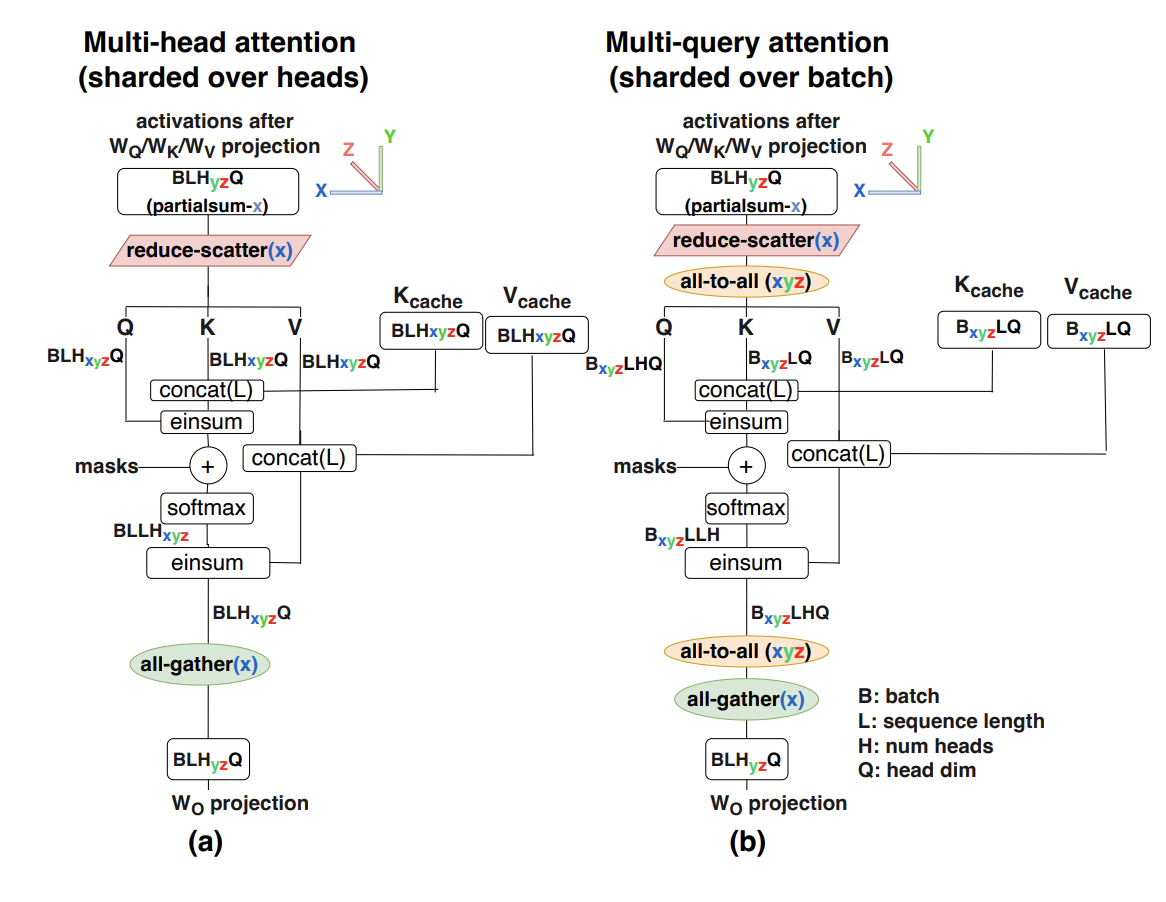
图: 注意力机制对比:(a) 纯模型分片的多头注意力,(b) KV cache 做 batch 分片的多查询注意力。注意我们需要两次额外 AllToAll,把激活从模型分片切到 batch 分片,以便对 KV cache 做运算。
代价是每个注意力层两次 AllToAll——一次把 Q 激活切到 batch 分片以便对 batch 分片做注意力,一次把 batch 分片的注意力输出切回纯模型分片。
下面是完整算法!
这里写出在 $Y$ 与 $Z$ 上做模型并行的完整注意力算法。抱歉同时用 $K$ 表示 key 张量与 KV head 维。设 $M=N/K$。
- X[B, D] = …(来自上一层的现有激活,未分片)
- K[BZ, S, KY, H], V[BZ, S, KY, H] = …(已存在的 KV cache,按 batch 分片)
- Q[B, NYZ, H] = X[B, D] * WQ[D, NYZ, H]
- Q[BZ, NY, H] = AllToAllZ->B(Q[B, NYZ, H])
- Q[BZ, KY, M, H] = Reshape(Q[BZ, NY, H])
- O[BZ, S, KY, M] = Q[BZ, KY, M, H] *H K[BZ, S, KY, H]
- O[BZ, S, KY, M] = SoftmaxS(O[BZ, S, KY, M])
- O[BZ, KY, M, H] = O[BZ, S, KY, M] *S V[BZ, S, KY, H]
- O[B, KY, MZ, H] = AllToAllZ->M(O[BZ, KY, M, H])
- O[B, NYZ, H] = Reshape(O[B, KY, MZ, H])
- X[B, D] {UYZ} = WO[NYZ, H, D] *N,H O[B, NYZ, H]
- X[B, D] = AllReduce(X[B, D] { UYZ})
这相当复杂,但你大体能看出它怎么工作。新增的通信开销不大,因为它们作用在小的激活上;作为回报,我们在加载 KVs(保持原位)时省下了大量的内存带宽。
- 序列分片: 如果 batch size 太小或上下文很长,我们可以对 KV cache 做序列分片。同样,我们会为跨分片累加注意力付出 collective 代价。先 AllGather Q 激活,再以类似 Flash Attention 的方式累加 KVs。
设计一个高效的推理引擎#
到目前为止我们考察了如何独立地优化与分片单独的 prefill 和 generate 操作。要真正高效地使用它们,我们需要设计一个推理引擎,在我们选择的延迟/吞吐 Pareto 前沿点上调度这两个操作。
最简单的方法就是先跑一批 prefill,再跑一批 generation:
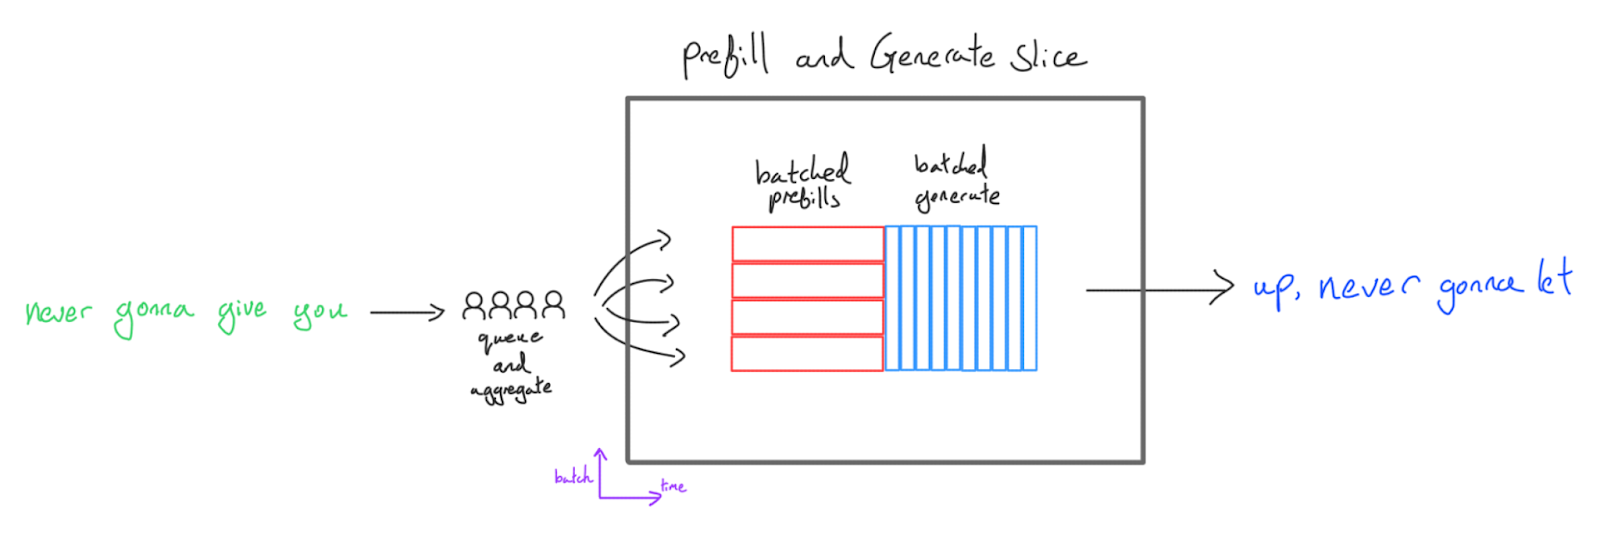
图: 最简单的设置中,请求被聚合,服务器在批量 prefill 与对所有序列调用 generate 直到完成之间交替。
这容易实现,是大多数代码库里第一个推理设置,但有多个缺点:
- 延迟糟糕。 我们把 prefill 与 generate 的 batch size 耦合了。大 prefill batch 下 TTFT 很糟——你必须先完成所有 prefill,任何用户才能看到任何 token。小 batch 下 generate 吞吐又很糟。
- 短生成被长生成阻塞。 许多序列会比其它序列先完成,留下空的 batch slot,进一步伤害 generate 吞吐。这随 batch size 与生成长度的增加而恶化。
- prefill 被 padding。 Prefill 被 padding 到最长序列,浪费大量计算。这有解,但历史上 XLA 让跳过这些 FLOPs 相当困难。同样,batch size 与 prefill 序列长度越大问题越严重。
- 被迫共享 prefill 与 generation 的分片。 两者位于同一 slice,意味着我们用相同的拓扑与分片(除非保留两份权重),通常对性能不利,例如 generate 想要更多模型分片。
因此这种方法只推荐用于边缘应用(通常只服务单用户、硬件 FLOPs/byte 较低)以及 Transformer 代码库生命周期早期的快速迭代(因其简洁)。
稍好的做法是 batch size 1 做 prefill(此时 compute-bound 但有合理延迟),但在 generation 时 batch 多个请求:
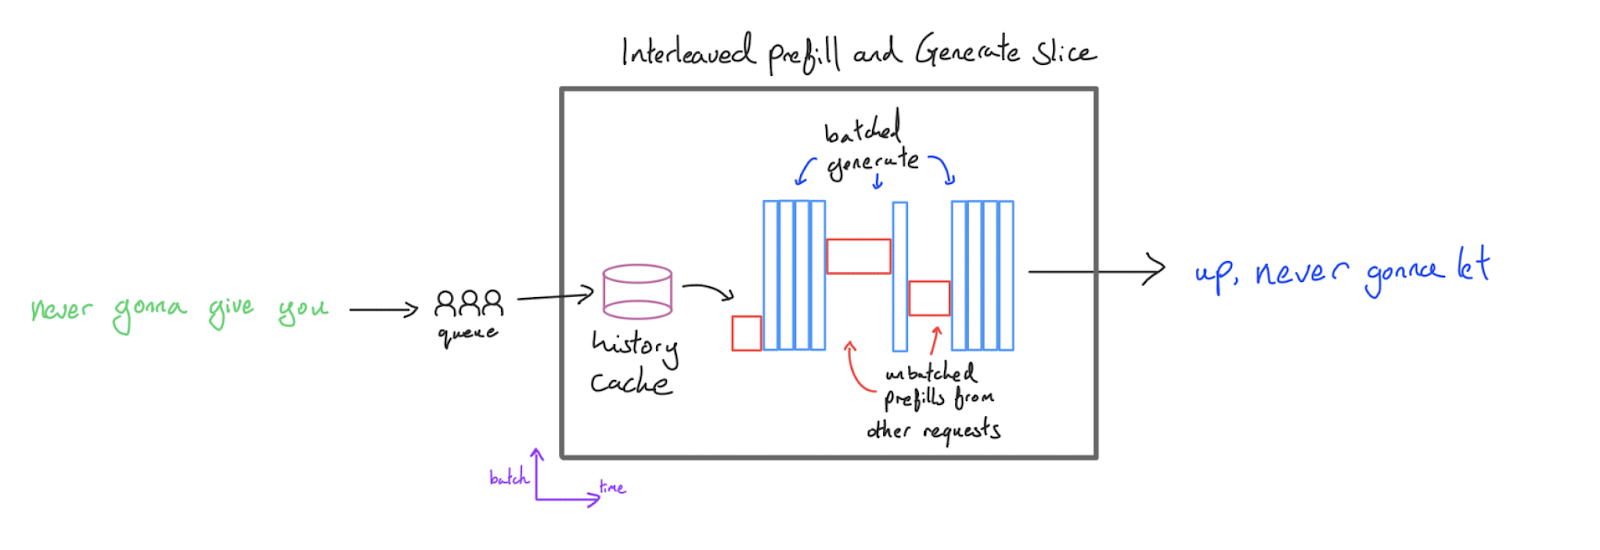
这避免了批 prefill 带来的 TTFT 浪费,同时保持了较高的 generation 吞吐。我们称之为**交错(interleaved)**配置,因为我们"交错"prefill 与 generation 步。这对评测等以吞吐为主要目标的批量生成应用很强。orchestrator 可以配置为只要任何 generation slot 空出就优先 prefill,从而即便在很大的 generation batch 下也能保持高利用率。我们也无需把 prefill padding 到最大长度,因为它不与其它请求 batch 在一起。
主要缺点是:当服务器在做 prefill 时,所有其它请求的 generation 都会暂停,因为算力会被 prefill 占满。用户 A 在 decode 中的回复会被用户 B 的 prefill 阻塞。这意味着虽然 TTFT 改善了,平均的 token 生成会卡顿、变慢,对许多应用来说体验不佳——其它用户的 prefill 落在了请求总延迟的关键路径上。
为绕开这点,我们把 decode 与 prefill 分开。Transformer 推理虽可在一台服务器上完成,但从延迟角度看通常更好的是让两个不同任务在两组 TPU/GPU 上执行。Prefill 服务器生成 KV cache,通过网络发送到 generate 服务器,后者把多份 cache 一起 batch,并为每份生成 token。我们称之为**“分离式(disaggregated)”**服务。
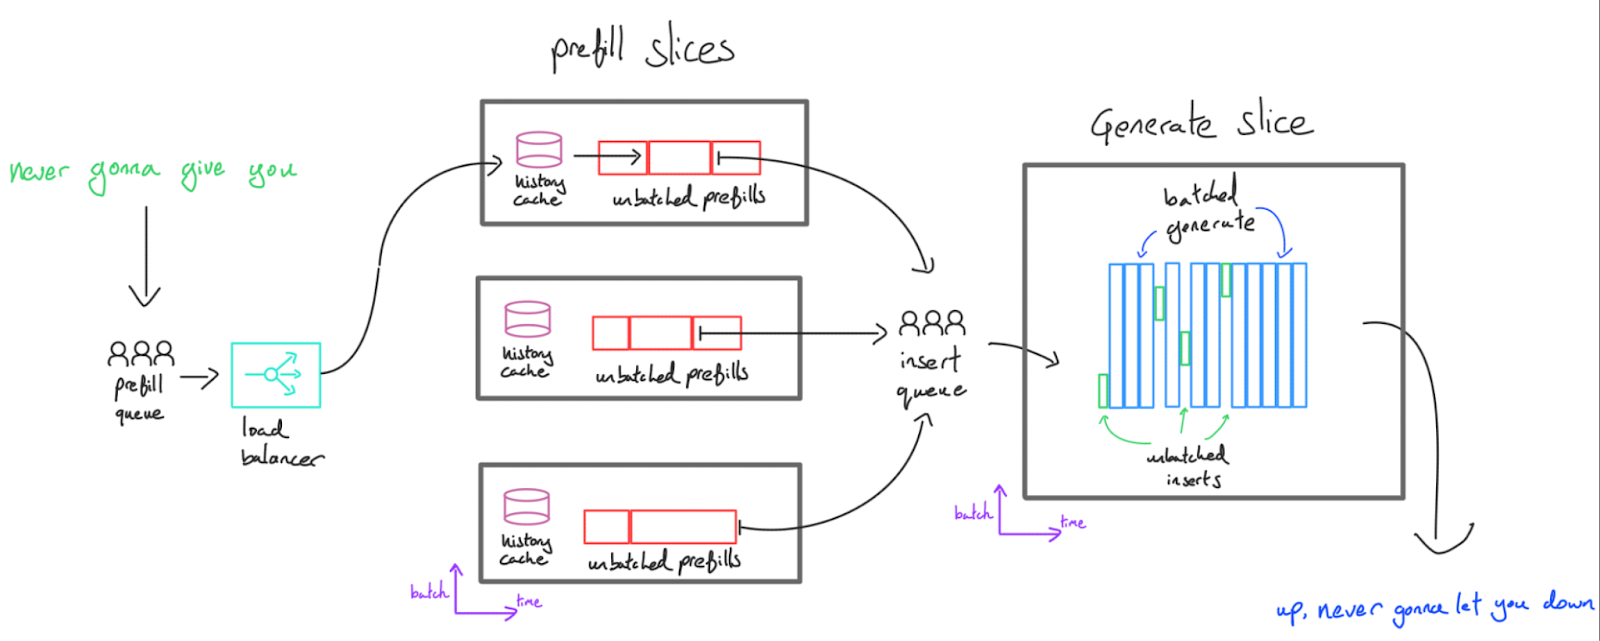
这带来几项优势:
- 大规模下低延迟:用户请求永不阻塞在另一用户的请求上,除非 prefill 容量不够。请求应当立刻被 prefill,然后送至 generation 服务器,立即插入 generation 缓冲。如果预计有许多并发请求到来,可以独立扩展 prefill 服务器与 generate 服务器的数量,让用户不会在 prefill 队列中长期等待。
- 专门化:相当多时候,prefill 与 generate 的延迟最优参数分片策略/硬件拓扑是相当不同的(例如更多模型并行对 generate 有用而对 prefill 没用)。强迫两者使用相同分片伤害两者性能,而保留两份权重又耗内存。同时,把 prefill 移到自己的服务器上后,它无需保留任何 KV cache 除了当前正在处理的那份。这意味着我们有更多空闲内存用于历史缓存(见下节)或优化 prefill 延迟。
一个缺点是 KV cache 现在需要跨网络搬运。这通常可接受,但又一次为缩小 KV cache 提供了动机。
要点: 对延迟敏感、高吞吐的服务,我们通常必须把 prefill 与 generation 分到不同服务器,prefill 以 batch 1 运行,generation 把许多并发请求 batch 在一起。
连续批处理(Continuous batching)#
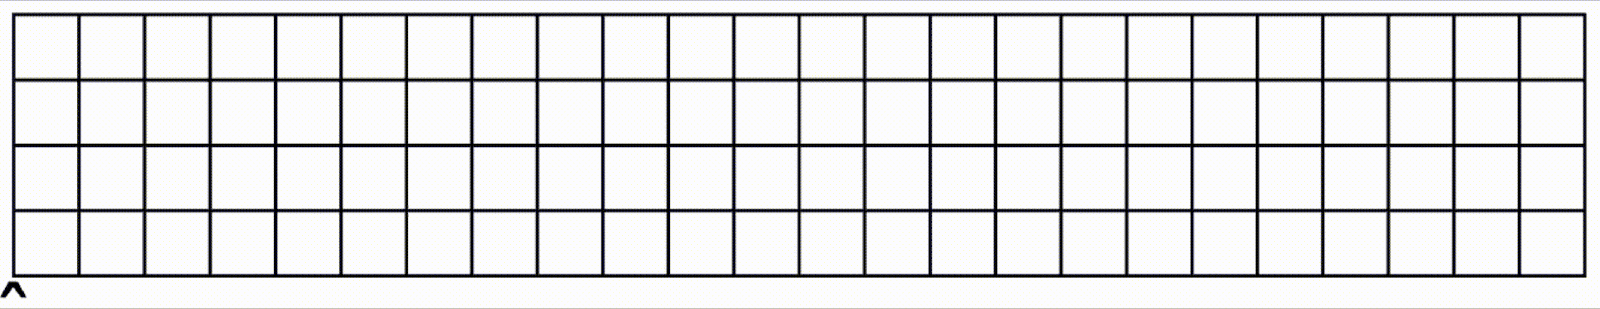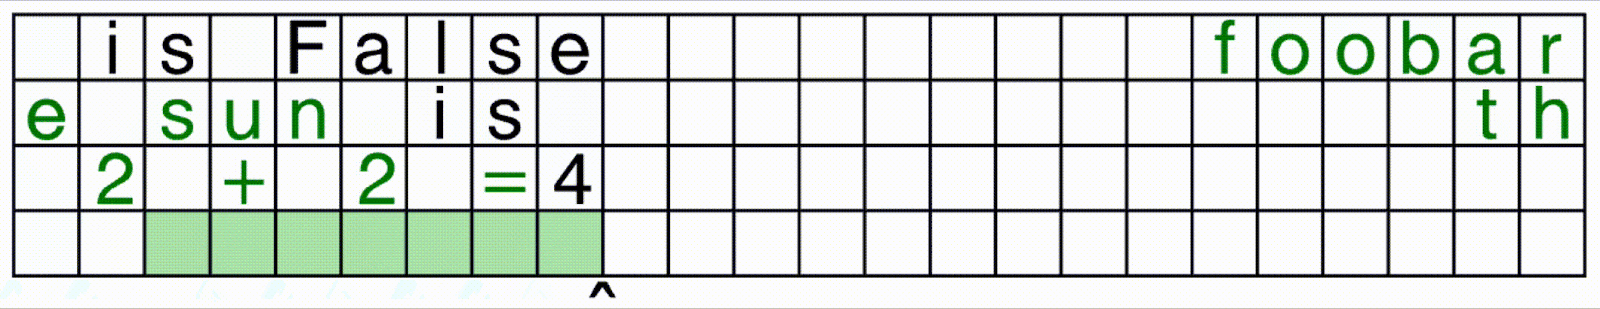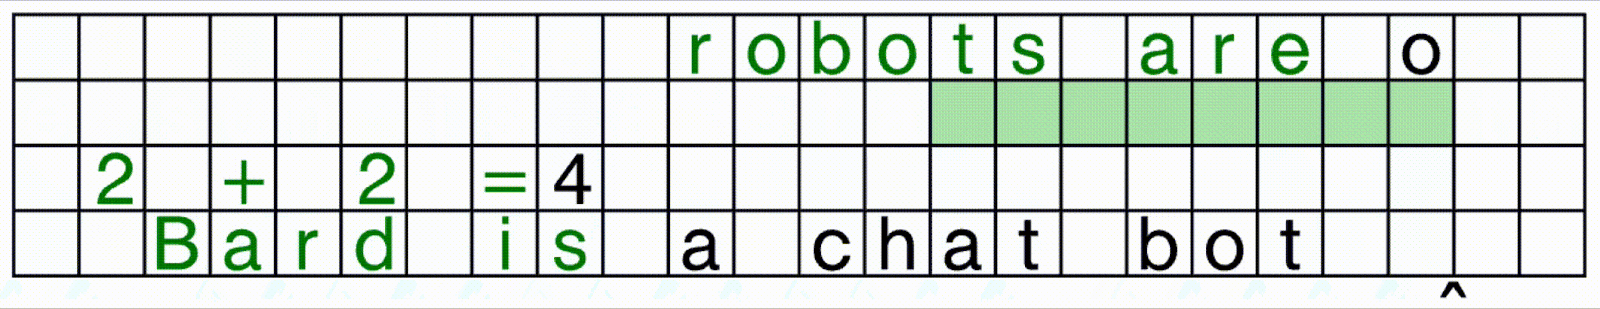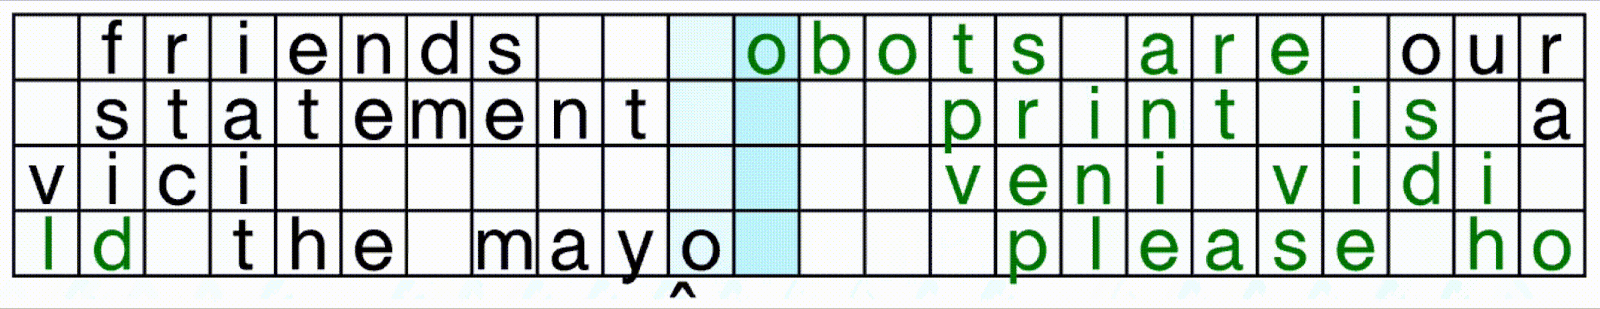
上面问题 (2) 引出了连续批处理的概念。我们优化并编译:
- 一个 prefill 函数,处理可变上下文长度,并把结果插入一个具备最大 batch size 与上下文长度/页数的 KV 缓冲区。
- 一个 generate 函数,接收 KV cache,对所有当前活跃请求执行 generation 步。
然后用一个 orchestrator 把这两个函数组合起来,它将到来的请求入队,根据空闲 generate slot 调用 prefill 与 generate,处理历史缓存(见下节),并把 token 流式输出。
前缀缓存(Prefix caching)#
由于 prefill 昂贵且 compute-bound(裕度更小),降低其成本的最佳方式之一就是少做。LLM 是自回归的,因此查询 [“I”, “like”, “dogs”] 与 [“I”, “like”, “cats”] 产生的 KV cache 在前两个 token 上相同。这意味着原则上,如果我们先算 “I like dogs” 的 cache,再算 “I like cats” 的 cache,只需要做 1/3 的计算。我们可以通过复用 cache 省下大部分工作。这在以下几种情况下尤其有力:
- 聊天机器人:大多数聊天机器人对话是来回追加式对话,意味着如果能保存每轮的 KV cache,就能跳过除了最新 token 之外所有内容的计算。
- few-shot 提示:任何 few-shot prompt 都可以白嫖式保存与复用。系统指令也常具备这种形式。
唯一困难是内存约束。我们已经看到 KV cache 很大(常常数 GB),要让缓存有用,就得在后续查询到来前一直保留。通常 prefill 服务器上任何空闲的 HBM 都可用作本地缓存系统。此外,加速器的 CPU 主机上通常有大量内存(例如一台 8xTPUv5e 服务器有 128GiB HBM 但约 450GiB 主机 DRAM)。这块内存比 HBM 慢得多——通常太慢做不了 generation 步——但读取 cache 足够快了。实践中:
- 由于 KV cache 局部于处理初始请求的那组 TPU,我们需要某种亲和性路由保证后续查询到达同一副本。这会给负载均衡带来麻烦。
- 较小的 KV cache 在这里又有帮助——能在同样空间内保存更多 KV cache,并降低读取时间。
- KV cache 与查找天然适合放在树或 trie 中。Eviction 可按 LRU 进行。
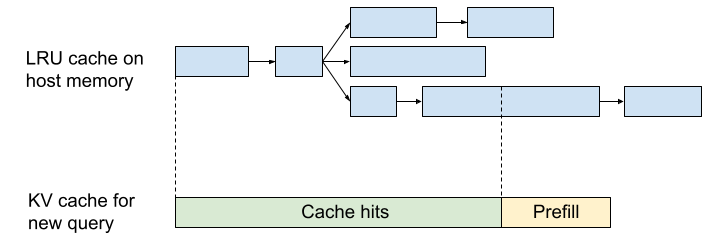
图: 实现为 LRU trie 的 KV 前缀缓存。我们可以通过共享前缀避免重复 KV 内存。来源:Character.ai blog。
实现剖析:JetStream#
Google 开源了实现这套逻辑的库 JetStream。服务器有一组 “prefill engines” 与 “generate engines”,通常在不同 TPU slice 上,由一个控制器协调。Prefill 在 “prefill thread” 中发生,generation 在 “generate thread” 中发生。还有一个 “transfer thread” 负责把 KV cache 从 prefill slice 拷贝到 generate slice。
Engine 接口(实现见此)是任何 LLM 都需提供的通用接口。关键方法有:
- prefill: 接收一组输入 token,生成一份 KV cache。
- insert: 接收一份 KV cache,插入到 generate 正在处理的 KV cache batch 中。
- generate: 接收一批 batched KV cache,每个 batch 项生成一个 token,并把单 token 的 KV cache 追加到对应解码状态。
JetStream 还有一个 PyTorch 版本,在此。
习题#
我会基于 LLaMA-2 13B 杜撰一个新模型用于本节。细节如下:
| 超参 | 取值 |
|---|---|
| L (num_layers) | 64 |
| D (d_model) | 4,096 |
| F (ffw_dimension) | 16,384 |
| N (num_heads) | 32 |
| K (num_kv_heads) | 8 |
| H (qkv_dim) | 256 |
| V (num_embeddings) | 32,128 |
问题 1: 上面这个模型有多少参数?int8 下每 token 的 KV cache 多大?可假设输入与输出投影矩阵共享。
答案:
参数计数:
- MLP 参数计数:$L * D * F * 3$
- 注意力参数计数:$L * 2 * D * H * (N + K)$
- 词表参数:$D * V$(因为我们共享这些矩阵)
总参数计数为 $L * D * (3F + 2H * (N + K)) + D * V$。代入数值:64 * 4096 * (3*16384 + 2 * 256 * (32 + 8)) + 4096 * 32128 = 18.4e9。所以这个模型约有 184 亿参数。
KV cache 在 int8 下每 token 大小为 $2 * L * K * H$,即 2 * 64 * 8 * 256 = 262kB per token。
问题 2: 假设我们想在 TPUv5e 4x4 slice 上服务这个模型,并能在该拓扑上完全分片 KV cache。如果一切都用 int8 并需支持 128k 序列,最大可容纳的 batch size 是多少?如果把 KV head 数降到 1 呢?
答案:
KV cache 在 int8 下每 token 大小为 $2 \cdot L \cdot K \cdot H$,即 2 * 64 * 8 * 256 = 262kB。对 128k 序列,每个 batch 项是 262e3 * 128e3 = 33.5GB。每张 TPU 16GB HBM,扣掉参数后能容纳的最大 batch 为 (16 * 16e9 - 18.4e9) / 33.5e9 = 7。如果 $K=1$,则是这个的 8 倍,约 56。
问题 3: 假设参数完全分片在 TPU v5e 4x4 slice 上,把所有参数从 HBM 加载到 MXU 要多久?假设 int8 参数。这是单步延迟的良好下界。
答案:
我们共有 18.4B 参数,int8 下即 18.4e9 字节。每张芯片 HBM 带宽 8.1e11,故约需 18e9 / (8.1e11 * 16) = 1.3ms,假设能完全用上 HBM 带宽。
问题 4: 假设我们想在 TPUv5e 4x4 slice 上以 int8 FLOPs 与参数/激活服务这个模型。该如何对 prefill 与 decode 分片?提示:先回答这些问题:
- 4x4 上 ICI 长什么样?
- 张量并行的 roofline 上限是多少?
- KV cache 怎么分片?
对这种分片,generation 的每步大致延迟是多少?
问题 5: 假设上面这个模型其实是 MoE。MoE 模型实际上是有 E 份 FFW 块的稠密模型。每个 token 经过其中的 k 个 FFW 块,对这 k 个的输出取平均作为输出。我们用 E=16 与 k=2 配上面的设置。
- 它有多少总参数与激活参数?激活意指任意给定 token 用到的。
- 在 TPU v5e 上要多大 batch size 才能 FLOPs bound?
- 它每 token 的 KV cache 多大?
- 含 T 个 token 的前向传递涉及多少 FLOPs?
答案:
(1) 作为 MoE,每个 MLP 块现在有 $3 * E * D * F$ 参数,比稠密版多 $E$ 倍。所以总数是 $L * D * (3EF + 2H * (N + K)) + D * V$ 即 64 * 4096 * (3*16*16384 + 2 * 256 * (32 + 8)) + 4096 * 32128 = 212e9 总参数,约多 12 倍。激活参数我们用 $k$ 而不是 $E$,总数为 64 * 4096 * (3*2*16384 + 2 * 256 * (32 + 8)) + 4096 * 32128 = 31.2e9,比稠密版多不到 2 倍。
(2) 因为参数是 $E$ 倍而 FLOPs 只多 $k$ 倍,HBM roofline 变为 $E/k$ 倍。即 TPU v5e 上需要约 240 * (16 / 2) = 1920 个 token。
(3) KV cache 大小不变,因为 MoE 的特性不改变注意力机制的任何东西。
(4) 仍然是 $2 \cdot \text{激活参数} \cdot T$,即 $2 * \text{31.2e9} * T$。
问题 6: 对 MoE,我们可以做 “expert sharding”,把专家沿 mesh 的某一轴拆分。按我们的标准记法,第一个 FFW 权重形状为 [E, D, F],我们把它分片为 [EZ, DX, FY],其中 X 仅训练时作为 FSDP 维使用。假设我们要在 TPU v5e 上做推理:
- 在 TPU v5e 8x16 slice 上、Y=8、Z=16 时,上述模型的 HBM 权重加载时间是多少?每张 TPU 还有多少空闲 HBM?
- 我们能装下这个模型的最小 slice 是?
问题 7 [2D 模型分片]: 这里我们梳理 ESTI 论文中所谓 2D weight-stationary 分片的数学。基本想法是:把权重沿 $D$ 与 $F$ 两个轴分片,让每块大致是方形。这降低通信负载并允许我们扩得更远一些。
下面是 2D weight stationary 算法:
- In[B, DX] = AllGatherYZ(In[B, DXYZ])
- Tmp[B, FYZ] {UX} = In[B, DX] *D Win[DX, FYZ]
- Tmp[B, FYZ] = AllReduceX(Tmp[B, FYZ] {UX})
- Out[B, DX] {UYZ} = Tmp[B, FYZ] *F Wout[FYZ, DX]
- Out[B, DXYZ] = ReduceScatterYZ(Out[B, DX] {UYZ})
你的目标是算出该算法的 $T_\text{math}$ 与 $T_\text{comms}$,并找出何时它优于传统的 3D 模型分片?
答案:
来算 $T_\text{math}$ 与 $T_\text{comms}$。所有 FLOPs 完全分片,因此和之前一样 $T_\text{math} = 4BDF / (N \cdot C)$,但通信变为:
$$\begin{align*} T_\text{2D comms} = \frac{2BD}{2X \cdot W_\text{ici}} + \frac{4BF}{YZ \cdot W_\text{ici}} + \frac{2BD}{2X \cdot W_\text{ici}} = \frac{2BD}{X \cdot W_\text{ici}} + \frac{4BF}{YZ \cdot W_\text{ici}} \end{align*}$$其中我们注意到 AllReduce 开销翻倍,且按操作所跨的轴数缩放通信。假设我们能自由选择拓扑且 $F=4D$(如 LLaMA-2),通过基本微积分可证 $X$、$Y$、$Z$ 的最优值为 $X = \sqrt{N / 8}$、$YZ = \sqrt{8N}$,从而总通信为:
$$T_\text{2D comms} = \frac{2B}{W_\text{ici}} \left(\frac{D}{X} + \frac{8D}{YZ}\right) = \frac{\sqrt{128} BD}{\sqrt{N} \cdot W_\text{ici}} \approx \frac{11.3 BD}{\sqrt{N} \cdot W_\text{ici}}$$首先,按上面照搬,普通 1D 模型并行有 $T_\text{model parallel comms} = 4BD / (3 \cdot W_\text{ici})$,那么新通信何时更小?我们有:
$$\begin{align*} T_\text{model parallel comms} > T_\text{2D comms} \iff \frac{4BD}{3 \cdot W_\text{ici}} > \frac{\sqrt{128} BD}{\sqrt{N} \cdot W_\text{ici}} \\ \iff N > 128 \cdot \left(\frac{3}{4}\right)^2 = 81 \end{align*}$$对一般的 $F$,我们声称该条件是:
$$N > 32 \cdot \left(\frac{F}{D}\right) \cdot \left(\frac{3}{4}\right)^2$$也就是说,如果芯片数超过 81,用这种新方案更好。这个结果有点奇怪,因为我们通常发现自己在大约 ~20 路张量并行时就已 ICI bound。但这里即便我们 communication-bound,总通信仍随总芯片数下降!这告诉我们可以继续增加芯片、增大 batch size、做更多参数扩展,并看到延迟降低。
附录#
附录 A:batch size > 240 这条规则有多真实?#
上面给出的简单规则——batch size 必须超过 240 token 才 compute-bound——大致正确,但忽略了 TPU 在其它操作未占满 HBM 时(例如做设备间通信时)预取权重的能力。
下面是一个小型 Transformer(dmodel 8192、dff 32768、每层只有 2 次 matmul)的层时长(微秒)实测图。来自这个 Colab notebook。可以看到步时在 batch 240 之前增长非常缓慢,之后线性增长。

下面是实际吞吐(tokens / us)。这就把论点表达得很清楚。由于这一层这里 4 路分片下约 600M 参数,最低延迟应在 365us 左右。
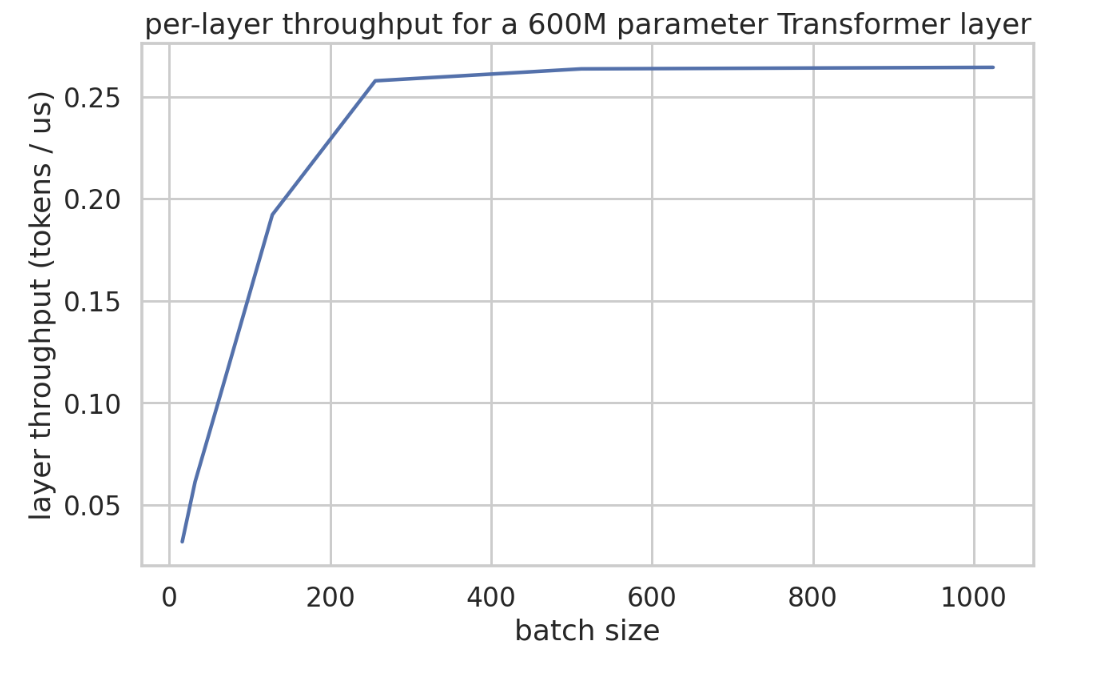
至少在这个模型上,吞吐确实在每数据并行分片 BS240 左右之前都还在增长。
附录 B:2D Weight Stationary 分片#
随着拓扑变大,如果我们能用上更高维 mesh(比如 TPU 那种),可以引入第二个分片轴进一步细化。我们称之为 “2D Weight Sharding”,更详细的描述见 Efficiently Scaling Transformer Inference 论文。
由于 Megatron 中只对隐藏维 $F$ 分片,1D 分片下随着芯片数变大,它会变得显著小于 $E$(即 $d_\text{model}$ 维)。这意味着大 batch 下,把一部分 collective 在 MLP 第一层之后沿隐藏维做更经济。
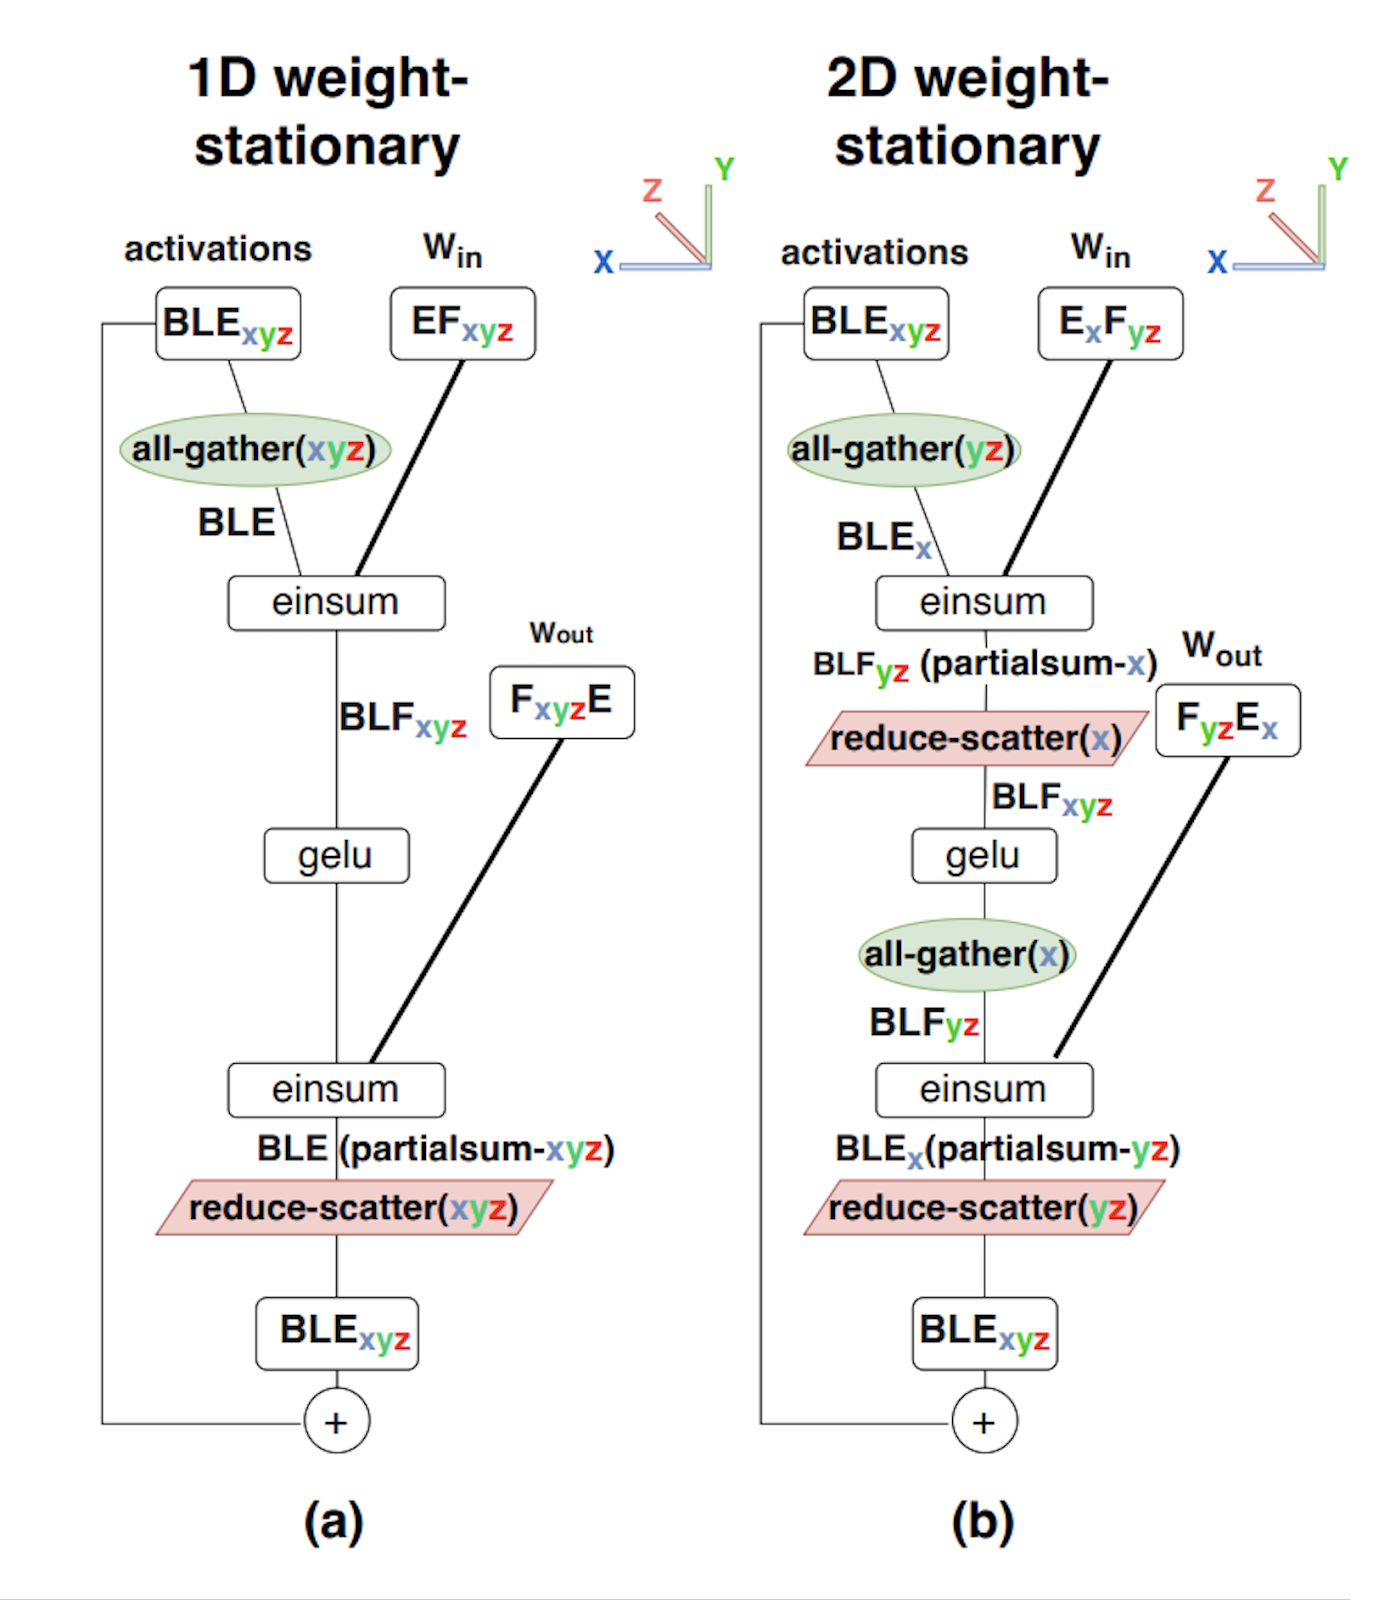
此图展示:
- 1D weight-stationary 分片,即纯 Megatron 分片,激活在 AllGather 后完全复制,权重沿隐藏 F 维完全分片。
- 2D weight stationary 分片,权重沿隐藏 F 与 reduction E 两维分片,激活沿 E 维分片。我们在第一层前对 (yz) 轴做 AllGather,之后对 (x) 轴做 ReduceScatter。
对注意力层,Megatron 风格分片在芯片数较少时也相对简单。但 Megatron 沿 $n_\text{heads}$ 维进行,这对可分片量设了上限。把 2D 分片改造给注意力(不沿隐藏维而沿 $n_\text{heads}$ 维分片),我们就获得了进一步扩展的能力。
附录 C:受延迟限制的通信#
回顾一下,Section 3 中我们推导了在 1D ring 上、X 张芯片、单链路全双工带宽 WICI、延迟 Tmin 的情况下,对每张 TPU 大小为 B 的张量做 AllGather 所需时间:
$$T_{total} = \max\left(\frac{T_{min} \cdot |X|}{2}, \frac{B}{W_{ICI}}\right)$$对大的 B,总时间相对恒定,因为往系统加芯片时,需要搬运的数据量与可用总带宽同时变大。
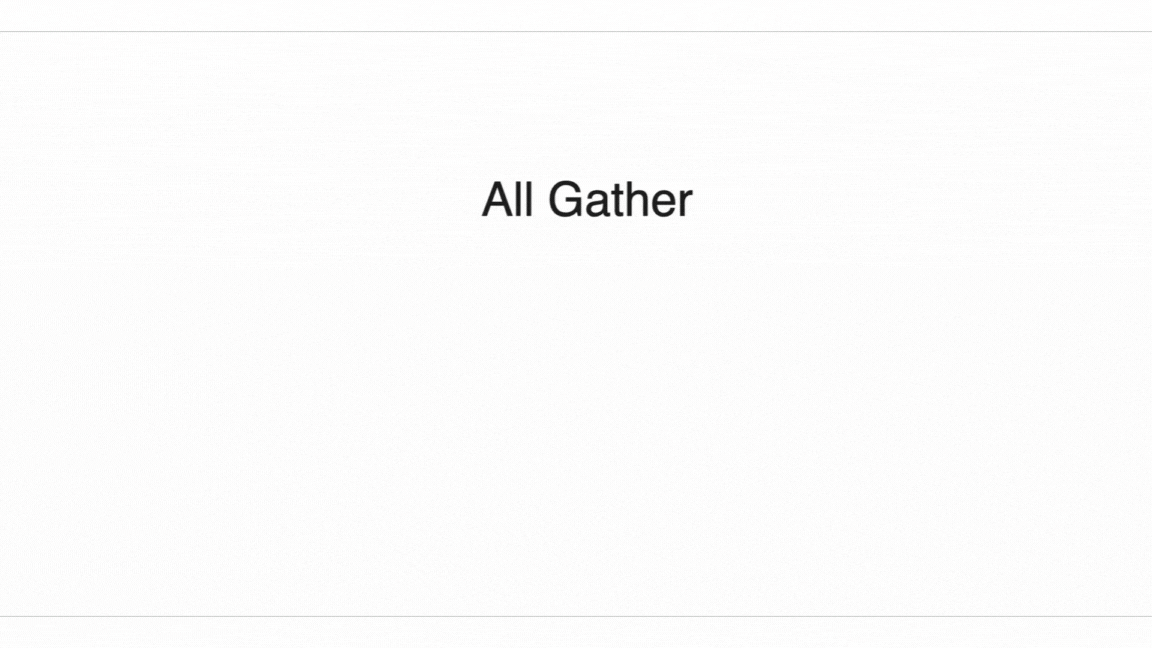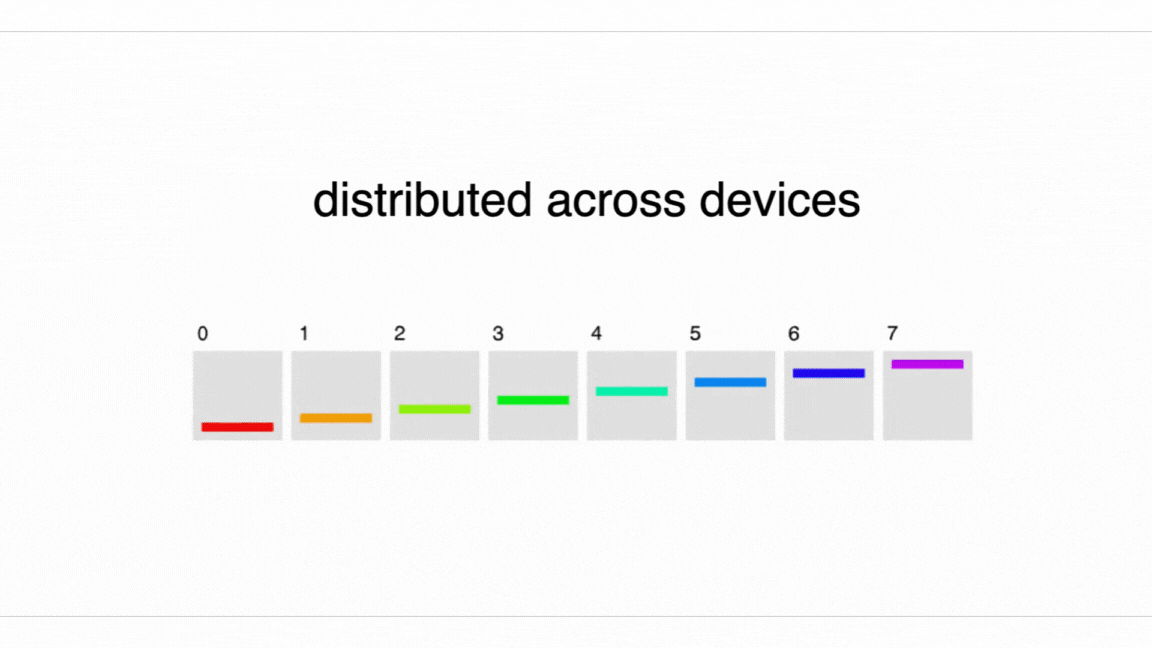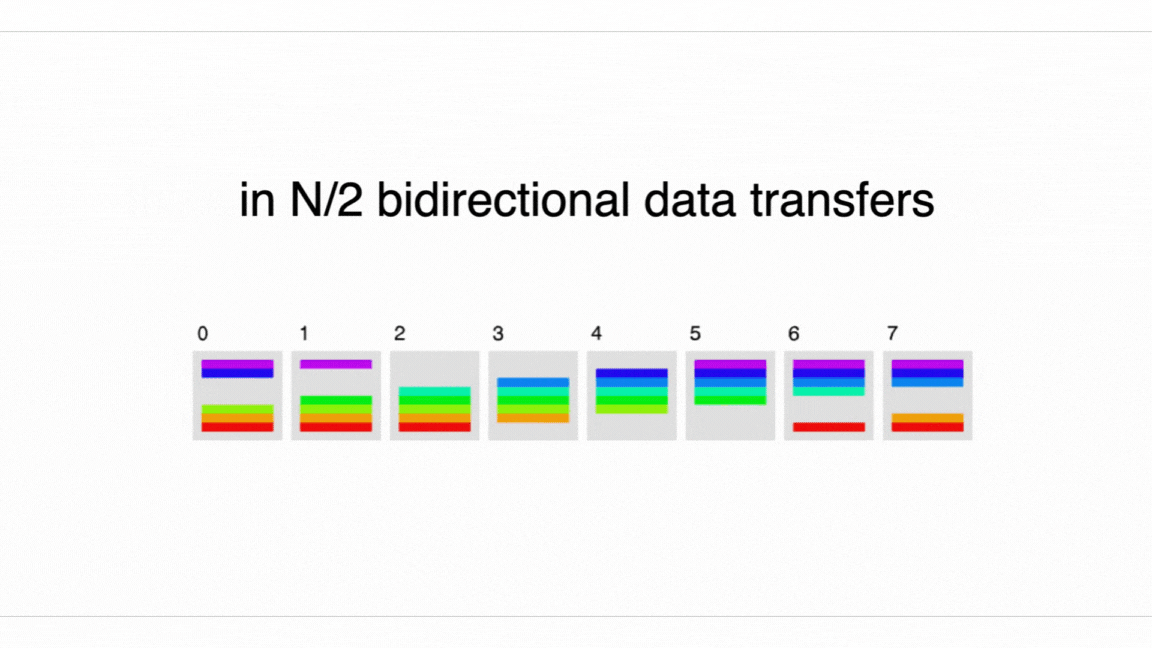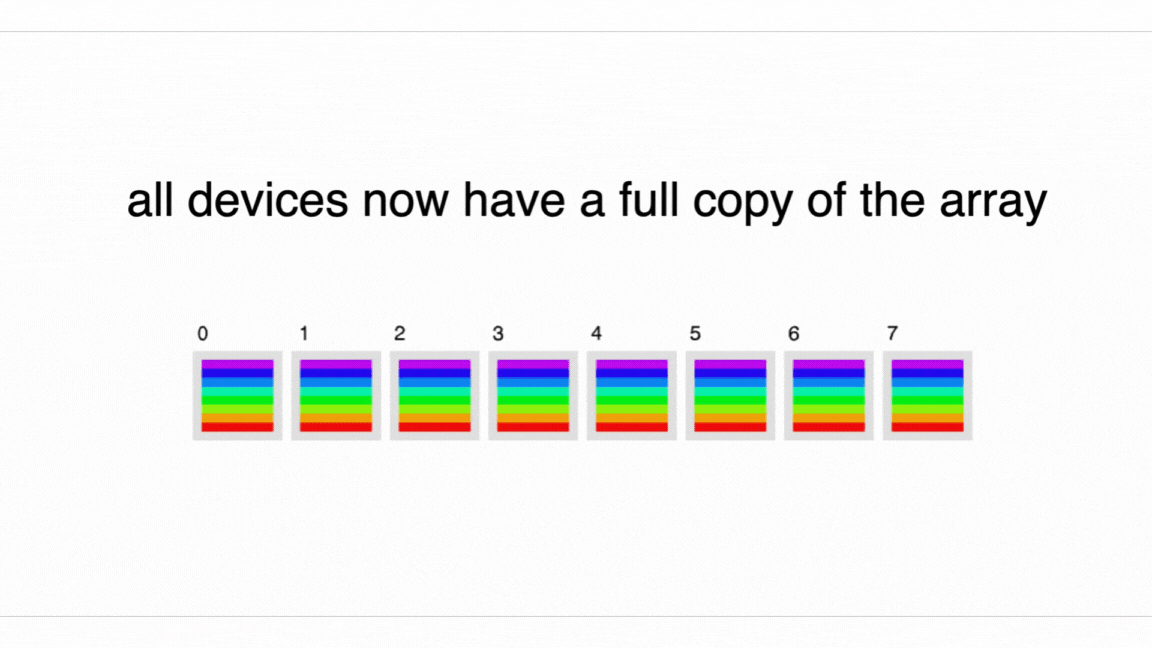
由于延迟优化推理中要搬运的数据量较小,激活上的 collective 常常被延迟项主导(尤其小 batch 下)。可以通过数完成所需的"跳数"轻松估算延迟。
在 TPU 上,如果通信中依赖张量大小的部分小于每跳 1 微秒(一跳是相邻两台设备间的通信),我们可能会被分发 collective 的固定开销卡住。在 ICI 单向带宽 4.5e10 下,ICI 通信变为延迟 bound 的条件是:$(\text{bytes} / n_\text{shards}) / 4.5e10 < 1e-6$。对 8 路 Megatron 分片,这就是 buffer_size < 360kB。这在推理时实际上不算小: 在 BS=16、D=8192 的 int8 下,激活会用 16*8192=131kB,我们已经是延迟 bound 的了。
要点: 通信变延迟 bound 的条件是 $\text{total bytes} < W_{ICI} \times 1e-6$。例如,沿 $Y$ 做模型并行时,int8 下当 $Y > BD / 45,000$ 时变延迟 bound。
这里能与计算 roofline 类比——我们都在为某些小操作付出固定成本(通信的延迟,matmul 的内存带宽)。
附录 D:Speculative Sampling#
当我们_真的_关心端到端延迟时,还有一个额外技巧叫 speculative sampling。回顾一下,我们通常对大型 Transformer 一次生成一个 token:
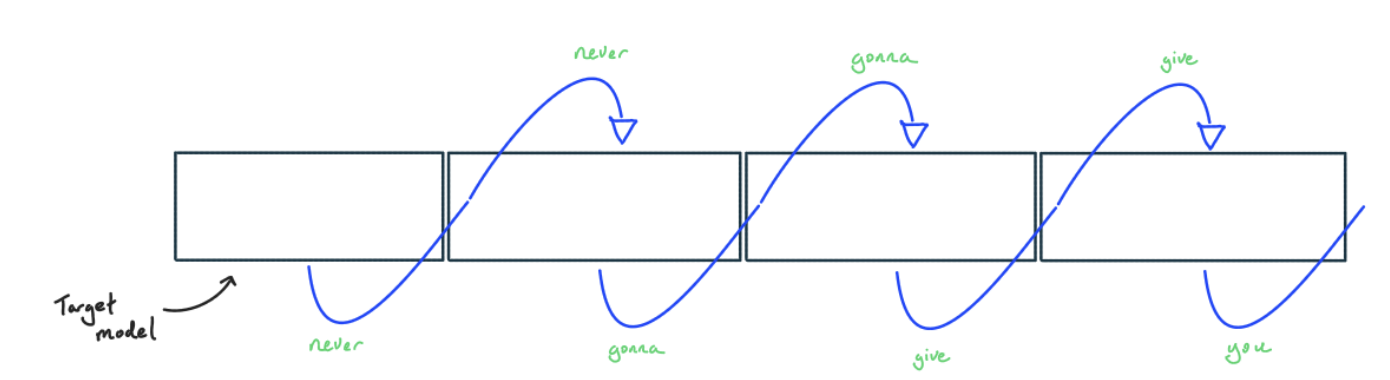
借助 speculative sampling,我们用一个更小、更便宜的模型生成 token,再用大模型核对结果。最容易理解是_贪心解码_情况:
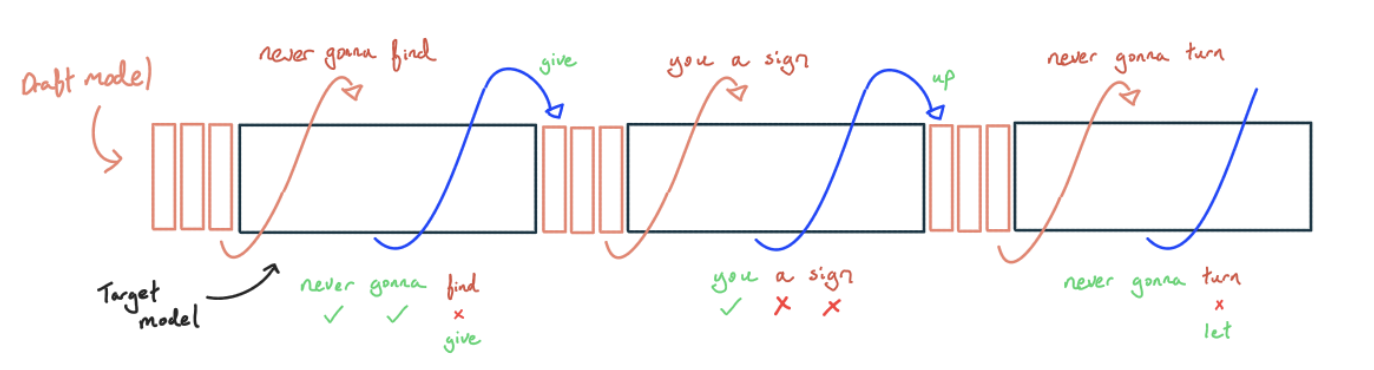
- 我们从一个更小、更便宜的模型贪心采样。理想上用一个被训练成与大模型匹配的小模型(如蒸馏得到),但也可以简单到用 n-gram 或在小语料上做 token 匹配。
- 在生成 K 个 token 之后,我们用大模型对这一路所有 token 计算下一 token 的 logits。
- 由于贪心解码,我们只需检查小模型生成的 token 是否在所有可能 token 中概率最高。如果某个 token 错了,就取最长的正确前缀,把第一个错 token 替换为正确 token,然后回到 (1)。如果全部都对,就用最后一个正确 logit 多采一个 token,再回到 (1)。
为什么这是延迟收益? 这套方案对每个 token 仍要做相当于一次大模型前向的 FLOPs,但因为可以把一堆 token batch 起来,在一次前向中做完所有这些 FLOPs,并利用我们_未受 compute 限制_的事实免费多打几个 token。
每个被接受的 token 平均下来 FLOPs 会更贵(因为有些会被拒,且我们要调用 draft 模型),但我们从硬件中榨出更多 FLOPs,且小模型便宜,所以总体上仍是赢。我们也跨多步共享 KV cache 加载,所以 speculative decoding 在长上下文下也可能是吞吐收益。 由于一切都被大模型核对过,我们完全没改变采样分布(虽然非贪心情况下具体轨迹会不同)。
传统上,speculative decoding 依赖于存在一个采样分布与目标模型类似的较小模型,例如 LLaMA-2 70B 用 LLaMA-2 2B,而这往往不存在。即便有,若接受率低,小 drafter 也会过于昂贵。替代方案是把 drafter 嵌入主模型中,例如在基模型某个较后层加专门的 drafter head。由于这个 head 与主模型共享大部分参数,它跑得快、采样分布也更贴近。
对正常自回归采样,token/s 等于步时。我们仍要遵循前面算术强度一节给出的理论最低步时(事实上 Speculative Sampling 步时通常比正常自回归采样还慢,但因为平均每步出超过 1 个 token,我们能获得高得多的 tokens/s)。
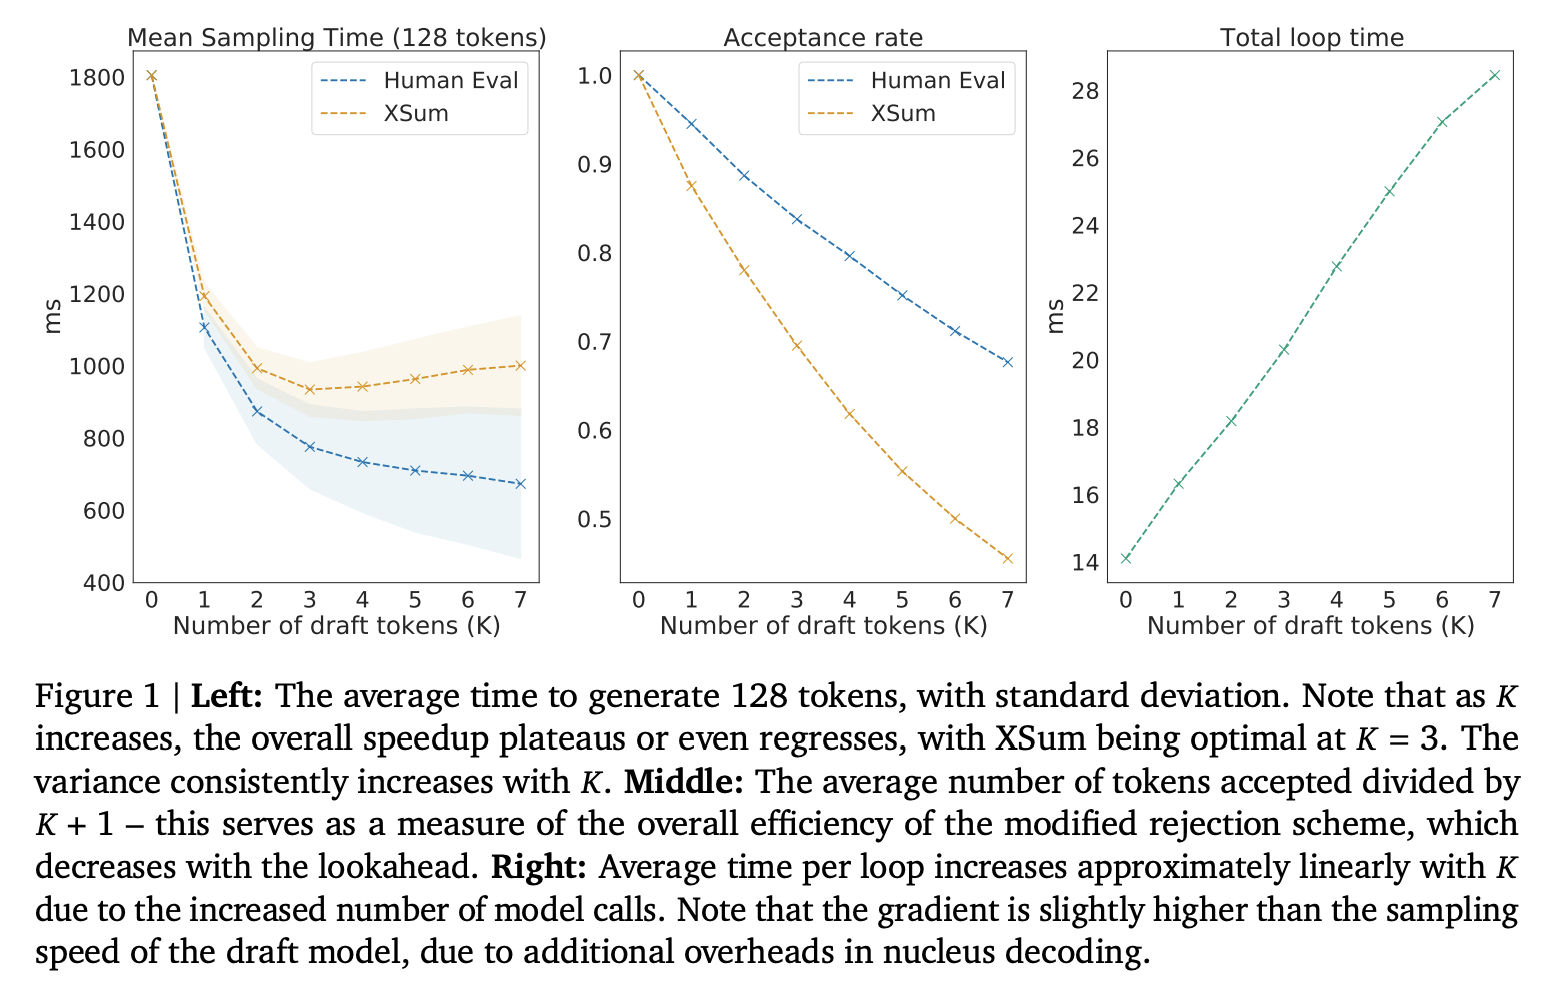
图: 此图展示 Chinchilla(DeepMind 的 70B 模型)配 4B 参数 drafter(小模型)的每步延迟与 speculation 成功率。对 XSum(自然语言数据集),最优 speculation 步数约为 3-4;HumanEval(编程数据集)更可预测,更激进的 speculation 收益更大。
非贪心解码下怎么做? 这要复杂一些,但本质上归结为一个 Metropolis-Hastings 启发式算法:从 logits 推出 $P_{\text{draft model}}(\text{chosen token})$ 与 $P_{\text{target model}}(\text{chosen token})$,按概率比小于某阈值时概率性地拒绝所选 token。
要点: Speculative sampling 是又一个用吞吐换更佳每 token 延迟的强力手段。在 batch size 受限(小硬件占用或大 KV cache)的情况下,它会成为双赢。
引用#
学术引用请用:
Austin et al., "How to Scale Your Model", Google DeepMind, online, 2025.或 BibTeX:
@article{scaling-book,
  title = {How to Scale Your Model},
  author = {Austin, Jacob and Douglas, Sholto and Frostig, Roy and Levskaya, Anselm and Chen, Charlie and Vikram, Sharad
  and Lebron, Federico and Choy, Peter and Ramasesh, Vinay and Webson, Albert and Pope, Reiner},
  publisher = {Google DeepMind},
  howpublished = {Online},
  note = {Retrieved from https://jax-ml.github.io/scaling-book/},
  year = {2025}
}