在 TPU 上训练 LLaMA 3(Training LLaMA 3 on TPUs)#
《How To Scale Your Model》第 6 部分(第 5 部分:Training | 第 7 部分:Inference)
让我们仔细看看,如何运用前几节学到的知识,在 TPU v5p 上训练 LLaMA 3 模型。它们有多大?不同配置下的训练成本是多少?它们如何分片(sharded)?让我们做一些纸面估算(back-of-the-envelope estimates),看看前面几节的内容如何映射到真实模型上。
目录(Contents)
本节的目标是把前一节的结论应用到一个非常实际的问题上:训练 LLaMA 3 系列(herd)模型。与前面几节不同,我们希望你能亲自动手做大量练习。为此,我们隐藏了每一节的答案,方便你先尝试自己作答。试着拿起笔,亲手算一算!
LLaMA 3 长什么样?(What does LLaMA 3 look like?)#
LLaMA-3 模型家族包含 3 个主要模型:LLaMA 3 8B、70B 和 405B。我们主要聚焦于 70B,把 8B 和 405B 留给你在末尾的习题部分探索。下面是 LLaMA 3-70B 的架构,取自 LLaMA 的 HuggingFace 页面。
| 超参数(hyperparam) | 取值(value) |
|---|---|
| $n_\text{layers}$ (L) | 80 |
| $d_\text{model}$ (D) | 8,192 |
| $d_{ff}$ (F) | 28,672 |
| $n_\text{heads}$ (N) | 64 |
| $n_\text{kv_heads}$ (K) | 8 |
| $d_\text{qkv}$ (H) | 128 |
| $n_\text{embeddings}$ (V) | 128,256 |
为了说明这些信息有多容易找到,下面就是 config 本身,并附上对应关系:
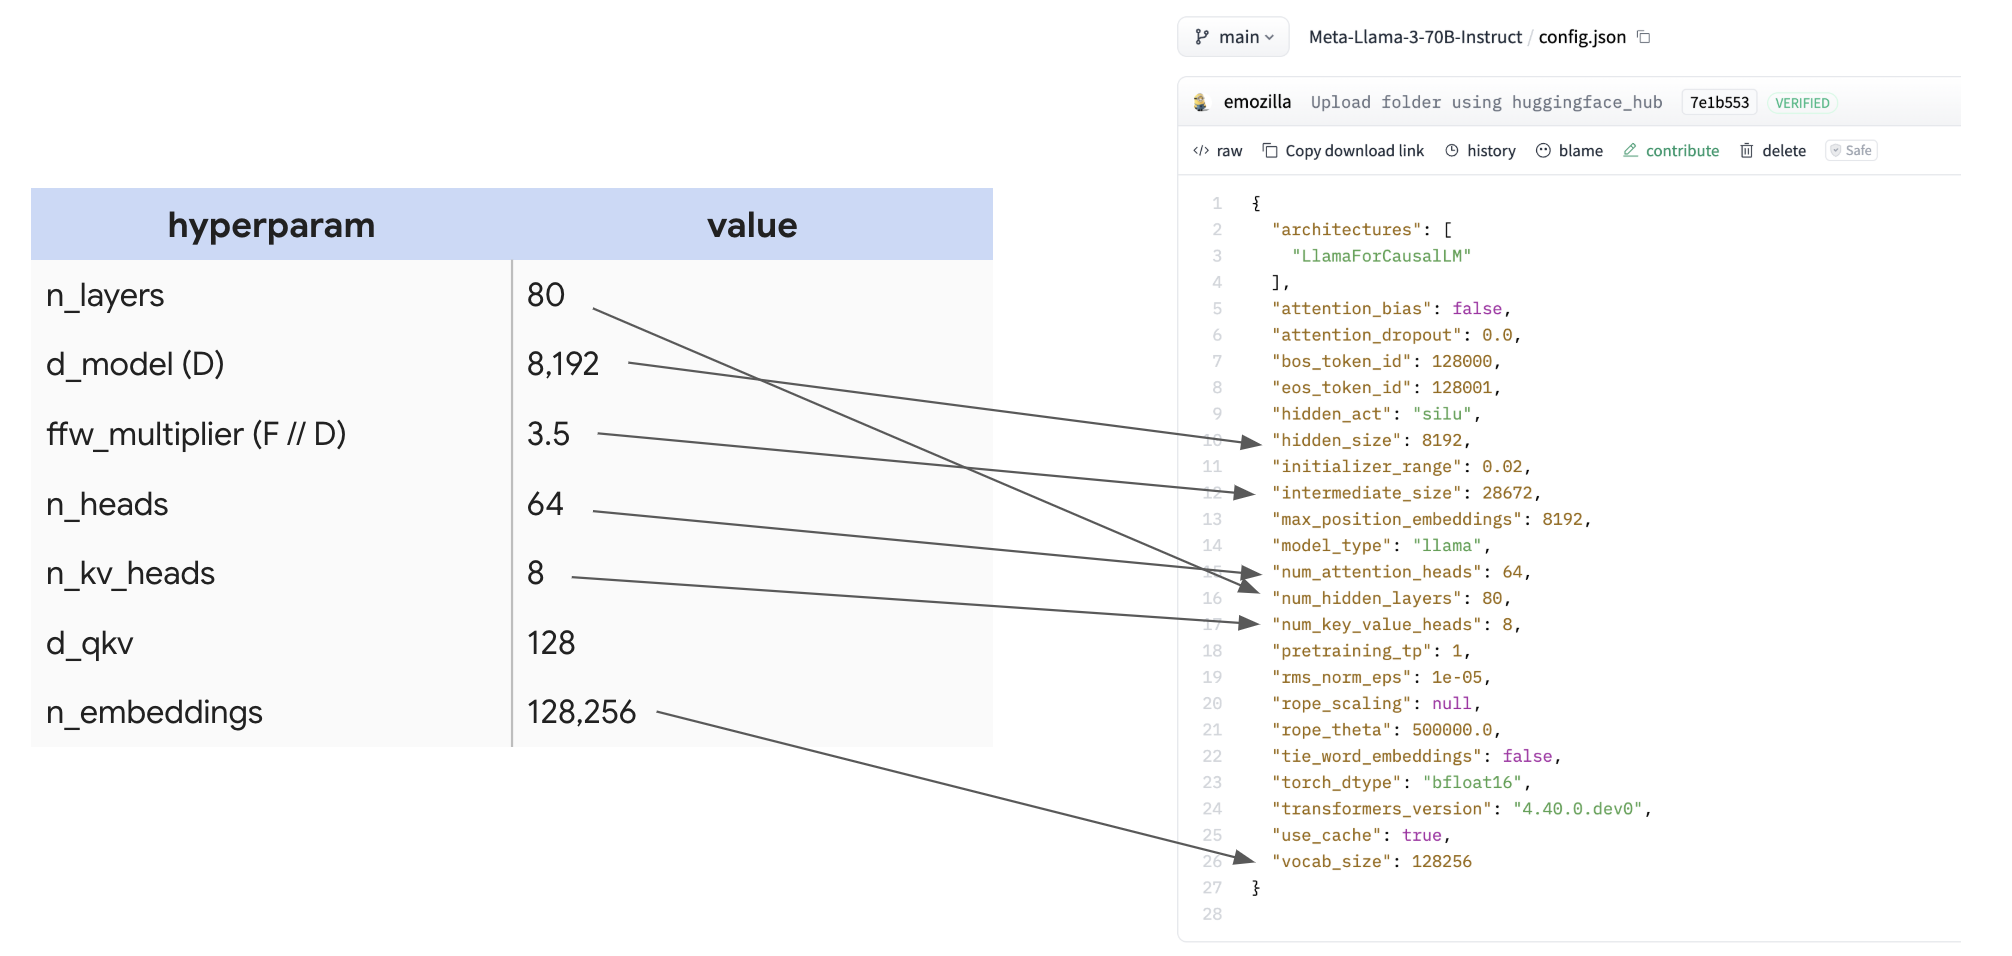
为很多不同的开源 LLM 制作一张这样的大表格非常有用,方便你快速对比它们各自的设计决策。
计算参数量与 FLOPs(Counting parameters and FLOPs)#
问题:根据这张表,我们能算出 LLaMA 3-70B 的参数量吗?🤫 让我们应用第 4 节的内容,看看能否得到 70B!
| 参数 | 公式 | 数量 |
|---|---|---|
| FFW 参数 | d_model * d_ff * 3(对应 SwiGLU 的 gate、up 和 down 投影) * n_layers | 8,192 * 8,192 * 3.5 * 3 * 80 = 56.3e9 |
| 词表参数(Vocab params) | 2(输入和输出 embedding) * n_embeddings * d_model | 2 * 128,256 * 8,192 = 2.1e9 |
| 注意力参数(Attention params) | n_layers * \[ 2(对应 q embedding 与拼接后的 output 投影) \* d\_model \* n\_heads \* d\_qkv + 2(对应 k 和 v) \* d\_model \* n\_kv\_heads \* d\_qkv\] | 80 * (2 * 8,192 * 64 * 128 + 2 * 8,192 * 8 * 128) = 12e9 |
| 56.3e9 + 2.1e9 + 12e9 = 70.4e9 |
太棒了!我们得到了预期的数字。你会注意到,不出所料,FFW 参数完全主导了整体参数量,尽管注意力部分也不可忽略。
要点(Takeaway):MLP 块中的 3 个大权重矩阵远远大于 Transformer 中所有其他数组,因此在推理模型显存或 FLOPs 时,我们几乎可以忽略所有其他参数。对 LLaMA 3-70B 而言,这 3 个矩阵在 70B 参数中占了 56B。
接下来看看 FLOPs!回顾第 4 节中关于训练的一般规则。
问题:LLaMA-3 在每个训练步、每个 token 上要执行多少 FLOPs?这能帮我们确定整个训练过程的开销。
想清楚后,点这里查看答案!
答案:如第 4 节所示,每个 token 大约要做 $6 \cdot \text{param count}$ 次 FLOPs,因此这里大约是 6 * 70e9 = 4.2e11 FLOPs/token。也就是每 token 每步大约半个 TFLOP。假设我们是计算受限(compute-bound)的,并且达到完美的 FLOPs 利用率,那么在单个 TPU v5p 芯片上大约需要 4.2e11 / 4.59E+14 = 1ms。
问题:LLaMA 3 大约在 15 万亿(trillion)token 上进行训练。总共多少 FLOPs?
想清楚后,点这里查看答案!
答案:这很简单,就是 4.2e11 * 15e12 = 6.3e24 FLOPs。6.3 yottaFLOPs。这数字很大!在单个 TPU 上,这需要 6.3e24 / 4.59E+14 = 435 年。这也很多!
问题:假设我们想在一个完整的 TPU v5p pod 上训练,规模是 16x20x28 = 8960 个芯片。在 bfloat16、40% MFU 下,假设是计算受限,需要训练多久?
想清楚后,点这里查看答案!
答案:我们知道每个 TPU v5p 每秒可执行 4.59e14 FLOPs。在 40% MFU 下,大约需要 T = 6.3e24 / (8960 * 4.59e14 * 0.4) = 3.8e6 秒。这大约是 44 天! 假设我们真的能达到 40% MFU,这是相当合理的。
问题:LLaMA 3-70B 预训练时使用了大约 4M token 的批次大小(batch size)。要支持这个 batch size,至少需要多少 TPU?你可以假设参数为 bfloat16,优化器状态(optimizer state)为 float32,并且每层做 4 次梯度检查点(gradient checkpoint)。
想清楚后,点这里查看答案!
答案:这个问题主要关心显存占用,因为这是可用算力上唯一的硬约束。训练时,HBM 主要有三种用途:模型参数、优化器状态、梯度检查点。如果我们假设 bfloat16 权重、float32 优化器状态,以及一个非常保守的梯度检查点方案(每层 4 次),那么:
| 参数(Params) | 2 * 70GB | ~140GB |
| 优化器状态(Optimizer State) | 8 * 70GB | ~560GB |
| 梯度检查点(Gradient Checkpoints) | 2 * 8192 * 4e6 * 4 * 80 | ~20.9TB |
| 总计(Total) | ~21.6TB |
总计大约是 21.6TB。你会注意到,即使采用非常保守的检查点方案,梯度检查点也强烈主导了显存图景。我们技术上可以做到每层 1 个检查点,或者使用 microbatching,但这是个合理的画面。在这些假设下,由于每个 TPU v5p 有 96GB HBM,我们需要 21.6e12 / 96e9 = 225 个 TPU。其实并不多!
那为什么我们不这样做呢? 因为这样训练需要 44 天 * 8960 / 225 = 1752 天。也就是接近 4 年。太久了。 但这清楚地表明,我们使用这些大集群并不是因为受限于显存,而是因为我们需要更多的 FLOPs。
问题:在与上一题相同的假设下,如果使用 8960 个 TPU v5p 芯片,每芯片会用多少显存?
想清楚后,点这里查看答案!
答案:总显存仍是约 21.6TB,所以平均每芯片大约是 2.4GB,基本可以忽略。即使采用更激进的检查点策略,比如每层 12 个检查点,每芯片也只占 8GB。在这种规模下训练,我们离显存瓶颈还差得远。
要点(Takeaways):技术上,即使在很小的拓扑(topology)上,也可以训练非常大的模型,但代价是会很慢。能够计算训练总 FLOPs,让我们能在已知拓扑和适度 MFU 的假设下,估算训练时间的数量级。
如何为训练对 LLaMA 3-70B 进行分片(How to shard LLaMA 3-70B for training)#
让我们继续上面的设定:在一个由 8960 个芯片组成的 TPU v5p pod 上,以 4M token 的批次大小(每批 1024 条长度为 4096 的序列)训练 LLaMA 3-70B。我们来讨论这个模型最好的分片策略是什么。
问题:在上述假设下,仅靠 FSDP 能训练这个模型吗?先假设我们不能做任何序列/上下文并行(sequence/context parallelism)。这应该是你想到的第一个方案,因为它简单,而且如果可行就不会引入额外通信。
想清楚后,点这里查看答案!
答案:这个回答会有点较真。如上所述,LLaMA 3-70B 最初使用 4K 长度的序列训练,所以 4M token 的 batch size 对应序列批次大小为 1024。也就是说,纯数据并行/FSDP 真正能扩展到的极限是 1024 个芯片,因为我们只有这么多序列可以做数据并行。所以在严格意义上的"完全数据并行且无额外通信"下,答案是不能。下一个问题会回答这个问题的稍宽松版本。
问题:放宽不做序列分片的限制。如果允许我们在 batch 和 序列轴上都做 FSDP,那么在 8960 个芯片上仅靠 FSDP 能训练 LLaMA 3-70B 吗?
想清楚后,点这里查看答案!
答案:现在我们也允许做序列/上下文并行了,可以扩展得多得多。先算每设备的 batch size:如果做 8960 路的 FSDP,每 TPU 的 batch size 就是 4 * 1024 * 1024 / 8960 = 468 tokens。我们从上一节知道,当 $\text{每设备 batch size} < 2550 / M_X$ 时,FSDP 会受 ICI 限制。由于在完整的 3D pod 上我们可以专门动用 3 个轴,下界是 850,而我们远远低于这个值。所以答案是:即便用 3 个轴也不行。我们会被通信牢牢卡住。
问题:现在来看张量并行(tensor parallelism)和 FSDP 的混合方案。是否存在某种组合,让我们仍然保持计算受限?如果有,应该用多少 FSDP 和多少张量并行?
想清楚后,点这里查看答案!
答案:先确认这是否能行。我们知道,当每芯片 batch size 小于 $2550^2 / 2F = 113$ 时,会变成通信受限。如上所示,我们略高于这个值。很好!接下来挑选最优的 FSDP 数量,可以用公式
$$X_{opt} = \sqrt{\frac{2BN}{F}} = \sqrt{\frac{2 \cdot 4.19e6 \cdot 8960}{28672}} = 1618$$向上取整到合理的 2 的倍数,大致就是 2048 路 FSDP 加 4 路张量并行。这应该效果很好!
要点(Takeaways):我们可以在一个完整的 TPU v5p pod 上以 4M token 批次大小训练 LLaMA-3,方法是混合数据并行(1024 路)、序列并行(2 路)和张量并行(4 路),并且不会被通信限制。如果尝试纯 FSDP,或 FSDP + 序列并行,都会被通信卡住。我们在前一节推导出的公式非常实用。
实战习题(Worked Problems)#
问题 1 \[把 LLaMA 70B 扩展到更多芯片\]:假设我们想在 4 个 pod 上以相同 batch size 训练 LLaMA 3-70B。会用什么并行方案?是计算受限还是通信受限?大概要训练多久?务必使用正确的 roofline 上界。
问题 2 \[LLaMA 405B\]:
(a) 利用 LLaMA 3-405B 的 config,写一张如上格式的关键超参表格。这个模型总参数量是多少?每个训练步多少 FLOPs?训练 15T token 总共多少 FLOPs?
(b) 假设我们想在 8 个 TPU v5p pod 上训练。会用什么并行方案?训练多久?是计算受限还是通信受限?
第 6 节到此结束。第 7 节关于 Transformer 推理(inference),点这里。
杂项(Miscellaneous)#
*工作完成于 Google DeepMind,作者现在 MatX。
引用(Citation)#
学术语境下的引用,请使用:
Austin et al., "How to Scale Your Model", Google DeepMind, online, 2025.或 BibTeX 条目:
@article{scaling-book,
  title = {How to Scale Your Model},
  author = {Austin, Jacob and Douglas, Sholto and Frostig, Roy and Levskaya, Anselm and Chen, Charlie and Vikram, Sharad
  and Lebron, Federico and Choy, Peter and Ramasesh, Vinay and Webson, Albert and Pope, Reiner},
  publisher = {Google DeepMind},
  howpublished = {Online},
  note = {Retrieved from https://jax-ml.github.io/scaling-book/},
  year = {2025}
}