Sharded Matrices and How to Multiply Them(分片矩阵及其乘法)#
本节是 How To Scale Your Model 的第 3 部分(第 2 部分:TPUs | 第 4 部分:Transformer Math)。
当我们训练大型 ML 模型时,必须把它们的参数或输入跨多个加速器进行拆分(即"分片",shard)。由于 LLM 主要由矩阵乘法组成,理解这一切归根结底就是理解:当矩阵被分散到多个设备上时,应该如何相乘。我们基于 TPU 通信原语(communication primitives)的代价,发展出一套简单的分片矩阵乘法理论。
目录
- Partitioning Notation and Collective Operations(分区记号与集合操作)
- Computation With Sharded Arrays(分片数组的计算)
- Case 1: neither multiplicand has a sharded contracting dimension(情形 1:两个被乘数的收缩维度都未分片)
- Case 2: one multiplicand has a sharded contracting dimension(情形 2:一个被乘数的收缩维度被分片)
- Case 3: both multiplicands have sharded contracting dimensions(情形 3:两个被乘数的收缩维度都被分片)
- Case 4: both multiplicands have a non-contracting dimension sharded along the same axis(情形 4:两个被乘数的非收缩维度沿同一轴分片)
- A Deeper Dive into TPU Communication Primitives(深入 TPU 通信原语)
- What Have We Learned?(我们学到了什么?)
- Some Problems to Work(一些习题)
Partitioning Notation and Collective Operations(分区记号与集合操作)#
当我们在一万个 TPU 或 GPU 上训练 LLM 时,从抽象层面看,我们做的计算与在单卡上训练时是相同的。区别在于我们的数组放不进单个 TPU/GPU 的 HBM,所以必须把它们拆分。值得注意的是,我们也可能为了速度而并行化。即使能在更少芯片上装下,扩展到更多芯片也只会带来更多的 FLOPs/s。例如在推理时,我们有时能装在更小的拓扑上,但仍选择扩展到更大的拓扑以降低延迟。同样,训练时我们也常通过扩展到更多芯片来缩短 step time。我们把这种做法称为"分片"(sharding)或"分区"(partitioning)数组。扩展(scaling)的艺术,就是想清楚怎么分片我们的模型,让计算保持高效。
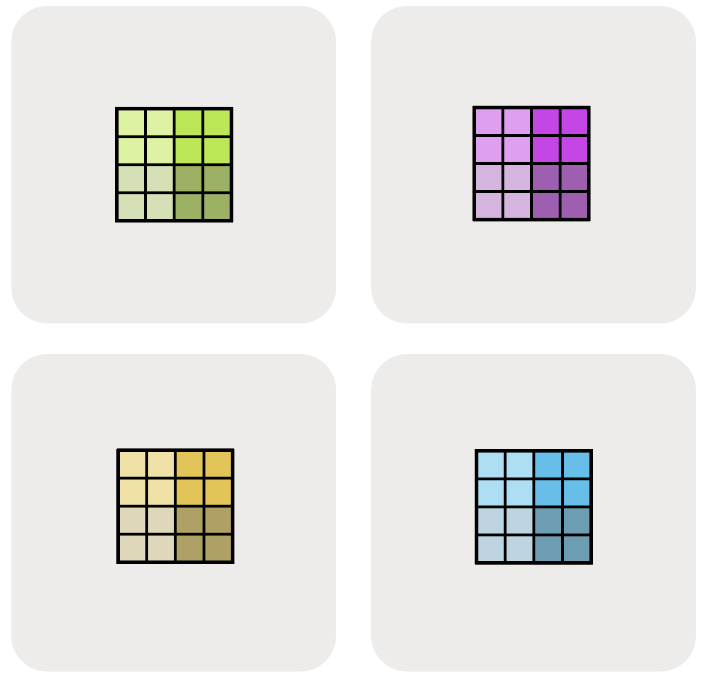
下面是一个跨 4 个 TPU 分片的 2D 数组 A 的示例:
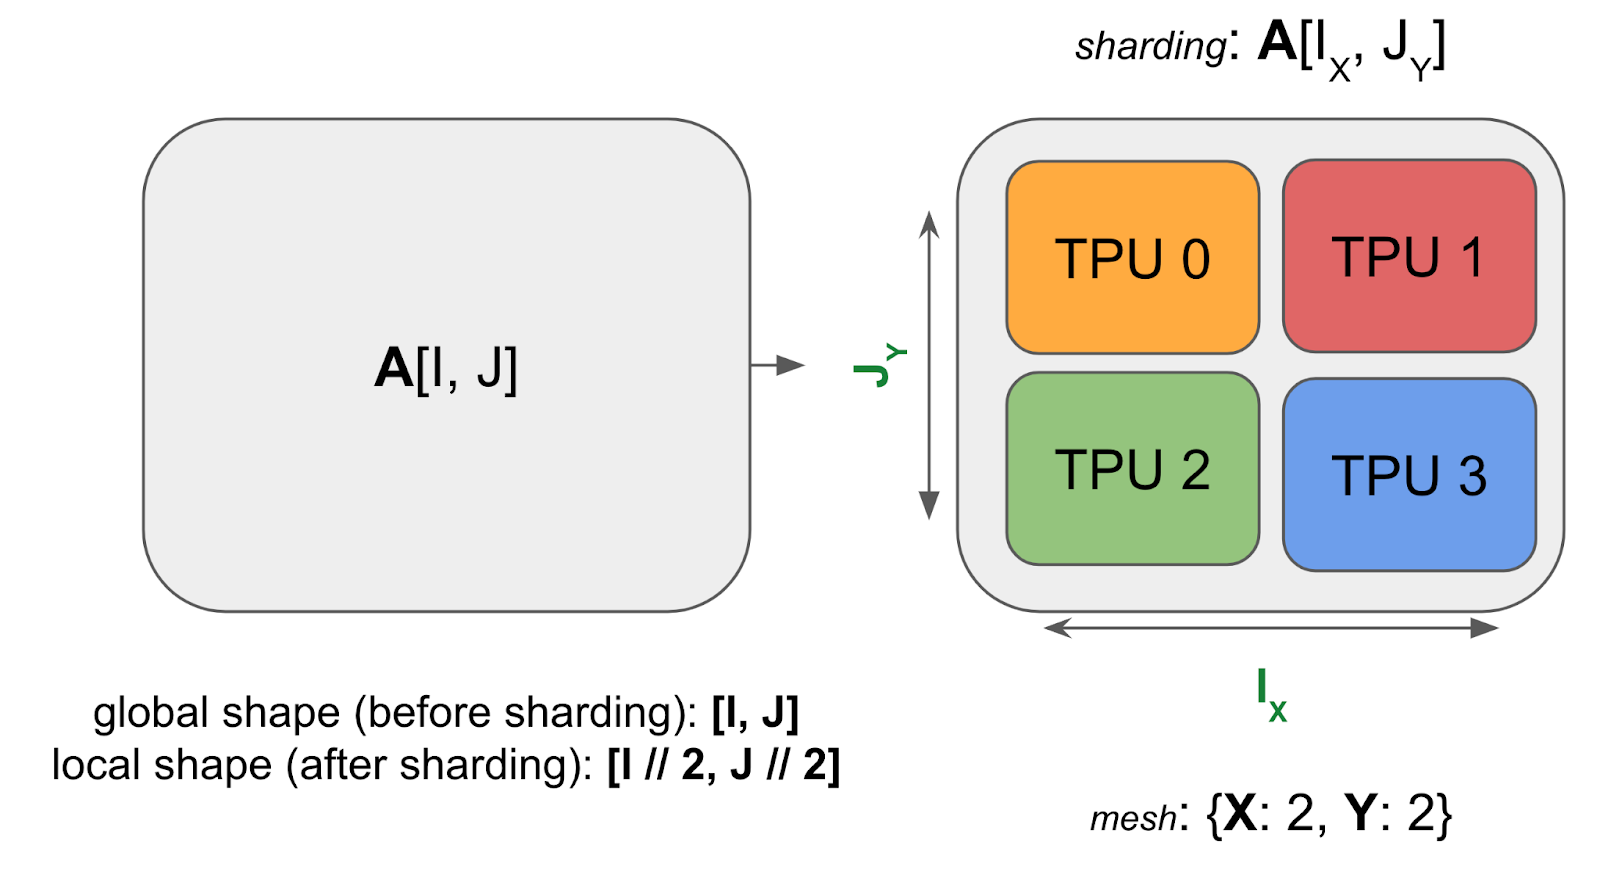
图: 一个形状为 A[I, J] 的示例数组被分片到 4 个设备上。两个维度都均匀地分片到 2 个设备上,分片记为 A[IX, JY]。每个 TPU 持有总内存的 1/4。
注意:分片后的数组仍然具有与未分片数组相同的_全局_或_逻辑形状_(logical shape),比如 (4, 128),但它还有一个_设备本地形状_(device local shape),比如 (2, 64),给出了每个 TPU 实际持有的字节大小(在上图中,每个 TPU 持有数组的 ¼)。下面我们将这一点推广到任意数组。
A unified notation for sharding(统一的分片记号)#
我们使用一种_命名轴记号_(named-axis notation)的变体,来描述张量是怎样以块的方式分片到各设备上的:我们假设存在一个 2D 或 3D 的设备网格(device mesh),每根轴都被赋予一个网格轴名(mesh axis name),比如 X、Y、Z。然后,我们就能通过描述数组的每个命名维度(named dimension)如何沿物理网格轴分区,来指定矩阵数据在设备网格上的布局。我们把这种指派称为一个分片(sharding)。
示例(上图):对应上图,我们有:
- Mesh: 上图中的设备网格
Mesh(devices=((0, 1), (2, 3)), axis_names=('X', 'Y')),告诉我们有 4 个 TPU 排成 2x2 网格,轴名为 $X$ 和 $Y$。 - Sharding: $A[I_X, J_Y]$,告诉我们将第一个轴 $I$ 沿网格轴 $X$ 分片,将第二个轴 $J$ 沿网格轴 $Y$ 分片。这个分片告诉我们:每片持有数组的 $1 / (\lvert X\rvert \cdot \lvert Y\rvert)$。
合起来看,我们知道数组的本地形状(即单个设备所持分片的大小)为 $(\lvert I\rvert / 2, \lvert J\rvert / 2)$,其中 $\lvert I\rvert$ 是 A 第一维的大小,$\lvert J\rvert$ 是 A 第二维的大小。
Pop Quiz [2D 沿 1 根轴分片]: 考虑一个数组 fp32[1024, 4096],分片为 $A[I_{XY}, J]$,网格为 {'X': 8, 'Y': 2}。每个设备持有多少数据?在 H100 上从 HBM 加载这个数组需要多长时间(假设每芯片内存带宽为 3.4e12)?
点击查看答案。
$A[I_{XY}, J]$ 把第一维(I)沿 X 与 Y 这两根硬件轴一起分片。本例中本地形状为 $(\lvert I\rvert /(\lvert X\rvert \cdot \lvert Y\rvert), \lvert J\rvert)$。本例的全局形状是 fp32[1024, 4096],所以本地形状是 fp32[64, 4096]。
由于每个 GPU 有 4 * 64 * 4096 = 1MiB 字节,所需时间约为 1e6 / 3.4e12 = 294ns,但由于数据量太小,实际开销可能因各种额外开销而大得多。
可视化这些分片: 让我们通过一个被切到 4 个设备上的 2D 数组来直观感受这些分片:
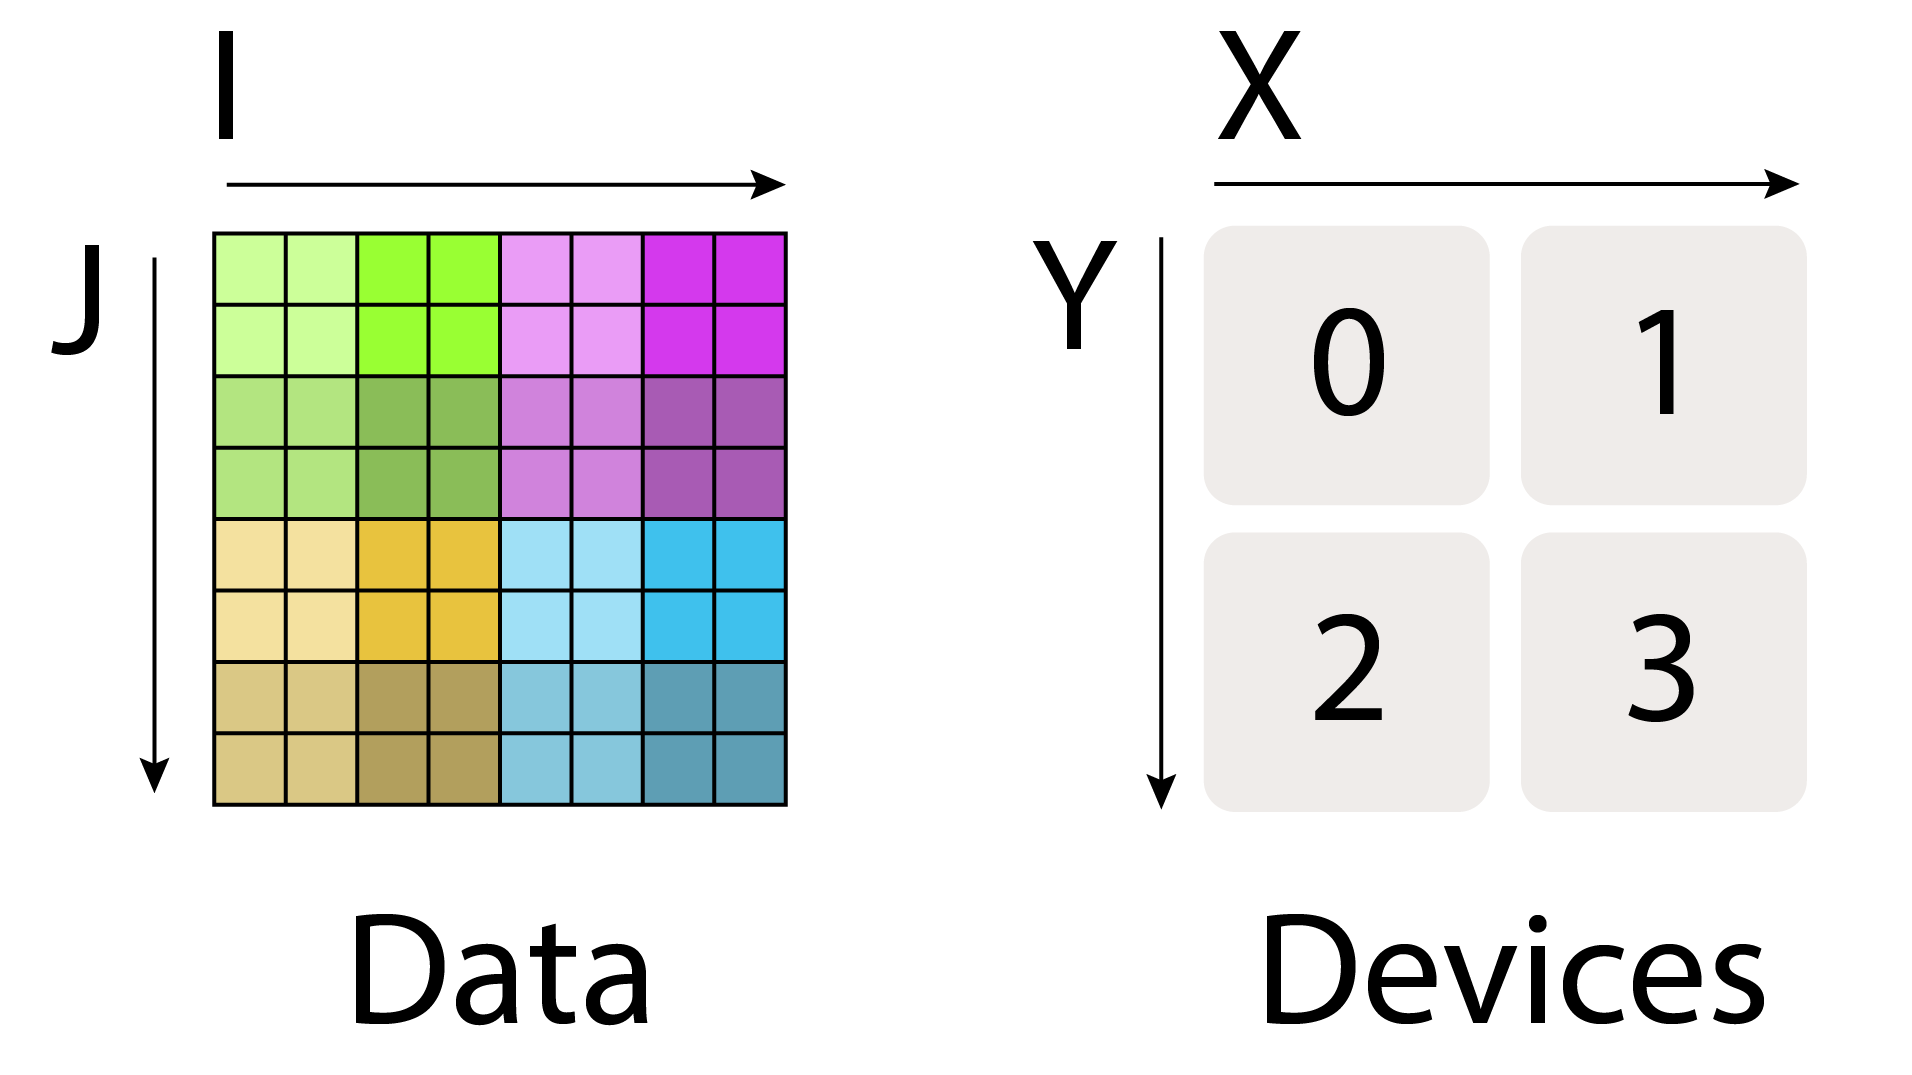
我们把矩阵的_完全复制_(fully-replicated)形式简单地写成 $A[I, J]$,没有分片指派。这意味着_每个_设备都持有整个矩阵的一份完整拷贝。
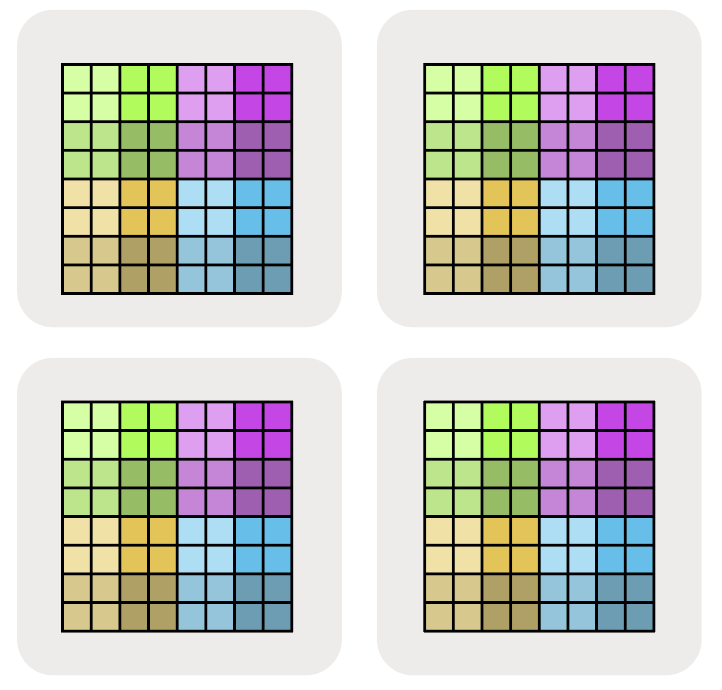
我们可以用一个网格轴下标来表示某个维度沿某根网格轴被分区。例如 $A[I_X, J]$ 表示 I 这个逻辑轴沿 X 网格维度被分区,但 J 维度_未_被分区,且这些块沿 Y 网格轴_部分复制_(partially-replicated)。
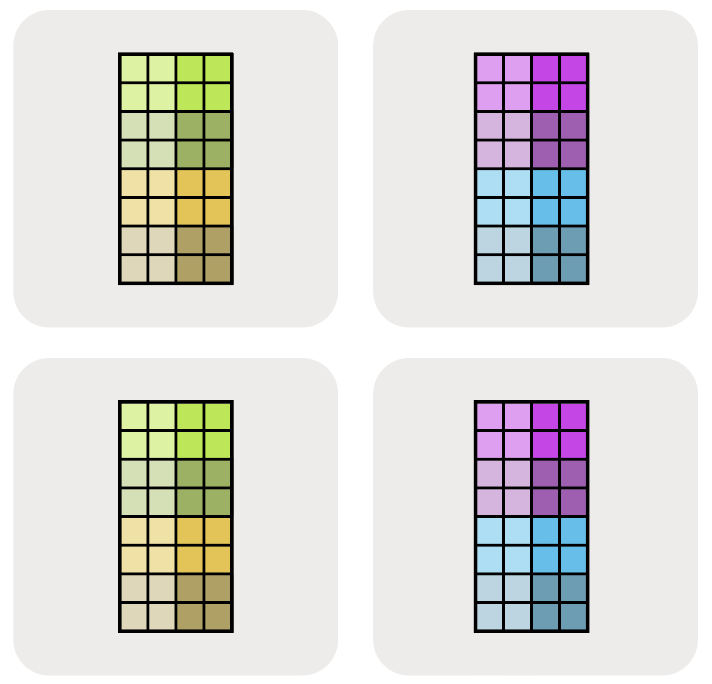
$A[I_X, J_Y]$ 表示 I 逻辑轴沿 X 网格轴被分区,且 J 维度沿 Y 网格轴被分区。
下图给出了其他可能性:
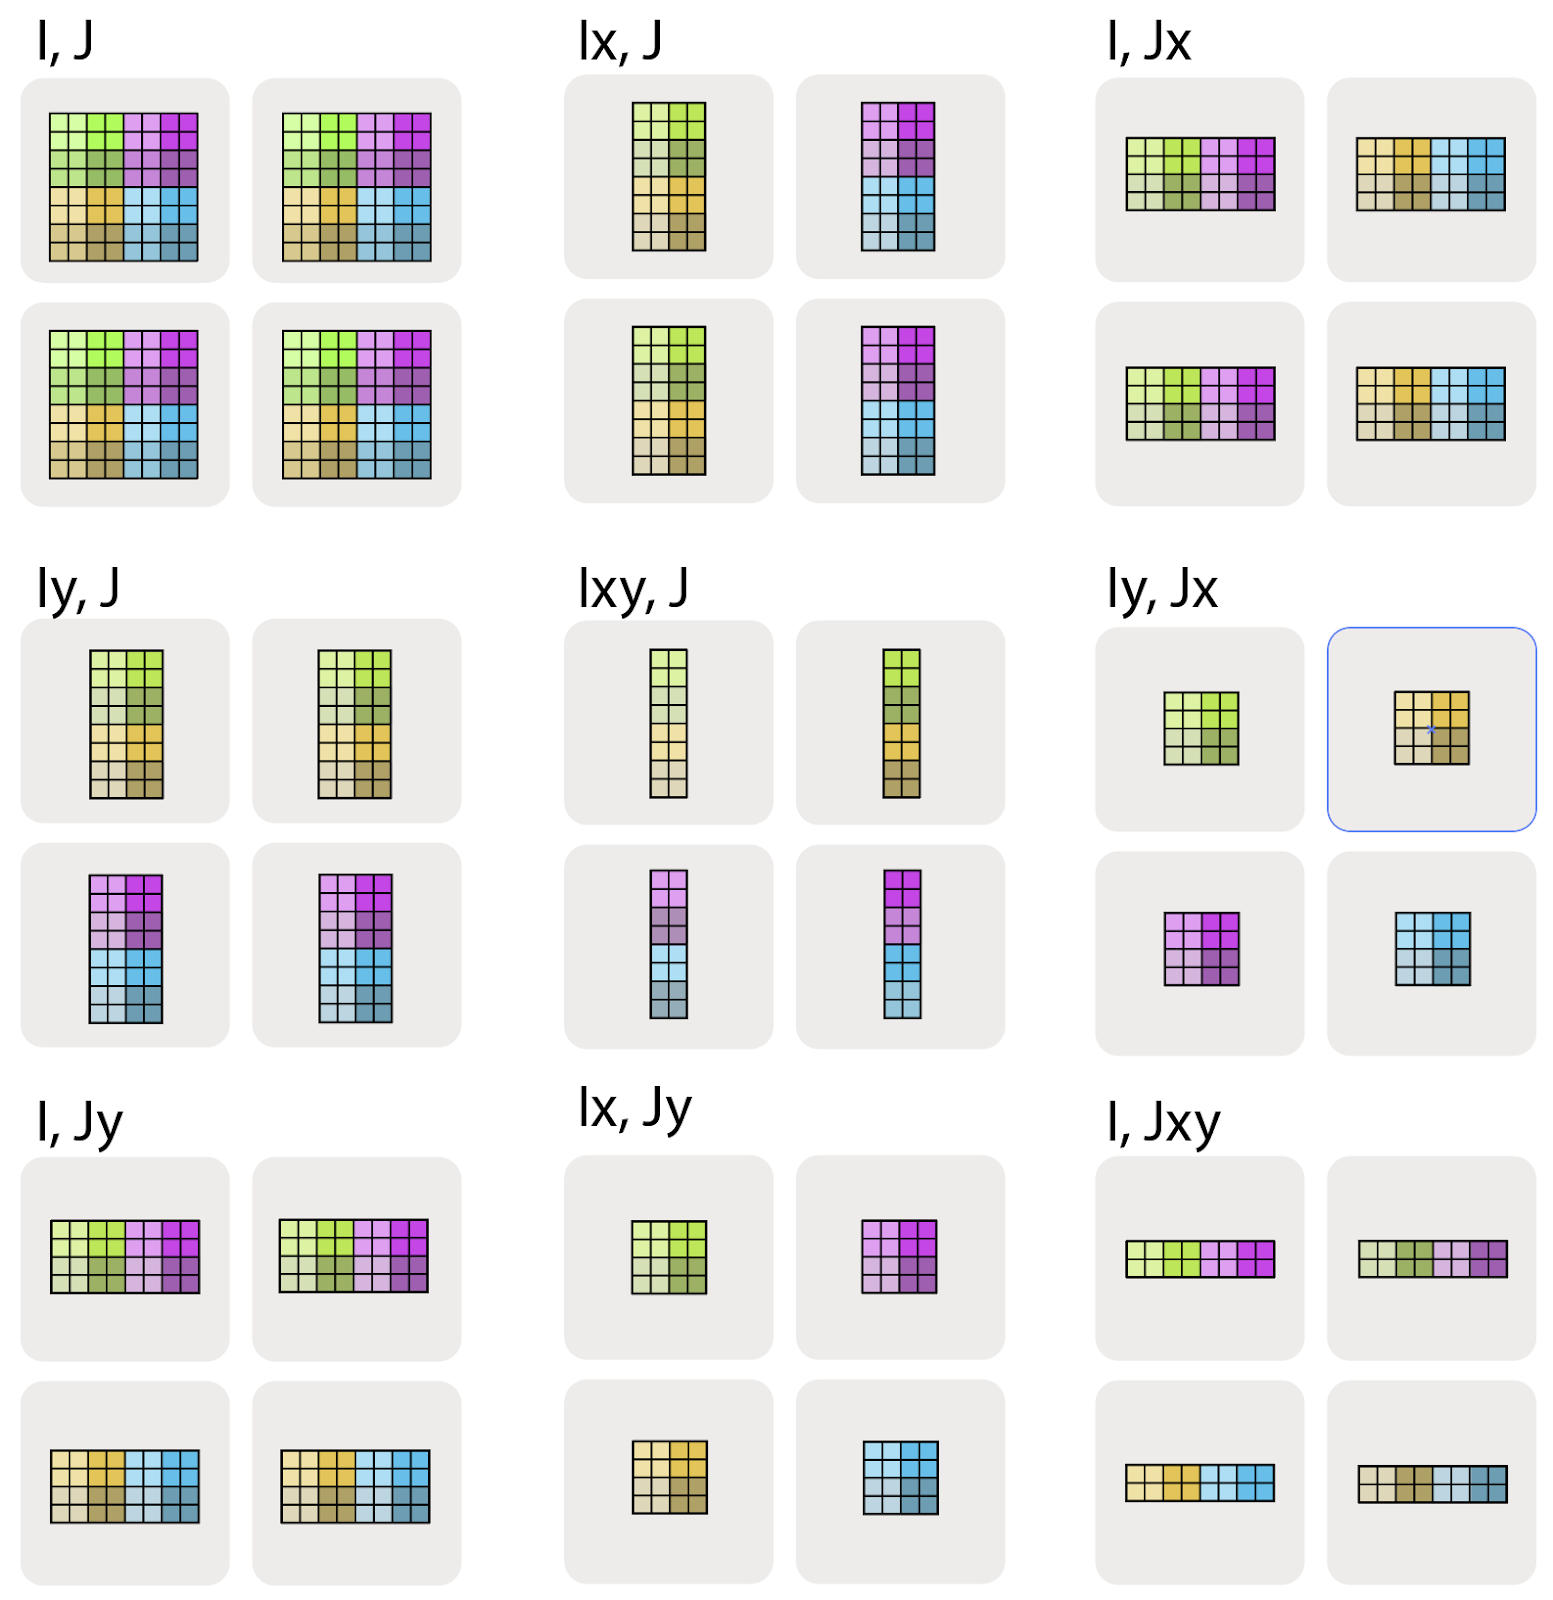
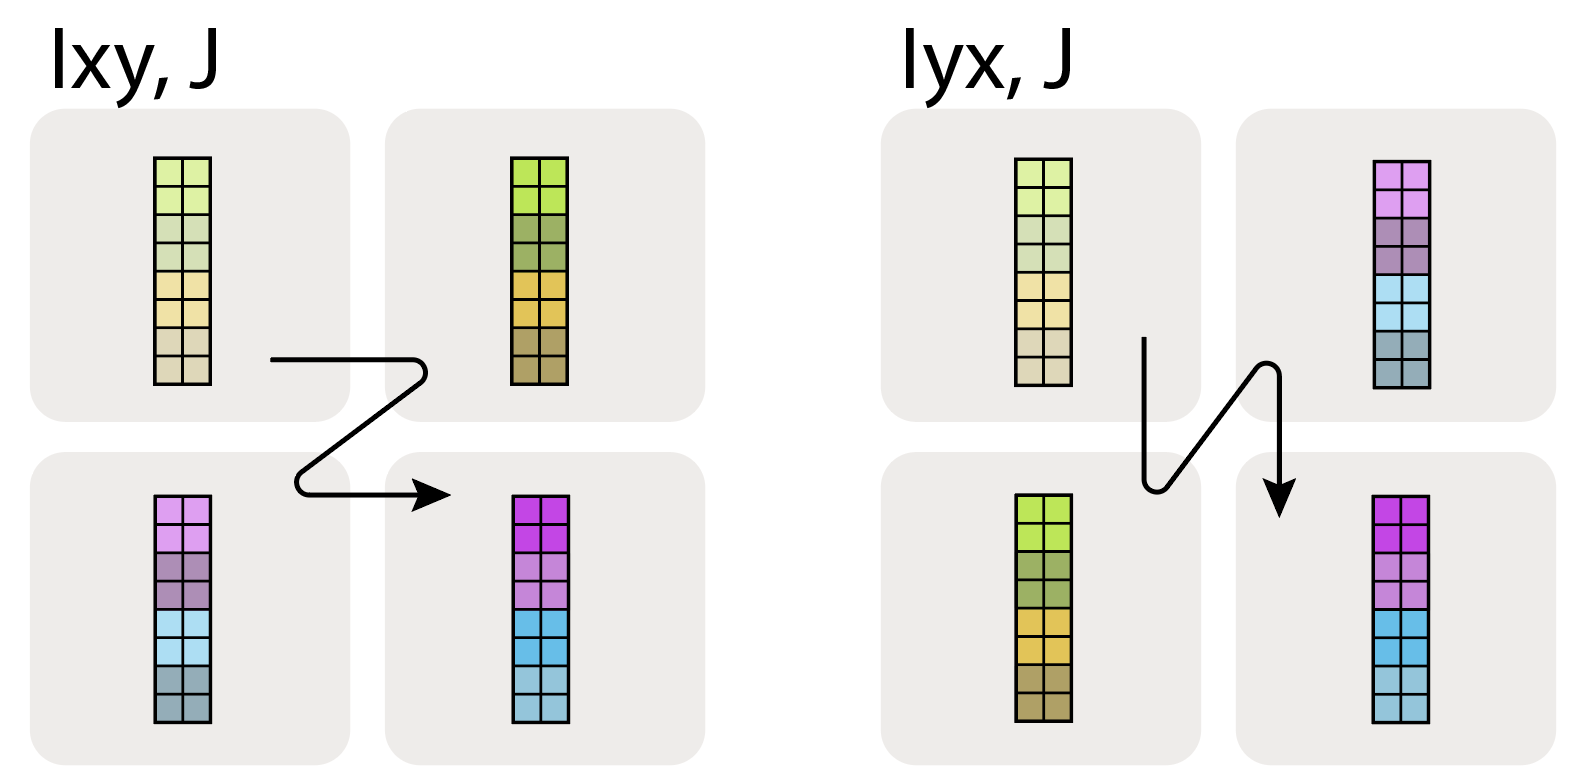
这里 $A[I_{XY}, J]$ 意味着我们把 X 与 Y 两根网格轴当成一个更大的扁平化维度,然后把 I 这个命名轴沿所有设备分区。多个网格轴下标的_顺序_有意义,它指定了在网格上分区遍历的顺序。
最后请注意,我们_不能_让多个命名轴沿_同一根_网格维度分片。例如 $A[I_X, J_X]$ 是无意义的、被禁止的分片。一旦某根网格维度被用于给一个数组维度分片,它在某种意义上就被"用掉"了。
Pop Quiz: 设 A 是形状为 int8[128, 2048] 的数组,分片为 $A[I_{XY}, J]$,网格为 Mesh({'X': 2, 'Y': 8, 'Z': 2})(共 32 个设备)。A 在每个设备上占多少内存?所有设备上 A 总共占多少内存?
点击查看答案。
答案: 我们的数组 A 沿 X 与 Y 分片,沿 Z 复制,所以每个设备上的形状为 int8[128 / (2 * 8), 2048] = int8[8, 2048],大小为 8 * 2048 = 16,384 字节。由于沿 Z 复制,而在一个 Z 平面内沿 X、Y 完全分片,因此原始数组共有 2 份完整拷贝(每个 Z 平面一份)。所以跨所有设备的总大小为:原数组大小 × Z 上的复制份数 = 128 * 2048 * 2 = 512 KiB。等价地,可以验证:32 设备 × 16,384 字节/设备 = 512 KiB。
How do we describe this in code?(如何在代码中描述?)#
到目前为止我们还没谈代码,但现在是个好机会先小窥一下。JAX 使用一种命名分片语法,与上面我们描述的抽象语法非常吻合。我们将在 第 10 节 中详谈,这里先给出一个快速预览。你可以在 Google Colab 这里 中玩玩,并通过 profile 查看 JAX 是怎么处理不同分片的。这段代码做了 3 件事:
- 创建一个 jax.Mesh,把我们的 8 个 TPU 映射到一个 4x2 网格上,给两根轴分别命名为 ‘X’ 和 ‘Y’。
- 创建矩阵 A 和 B,其中 A 沿两个维度都被分片,B 沿输出维度被分片。
- 编译并执行一次简单的矩阵乘法,返回一个分片数组。
import jax
import jax.numpy as jnp

# Create our mesh! We're running on a TPU v2-8 4x2 slice with names 'X' and 'Y'.
assert len(jax.devices()) == 8
mesh = jax.make_mesh(axis_shapes=(4, 2), axis_names=('X', 'Y'))

# A little utility function to help define our sharding. A PartitionSpec is our
# sharding (a mapping from axes to names).
def P(*args):
  return jax.NamedSharding(mesh, jax.sharding.PartitionSpec(*args))

# We shard both A and B over the non-contracting dimension and A over the contracting dim.
A = jnp.zeros((8, 2048), dtype=jnp.bfloat16, device=P('X', 'Y'))
B = jnp.zeros((2048, 8192), dtype=jnp.bfloat16, device=P(None, 'Y'))

# We can perform a matmul on these sharded arrays! out_shardings tells us how we want
# the output to be sharded. JAX/XLA handles the rest of the sharding for us.
y = jax.jit(lambda A, B: jnp.einsum('BD,DF->BF', A, B), out_shardings=P('X', 'Y'))(A, B)
JAX 很酷的一点是,这些数组用起来就像没分片一样!B.shape 会告诉我们全局或逻辑形状 (2048, 8192)。我们必须查看 B.addressable_shards 才能看到它在本地是怎么分片的。我们可以对这些数组做运算,JAX 会自动尝试如何广播或重塑以执行运算。例如上面的例子里,A 的本地形状是 [2, 1024],B 是 [2048, 4096]。JAX/XLA 会按需自动添加跨数组的通信,以执行最终的乘法。
Computation With Sharded Arrays(分片数组的计算)#
如果你有一份数据分布在很多设备上,且想对它做数学运算,那么同时对数据和计算进行分片会带来什么开销?
显然,这取决于具体的计算。
- 对于_逐元素_(elementwise)操作,对一个分布式数组进行操作没有任何开销。
- 当我们想对驻留在多个设备上的元素跨设备做运算时,事情就复杂了。所幸,对绝大多数机器学习而言,几乎所有计算都以矩阵乘法的形式发生,而它们相对容易分析。
本节余下部分将讨论如何乘分片矩阵。粗略地说,这意味着把矩阵的若干块来回搬动,以便每一块都能被完整地相乘或求和。每种分片都会涉及不同的通信。 例如,$A[I_X, J] \cdot B[J, K_Y] \to C[I_X, K_Y]$ 可以无任何通信地完成,因为_收缩维度_(contracting dimension,即我们实际求和的那一维 J)未被分片。然而,如果我们想要未分片的输出(即 $A[I_X, J] \cdot B[J, K_Y] \to C[I, K]$),我们要么把 $A$ 和 $B$ 复制到每个设备,要么把 $C$ 复制到每个设备(用 AllGather)。这两种选择的通信代价不同,因此我们需要计算这一代价并挑出最低的。
你可以从"分块矩阵乘法"(block matrix multiplication)的角度来理解。
为了理解这点,回忆一下"分块矩阵"(block matrix)这个概念,即矩阵嵌套矩阵会很有帮助:
$$ \begin{equation} \begin{pmatrix} a_{00} & a_{01} & a_{02} & a_{03} \\ a_{10} & a_{11} & a_{12} & a_{13} \\ a_{20} & a_{21} & a_{22} & a_{23} \\ a_{30} & a_{31} & a_{32} & a_{33} \end{pmatrix} = \left( \begin{matrix} \begin{bmatrix} a_{00} & a_{01} \\ a_{10} & a_{11} \end{bmatrix} \\ \begin{bmatrix} a_{20} & a_{21} \\ a_{30} & a_{31} \end{bmatrix} \end{matrix} \begin{matrix} \begin{bmatrix} a_{02} & a_{03} \\ a_{12} & a_{13} \end{bmatrix} \\ \begin{bmatrix} a_{22} & a_{23} \\ a_{32} & a_{33} \end{bmatrix} \end{matrix} \right) = \begin{pmatrix} \mathbf{A_{00}} & \mathbf{A_{01}} \\ \mathbf{A_{10}} & \mathbf{A_{11}} \end{pmatrix} \end{equation} $$矩阵乘法有一个好性质:当被乘数被写成块的形式时,乘积可以按照标准规则用块矩阵相乘的方式表示:
$$ \begin{equation} \begin{pmatrix} A_{00} & A_{01} \\ A_{10} & A_{11} \end{pmatrix} \cdot \begin{pmatrix} B_{00} & B_{01} \\ B_{10} & B_{11} \end{pmatrix} = \begin{pmatrix} A_{00}B_{00} + A_{01}B_{10} & A_{00}B_{01} + A_{01}B_{11} \\ A_{10}B_{00} + A_{11}B_{10} & A_{10}B_{01} + A_{11}B_{11} \end{pmatrix} \end{equation} $$这意味着,实现分布式矩阵乘法归结为:在网络上搬动这些分片块、对块做_本地_矩阵乘法、再求和。问题就变成:要加多少通信,以及代价多大。
很方便地,我们可以把所有可能的分片归纳为大约 4 种需要考虑的情形,每一种都有相应的通信加法规则:
- 情形 1: 两个输入都未沿收缩维度分片。我们可以无通信地相乘本地分片。
- 情形 2: 一个输入沿收缩维度分片。通常我们沿收缩维度对该输入做 “AllGather”。
- 情形 3: 两个输入都沿收缩维度分片。我们可以先相乘本地分片,再 “AllReduce” 结果。
- 情形 4: 两个输入都有非收缩维度沿同一根轴分片。我们必须先对其中一个输入做 AllGather,然后才能继续。
你可以把这些视作"照搬即可"的规则,但理解它们_为什么_成立、_有多贵_也很有价值。下面我们逐一详细讨论。
Case 1: neither multiplicand has a sharded contracting dimension(情形 1:两个被乘数的收缩维度都未分片)#
引理(Lemma): 当我们乘分片矩阵时,计算是合法的,且输出沿用输入的分片,_除非_收缩维度被分片,或者两个矩阵沿同一根轴被分片。例如下式没问题:
$$ \begin{equation*} \mathbf{A}[I_X, J] \cdot \mathbf{B}[J, K_Y] \rightarrow \mathbf{C}[I_X, K_Y] \end{equation*} $$完全无需任何通信,结果是一个沿 X 与 Y 两根硬件维度都分片的张量。想想看为什么会这样。本质上,这一计算与分片是_独立_的,因为每个 batch 项都拥有要收缩的轴的某个本地块,可以乘起来再 reduce。下面这些情形都没问题,且都遵循这一规则:
$$ \begin{align*} \mathbf{A}[I, J] \cdot \mathbf{B}[J, K] \rightarrow &\ \mathbf{C}[I, K] \\ \mathbf{A}[I_X, J] \cdot \mathbf{B}[J, K] \rightarrow &\ \mathbf{C}[I_X, K]\\ \mathbf{A}[I, J] \cdot \mathbf{B}[J, K_Y] \rightarrow &\ \mathbf{C}[I, K_Y]\\ \mathbf{A}[I_X, J] \cdot \mathbf{B}[J, K_Y] \rightarrow &\ \mathbf{C}[I_X, K_Y] \end{align*} $$因为 A 和 B 都没有沿收缩维度 J 被分片,所以我们可以直接对输入做本地的分块矩阵乘法,结果_已经_是按所需输出分片排好了。当两个被乘数都有非收缩维度沿同一根轴分片时,这一点不再成立(详见 非法分片 节)。
Case 2: one multiplicand has a sharded contracting dimension(情形 2:一个被乘数的收缩维度被分片)#
下面考虑当一个输入 A 沿收缩维度 J 分片,而 B 完全复制时怎么办:
$$ \mathbf{A}[I, J_X] \cdot \mathbf{B}[J, K] \rightarrow \mathbf{C}[I, K] $$我们不能直接乘 A 与 B 的本地块,因为我们需要在 A 完整的收缩维度上求和,而它在 X 轴上被切开了。通常我们先对 A 的分片做 “AllGather",让每个设备都拥有一份完整拷贝,然后才与 B 相乘:
$$ \textbf{AllGather}_X[I, J_X] \rightarrow \mathbf{A}[I, J] $$$$ \mathbf{A}[I, J] \cdot \mathbf{B}[J, K] \rightarrow \mathbf{C}[I, K] $$这样实际的乘法就完全可以在每个设备上独立完成。
要点: 当乘的两个矩阵中有一个沿收缩维度分片时,我们一般先对它做 AllGather,让收缩不再被分片,然后做本地 matmul。
注意:当 B 也未沿 X 分片时,我们也可以先做本地的部分乘积,再对分片的部分和求和(即 AllReduce),这在某些情形下可能更快。参见下文 问题 4。
什么是 AllGather? AllGather 是我们要讨论的第一个核心 MPI 通信原语。AllGather 沿某根轴_去除分片_,把分布在各设备上的分片重新拼装到_每个_设备上。用上文的记号,AllGather 从一组轴上去掉一个下标,例如:
$$ \textbf{AllGather}_{XY}(A[I_{XY}, J]) \rightarrow A[I, J] $$我们不必去掉某根维度上的所有下标,比如 $A[I_{XY}, J] \rightarrow A[I_Y, J]$ 也是一次 AllGather,只是只在一根轴上做。还要注意,我们也可能想用 AllGather 来去除_非收缩_维度的分片,例如在矩阵乘法中:
$$ A[I_X, J] \cdot B[J, K] \rightarrow C[I, K] $$我们既可以一开始就 AllGather A 来去掉输入分片,也可以做完分片的 matmul 再 AllGather 结果 C。
AllGather 实际上是怎么做的? 要在一根 TPU 轴(一个环)上做一次 1D AllGather,本质上是让每个 TPU 把它的分片沿环传递,直到每个设备都拿到一份。GPU 的 AllGather 也可以这么做:在一个节点内的若干 GPU 之间构造一个环,按这个(任意)顺序传递块。下面是动画:
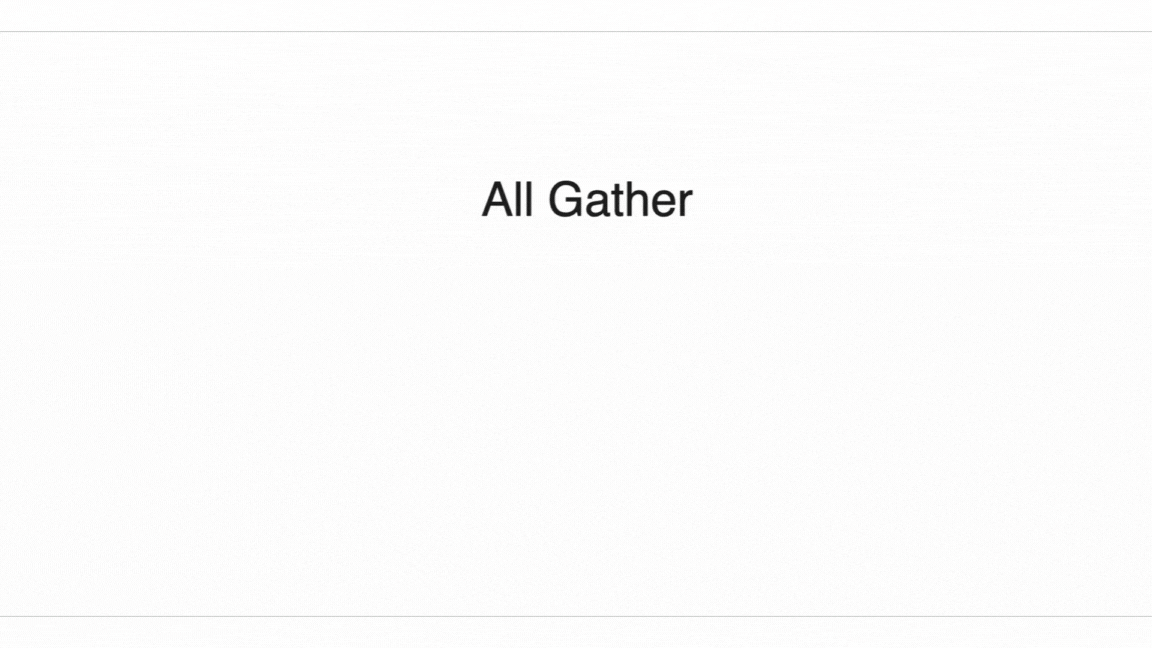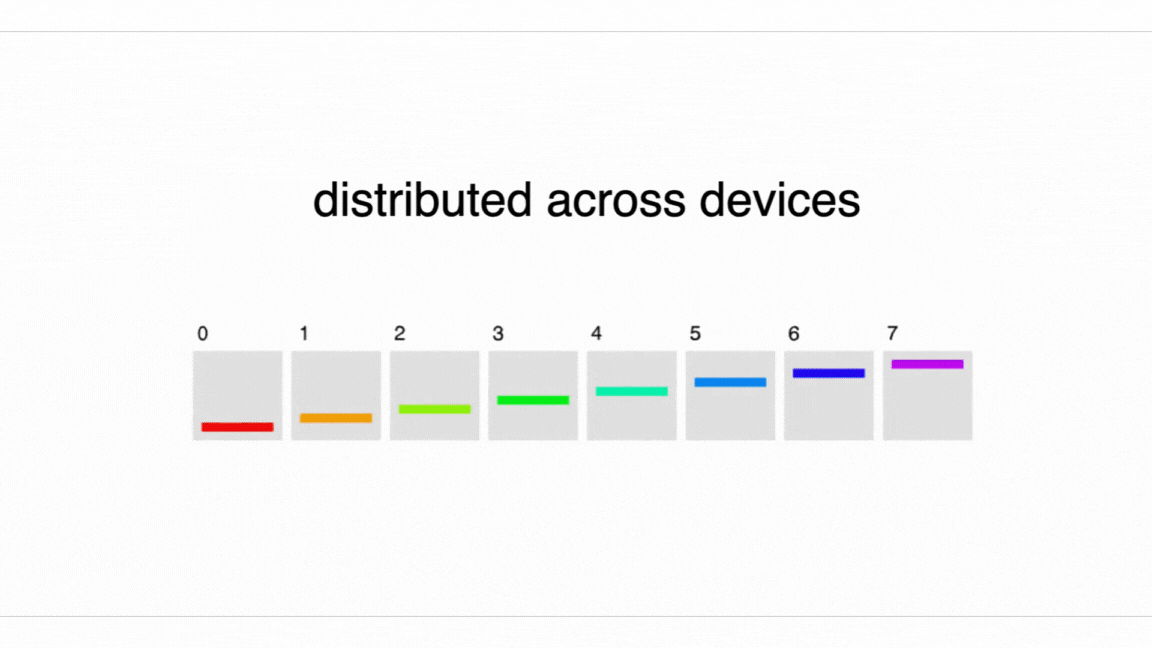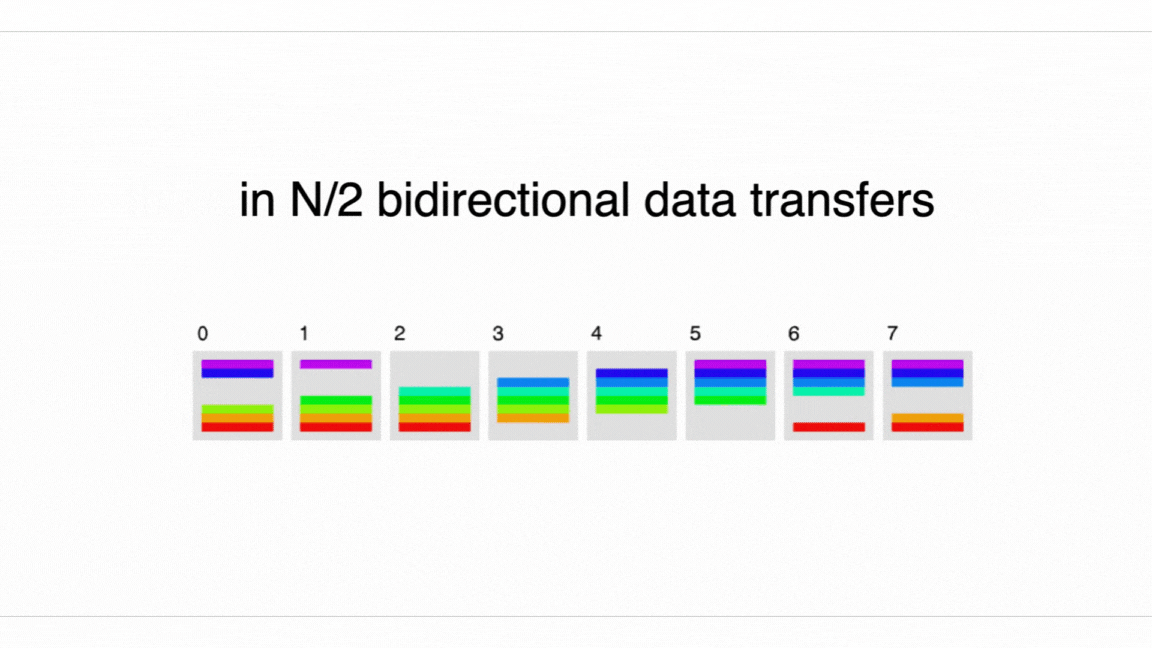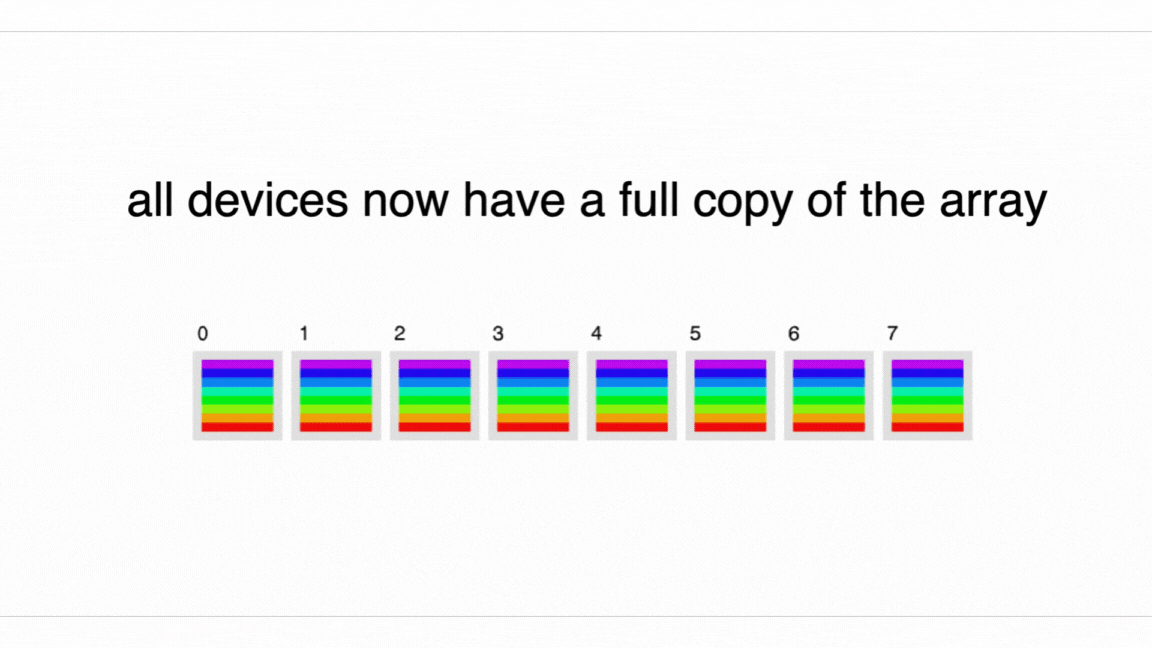
图: 在一组 8 个 TPU 或 GPU 设备上做 AllGather 的动画。每个设备从 1/8 的数组开始,最终都拿到完整的一份拷贝。
我们可以在一个方向上做 AllGather,也可以在双向上做(上图展示了双向)。如果只单向做,每个 TPU 沿环跨 $N - 1$ 跳发送大小为 $\text{bytes} / N$ 的块。如果双向做,则有 $\lfloor \frac{N}{2} \rfloor$ 跳,每跳大小为 $2 \cdot \text{bytes} / N$。
这要花多久? 我们以双向 AllGather 为例算一算用时。设 $V$ 为数组的字节数,$X$ 为收缩维度上的分片数。则由上图可知,每跳在每个方向上发送 $V / \lvert X\rvert$ 字节,因此每跳耗时
$$ T_{hop} = \frac{2 \cdot V}{\lvert X \rvert \cdot W_\text{ici}} $$其中 $W_\text{ici}$ 是双向(bidirectional) ICI 带宽。分子的 2 来自我们使用了双向带宽:每个方向发送 $V / X$,合计 $2V / X$。我们一共需要走 $\lvert X\rvert / 2$ 跳才能到达每个 TPU(严格来说是 $\lfloor X / 2 \rfloor$),所以总用时为
$$ T_{total} = \frac{2 \cdot V \cdot X}{2 \cdot X \cdot W_\text{ici}} $$$$ T_{total} = \frac{V}{W_\text{ici}} $$注意它与 $X$ 无关! 这相当令人惊讶,因为这意味着即使 TPU 之间只是局部连接,连接的局部性也并不重要。我们只是被每条链路的速率所卡住。
要点: 在吞吐量受限(throughput-bound)的状态下做 AllGather(或 ReduceScatter、AllReduce)时,实际通信时间只取决于数组大小和可用带宽,而与数组分片到的设备数无关!
关于 ICI 延迟(latency): 不管数据量多少,ICI 链路上的每一跳都有一些固有开销,通常在 1us 左右。这意味着当数组 $A$ 非常小、每跳耗时不到 1us 时,我们会进入"延迟受限”(latency-bound)状态,此时计算_确实_依赖于 $X$。
详细推导请点击。
设 $T_\text{min}$ 为单跳的最小时间。则
$$ T_{hop} = \max \left[ T_{min}, \frac{2 \cdot V}{X \cdot W_\text{ici}} \right] $$$$ T_{total} = \max \left[ \frac{T_{min} \cdot X}{2}, \frac{V}{W_\text{ici}} \right] $$因为我们走 $X / 2$ 跳。对于大规模 reduce 或 gather,我们牢牢处在带宽受限。我们发送的数据量大到每跳的开销基本可以忽略。但对于小数组(比如从模型采样时),这就不能忽略了,ICI 带宽也变得无关紧要——我们纯粹受延迟所限。换种说法:对于某款特定 TPU,比如 TPU v5e 单向 ICI 带宽 4.5e10,发送任何小于 4.5e10 * 1e-6 = 45kB 的缓冲都会被延迟所限。
下面是 TPU v5e 8x16 切片上 AllGather 带宽的实测。数组沿大小为 16 的轴分片,从而构成完整的双向环。
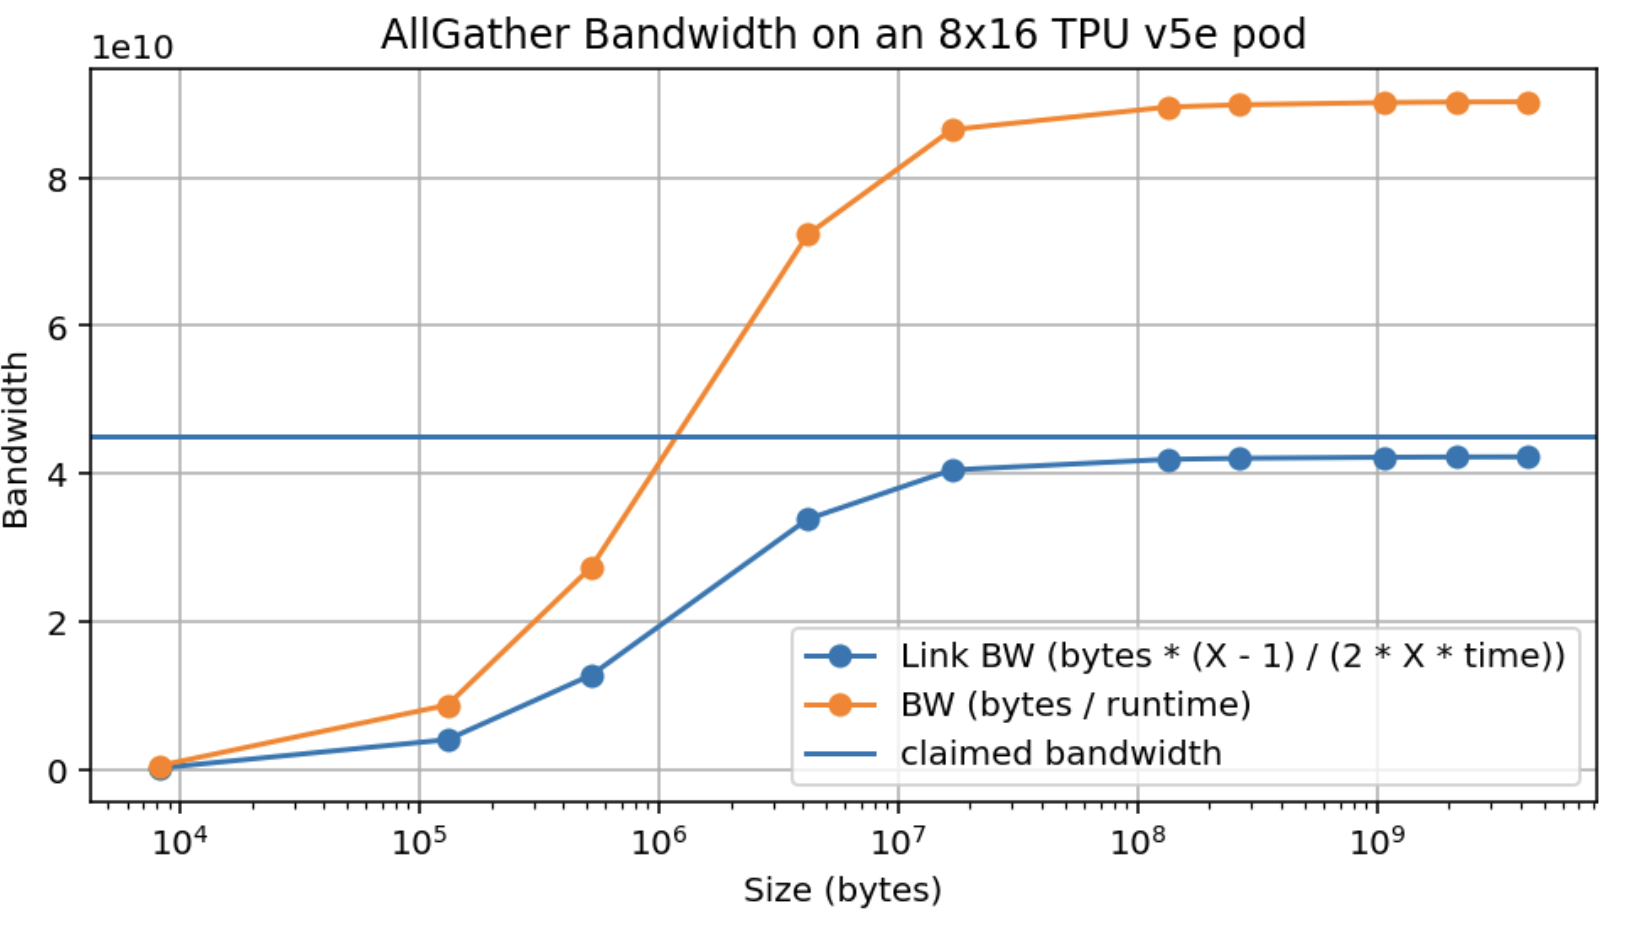
图: TPU v5e 上 AllGather 的实测带宽与估算的链路带宽。橙色 BW 是实际 AllGather 出的字节/秒,蓝色曲线则是依据该集合操作已知代价反推出的实测单向链路带宽。
注意,我们不仅达到约 95% 的标称峰值带宽(4.5e10),还在约 10MB 时就达到了这一峰值——这相当于 16 路分片下每个设备约 625kB(附注:这比 GPU 好得多)。
当我们沿多根轴做 AllGather 时会发生什么? 当我们在多根轴上 gather 时,就有多个 ICI 维度可用于这次 gather。例如 AllGatherXY([B, DXY]) 在两根硬件网格轴上操作。这把可用带宽提高了 $N_\text{axes}$ 倍。
考虑延迟时,我们可以得到一般规则:
$$ T_{total} = \max \left[ \frac{T_{min} \cdot \sum_{i} |X_i|}{2}, \frac{V}{W_\text{ici} \cdot N_\text{axes}} \right] $$其中 $\sum_i \lvert X_i \rvert / 2$ 是 TPU 网格上最长路径的长度。
Pop Quiz 2 [AllGather 用时]: 用 第 2 部分 的数字,在网格 {'X': 8, 'Y': 4} 的 TPU v5e 2D 网格上做 AllGatherY([EY, F]) → [E, F] 需要多久,其中 $E = 2048$,$F = 8192$,bfloat16?$E=256, F=256$ 时呢?
点击查看答案。
答案: 我们先算几个基本量:
- TPU v5e 在两根轴上各有 4.5e10 字节/秒的单向 ICI 带宽。2) bfloat16 下对于 (a),我们有 $A[E_Y, F]$,每个设备持有形状为 bfloat16[512, 8192] 的数组,大小为 512 * 8192 * 2 = 8.4MB。整个数组大小为 2048 * 8192 * 2 = 34MB。
对于 (1),我们可以用上文的公式。由于在一根轴上做 AllGather,所以 $T_{\text{comms}} = \text{34e6} / \text{9e10} = \text{377us}$。检查我们是否处于延迟受限:在大小为 4 的轴上,最多有 3 跳,延迟界约为 3us,我们离这个界还远。但 TPU v5e 只有当某根轴大小为 16 时才有回环(wraparound)连接,所以这里_我们其实做不到完全双向的 AllGather_。我们必须用 3 跳让数据从一边到达另一边,所以理论上更接近 $T_{\text{comms}} = 3 * \text{8.4e6} / \text{4.5e10} = 560\mu s$。这里 是来自 这个 Colab 的实际 profile,显示 $680 \mu s$,这合理,因为我们多半拿不到 100% 的理论带宽!对于 (2),每个分片大小为 64 * 256 * 2 = 32kB,32e3 / 4.5e10 = 0.7us,所以我们处于延迟受限。3 跳的话大致需要 3 * 1us = 3us。实际中接近 8us。
注: 当我们有 2D 网格如 {'X': 16, 'Y': 4} 时,每根轴并不必然对应某根特定的_硬件_轴。这意味着上面例子也可以描述一个 4x4x4 的 TPU v5p 立方体,其中 $X$ 轴上承载了 2 根轴。这一点在我们后面讨论跨多轴的数据并行时会用到。
Case 3: both multiplicands have sharded contracting dimensions(情形 3:两个被乘数的收缩维度都被分片)#
第三种基本情形是:两个被乘数都沿其收缩维度被分片,且沿同一根网格轴:
$$ \textbf{A}[I, J_X] \cdot \textbf{B}[J_X, K] \rightarrow C[I, K] $$此时_本地_的分块矩阵乘法至少_可行_,因为它们共享同一组收缩下标。但每个乘积只代表完整目标乘积的一个_部分和_(partial sum),X 维上的每个设备最终持有该最终目标乘积的_不同_部分和。这种情况太常见,我们扩展记号显式标出这一状态:
$$ \textbf{A}[I, J_X] \cdot_\text{LOCAL} \textbf{B}[J_X, K] \rightarrow C[I, K] \{\ U_X \} $$记号 { UX } 读作"沿 X 网格轴未约简"(unreduced along X mesh axis),表示该操作在某种意义上"未完成"——它需要一次最终的求和才能完成。$\cdot_\text{LOCAL}$ 语法表示我们做本地求和但保持结果未约简。
可以这样看:这源自矩阵乘法与外积(outer product)的关系:
$$ A \cdot B = \sum_{i=1}^{P} \underbrace{A_{:,i} \otimes B_{i,:}}_{\in \mathbb{R}^{n \times m}} $$其中 ⊗ 是外积。因此,如果轴 X 上的 TPU i 持有 A 的第 i 列与 B 的第 i 行,我们可以做本地矩阵乘法得到 $A_{:,i} \otimes B_{i,:} \in \mathbb{R}_{n\times m}$。该矩阵在每个项上都是 A • B 在该项上和的第 i 项。我们仍需在 P(被分片到网格轴 X 上)上求和才能得到完整的 A • B。当我们用块(即分片)写 A 与 B 时也是同样的道理——再对结果的每个分片求和即可。
我们可以沿 X 轴用一次完整的 AllReduce 来完成这次求和:
$$ \begin{align*} A[I, J_X] \cdot_\text{LOCAL} B[J_X, K] \rightarrow &\ C[I, K] \{ U_X \} \\ \textbf{AllReduce}_X C[I, K] \{ U_X \} \rightarrow &\ C[I, K] \end{align*} $$AllReduce 把部分和消除掉,让该轴上_每个_设备拥有相同的、完全求和过的值。AllReduce 是本节中我们要讨论的第二个关键通信,第一个是 AllGather,其余还有 ReduceScatter 与 AllToAll。AllReduce 接收一个带有未约简(部分求和)轴的数组,沿该未约简轴传递分片并累加结果,从而完成求和。其签名为:
$$ \textbf{AllReduce}_Y A[I_X, J] \{U_Y\} \rightarrow A[I_X, J] $$也就是它仅去掉 ${U_Y}$ 后缀,结果其余不变。
AllReduce 有多贵? 一个心智模型是:每个设备把它的分片发给邻居,再把收到的所有分片加起来。显然这比 AllGather 更贵,因为这里每个"分片"的形状与完整数组相同。一般而言,AllReduce 的代价是 AllGather 的两倍。一种看法是:AllReduce 可以表达为另两个原语的组合——ReduceScatter 加 AllGather。与 AllReduce 相似,ReduceScatter 也消除数组上的部分和,但结果是沿某一给定维度被"散开"或分区。AllGather 收集所有这些片段,把对应物理轴上的逻辑轴"反分区/反分片/复制"出来。
$$ \begin{align*} \textbf{ReduceScatter}_{Y,J} : A[I_X,J] \{U_Y\} \rightarrow &\ A[I_X, J_Y] \\ \textbf{AllGather}_Y : A[I_X, J_Y] \rightarrow &\ A[I_X, J] \end{align*} $$那 ReduceScatter 呢? 正如 AllGather 重新拼装一个分片数组(去掉一个下标),ReduceScatter 对一个未约简/部分求和的数组求和后,沿同一根网格轴把另一个逻辑轴散开(分片)。$X[F]{U_Y} \to X[F_Y]$。下面的动画展示了它的做法:注意它与 AllGather 非常像,但不是保留每个分片,而是把它们求和起来。因此,除了执行约简的开销外,它的延迟与 AllGather 大致相当。
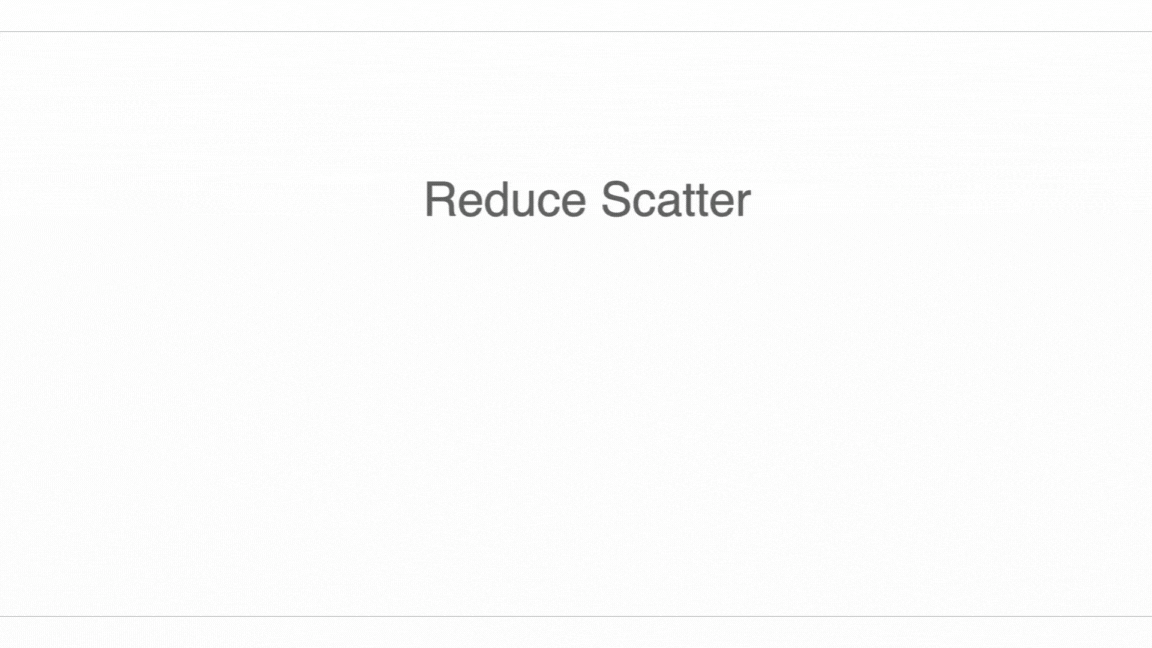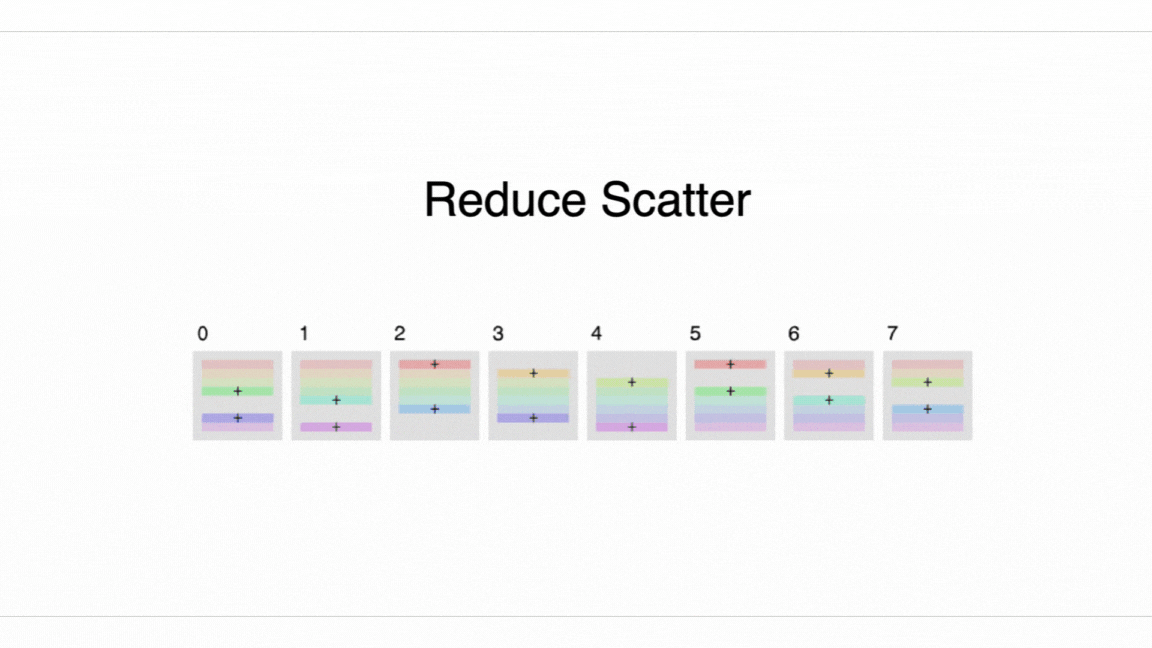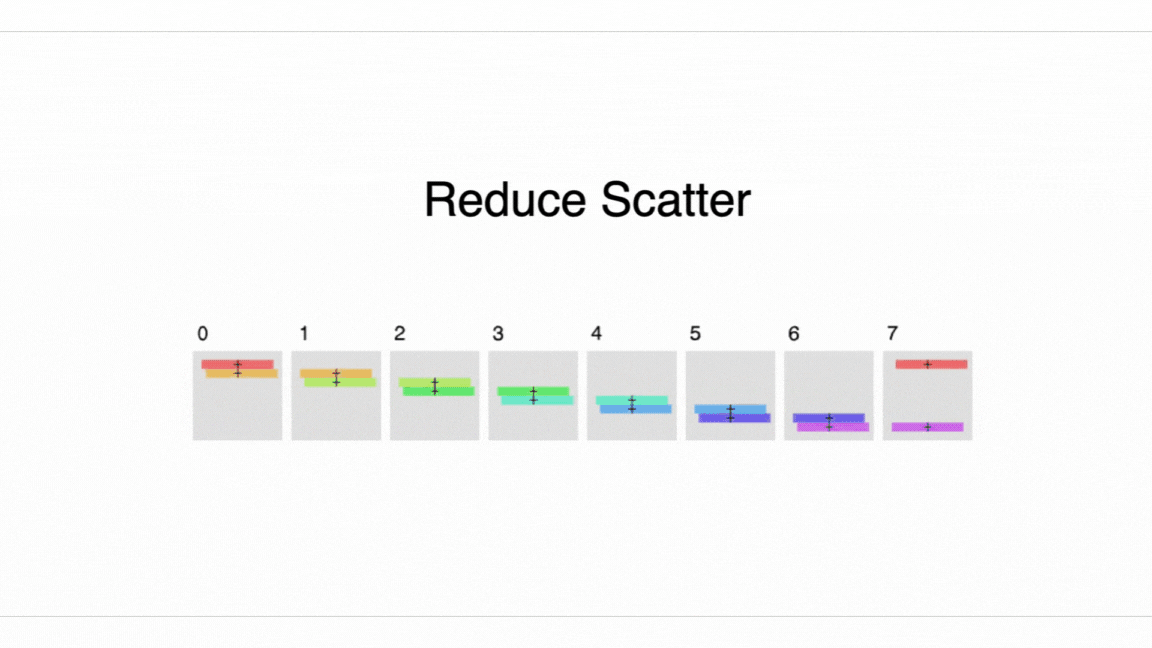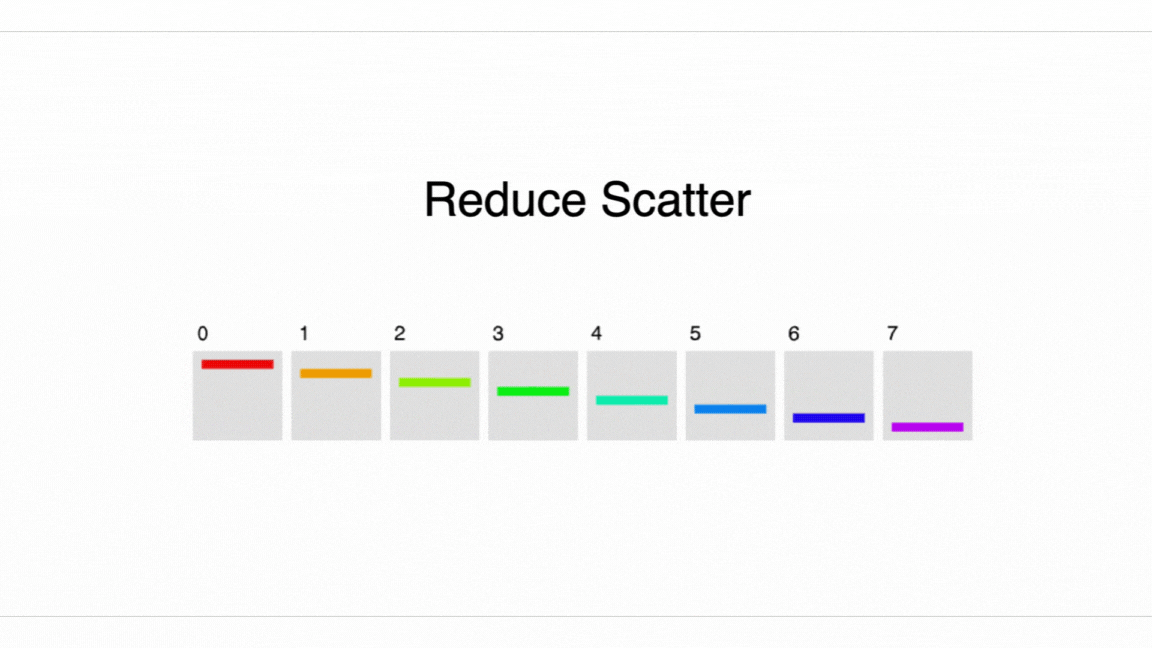
每跳的通信时间就是每片字节数 $V / Y$ 除以带宽 $W_\text{ici}$,与 AllGather 相同,所以我们有
$$ T_{\text{comms per AllGather or ReduceScatter}} = \frac{V}{W_\text{ici}} $$$$ T_{\text{comms per AllReduce}} = 2 \cdot \frac{V}{W_\text{ici}} $$这里 $W_\text{ici}$ 是双向带宽,前提是我们有完整的环可供 reduce。
Case 4: both multiplicands have a non-contracting dimension sharded along the same axis(情形 4:两个被乘数的非收缩维度沿同一根轴分片)#
每根网格维度在分片一个张量时最多只能出现一次。执行上面的规则有时会导致违反这一规则,例如:
$$ A[I_X, J] \cdot B[J, K_X] \rightarrow C[I_X, K_X] $$这是非法的,因为给定的某一片,比如 X 维上第 i 片,会持有 C 的第 (i, i) 片,也就是对角元素。所有分片合起来也只能恢复结果的对角元素,无法恢复其他,所以我们不能允许这种分片。
解决办法是 AllGather 其中一些维度。这里我们有两种选择:
$$ \begin{align*} \textbf{AllGather}_X A[I_X, J] \rightarrow &\ A[I, J] \\ A[I, J] \cdot B[J, K_X] \rightarrow &\ C[I, K_X] \end{align*} $$或
$$ \begin{align*} \textbf{AllGather}_X B[J, K_X] \rightarrow &\ B[J, K] \\ A[I_X, J] \cdot B[J, K] \rightarrow &\ C[I_X, K] \end{align*} $$无论哪种,结果的形状中 X 都只会出现一次。具体选哪种取决于后续操作所需的分片。
A Deeper Dive into TPU Communication Primitives(深入 TPU 通信原语)#
前面 4 种情形引入了用于做分片矩阵乘法的若干"核心通信原语":
- AllGather: 从分片中去掉一个下标,把分片收集起来。
- ReduceScatter: 通过沿某根轴对分片求和来去除"未约简"后缀,使结果沿另一根轴分片。
- AllReduce: 去除"未约简"后缀,使数组沿该轴不再分片。
还有一个核心通信原语值得提一下——它出现在 Mixture of Experts(MoE)模型与其他计算中:AllToAll。
Our final communication primitive: the AllToAll(最后一个通信原语:AllToAll)#
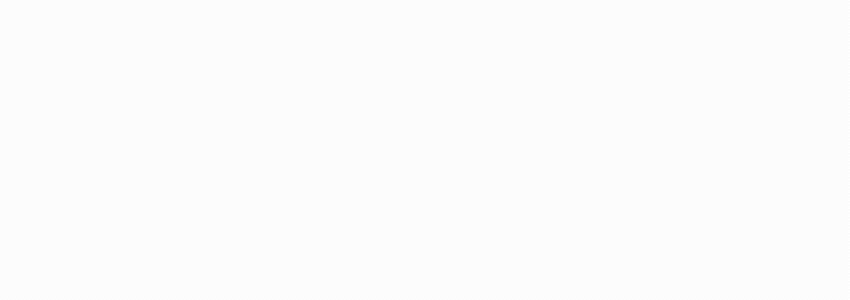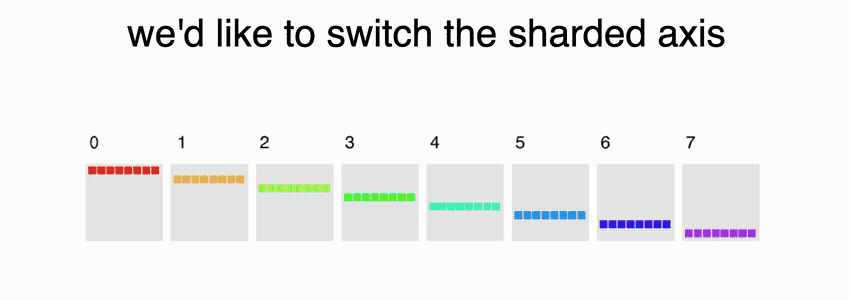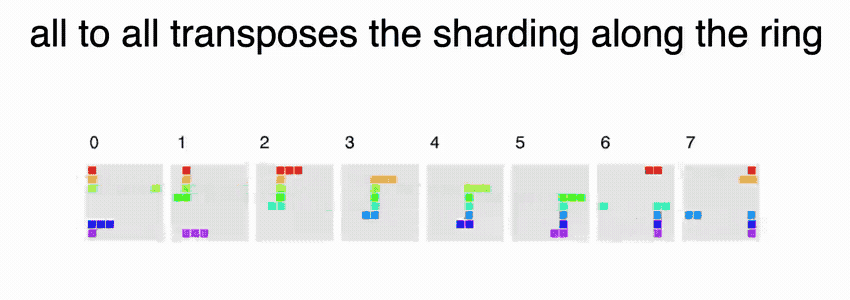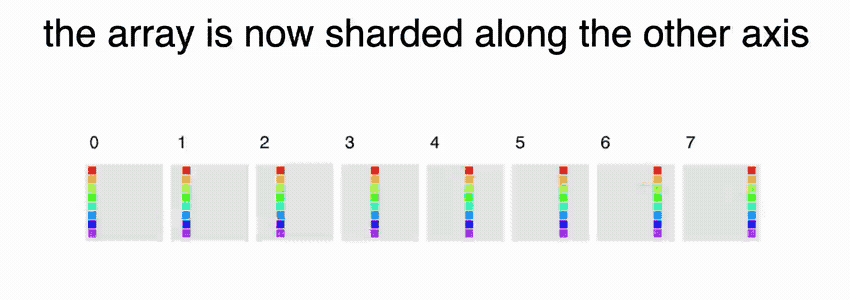
最后一个基本集合操作在分片矩阵乘法中并不天然出现,但实际中频繁出现:AllToAll 集合操作,更精确地说是_分片转置_(sharded transposition)或重分片(resharding)操作。例如:
$$ \textbf{AllToAll}_{X, J} A[I_X, J] \rightarrow A[I, J_X] $$AllToAll 通常用于在分片计算的两个布局方案不兼容的区域之间重排分片布局。它在分片的 mixture-of-experts 模型中自然出现。你可以把 AllToAll 看作把一个下标从一根轴搬到另一根轴。由于 AllToAll 不需要把每个分片的全部数据复制到环上其他设备,它实际上比 AllGather 更便宜(差 ¼ 倍)。对于偶数大小的双向环,每个设备会向右发送 $(N/2 + (N/2-1) + … + 1)$ 个块、向左发送 $((N/2-1) + … + 1)$ 个块 $= 0.5 \cdot (N / 2) \cdot (N/2 + 1) + 0.5 \cdot (N / 2) \cdot (N/2 - 1) = N^2/4$。每个块(即"分片的分片")大小为 $\text{bytes} / N^2$,因此每设备代价为 $(\text{bytes} / N^2) \cdot N^2 / 4 = \text{bytes} / 4$。该结果在所有设备上随设备数线性扩展,因为总带宽随设备数扩展。
如果我们推广到 N 维 AllToAll,对于一个 $V$ 字节的数组,在 AxBxC 网格上的总代价为
$$ T_\text{comms per AllToAll} = \frac{V \cdot \max(A, B, C, .../part0_introduction)}{4 \cdot N \cdot W_\text{ici}} $$照例 $W_\text{ici}$ 是双向 ICI 带宽。对 1D 网格化简为 $V / (4 \cdot W_\text{ici})$,正好是 AllGather 代价的 1/4。在 2D 中,代价实际上随最小轴的大小下降。
附注:如果想要这一事实的直觉推导,从 1D 环面 $\mathbb{Z} / N\mathbb{Z}$ 开始。如果我们随机挑一个源节点和目标节点,它们平均相距 N / 4 跳,给出代价 $(V \cdot N) / (4 * N)$。再考虑 N 维环面,每根轴本质上是独立的。每个节点拥有 $1 / N$ 字节,平均要把数据搬 $\max(A, B, C, …) / 4$ 跳。
More about the ReduceScatter(关于 ReduceScatter 的更多内容)#
ReduceScatter 比表面看上去更基础,因为它实际上是 AllGather 的导数(derivative),反之亦然。也就是说,如果前向我们有:
$$ \textbf{AllGather}_X A[I_X] \rightarrow A[I] $$那么我们就要 ReduceScatter 反向模式(reverse-mode)的导数 A’(在每个分片上一般不同),以推导分片的 A’:
$$ \textbf{ReduceScatter}_X A'[I] \{ U_X \} \rightarrow A'[I_X] $$类似地,前向 $\text{ReduceScatter}X(A[I] {U_X}) \to A[I_X]$ 蕴含反向 $\text{AllGather}{X}(A’[I_X]) \to A’[I]$。
关于 AllGather 与 ReduceScatter 互为导数的细节,请点击。
这源于一个事实:作为线性算子,broadcast 与 reduce 互为转置,而 AllGather 与 ReduceScatter 分别是它们的外积(也称 Kronecker 积)。具体来说,若有向量 $x \in \mathbb{R}^n$、设备数 $p \in \mathbb{N}$,并令 $u = (1, \ldots, 1) \in \mathbb{R}^p$,我们可如下定义 broadcast 与 reduce,应该与你的直觉一致:
$$ \begin{align*} \text{broadcast} &: \mathbb{R}^n \rightarrow \mathbb{R}^{p n} \\ \text{broadcast} &= u \otimes \mathbf{I}_n \\ \text{reduce} &: \mathbb{R}^{p n} \rightarrow \mathbb{R}^n \\ \text{reduce} &= u^T \otimes \mathbf{I}_n \end{align*} $$来看一个 $n = 1$、$p = 2$ 的例子。若 $x = (7)$,则 $\text{broadcast}(x) = \left(\begin{pmatrix} 1 \ 1 \end{pmatrix} \otimes \begin{pmatrix} 1 \end{pmatrix}\right) x = \begin{pmatrix} 1 \ 1 \end{pmatrix} x = \begin{pmatrix} 7\ 7 \end{pmatrix} \in \mathbb{R}^{p n}$。这与我们的预期相符——把 $\mathbb{R}^n$ 中的向量 broadcast 到 $\mathbb{R}^{pn}$。再令 $y = (8, 9)$,则 $\text{reduce}(y) = \left(\begin{pmatrix} 1 & 1 \end{pmatrix} \otimes \begin{pmatrix} 1\end{pmatrix}\right) y = \begin{pmatrix} 1 & 1 \end{pmatrix} \begin{pmatrix} 8 \ 9 \end{pmatrix} = \begin{pmatrix} 17 \end{pmatrix}$。这也符合预期——把 $\mathbb{R}^{p n}$ 的向量 reduce 到 $\mathbb{R}^{n}$。由于对任意矩阵 $A$、$B$ 有 $(A \otimes B)^T = A^T \otimes B^T$,所以 $\text{reduce} = \text{broadcast}^T$。把 AllGather 与 ReduceScatter 写成下面的外积形式:
$$ \begin{align*} \text{AllGather} &: \mathbb{R}^{p n} \rightarrow \mathbb{R}^{p^2 n} \\ \text{AllGather} &= \text{broadcast} \otimes \mathbf{I}_p \\ \text{ReduceScatter} &= \mathbb{R}^{p^2 n} \rightarrow \mathbb{R}^{p n} \\ \text{ReduceScatter} &= \text{reduce} \otimes \mathbf{I}_p \end{align*} $$把 $\mathbb{R}^{p^2 n}$ 想成 $\mathbb{R}^{p \times p n}$,即 $p$ 个设备各持有一个 $\mathbb{R}^{p n}$ 向量。建议你拿小例子(如 $n = 2$、$p = 3$)算一下,看看这些算子作为矩阵长什么样。再用同样的转置性质,可得 $\text{AllGather}^T = \text{ReduceScatter}$,自然 $\text{ReduceScatter}^T = \text{AllGather}$。这一转置性会在反向传播中出现:若 $y = Ax$ 且 $A$ 是某个线性算子(如 AllGather 或 ReduceScatter),则反向传播时我们有损失对 $y$ 的导数 $\frac{\partial L}{\partial y}$,而 $\frac{\partial L}{\partial x} = A^T \frac{\partial L}{\partial y}$。这表明 AllGather 的导数是 ReduceScatter,反之亦然。
把 AllReduce 拆成 AllGather 与 ReduceScatter 还有一个便利的性质:我们可以把最终的 AllGather 推迟到稍后某个时刻。常常我们并不希望支付把完整矩阵乘积复制到所有设备上的代价,而希望即使是合并两个收缩维度都被分片的被乘数时,也保持分片状态:
$$ A[I, J_X] \cdot B[J_X, K] \rightarrow C[I, K_X] $$这种情形我们也可以做 ReduceScatter 而非 AllReduce,并可选地在稍后某个时刻再做 AllGather,即:
$$ \begin{align*} A[I, J_X] \cdot_\text{LOCAL} B[J_X, K] \rightarrow &\ C[I, K] \{ U_X \} \\ \textbf{ReduceScatter}_{X,K} C[I, K] \{ U_X \} \rightarrow &\ C[I, K_X] \end{align*} $$注意 ReduceScatter _引入了_一个分片维度,所以这里它有沿 I 或 K 任一命名维度分片的天然自由度。使用 ReduceScatter 时,我们一般需要选择_要给哪个_命名维度引入新的分片(不过通常这一选择会被更大的建模上下文所强制)。这就是我们用 ReduceScatterX,K 这种语法来指定要分片的轴的原因。
How to overlap matmul communication with compute(如何让 matmul 通信与计算重叠)#
正如我们在 第 1 部分 中讨论的,我们一般假设只要通信足够快,就总能与某些有用的计算重叠。本节中的集合操作通常都能与矩阵乘法本身的计算相重叠,但做起来并不平凡。我们使用的算法叫做集合 matmul(collective matmul),最早见于 Wang et al.。下面是一个简化的动画,演示了这种重叠如何实现:
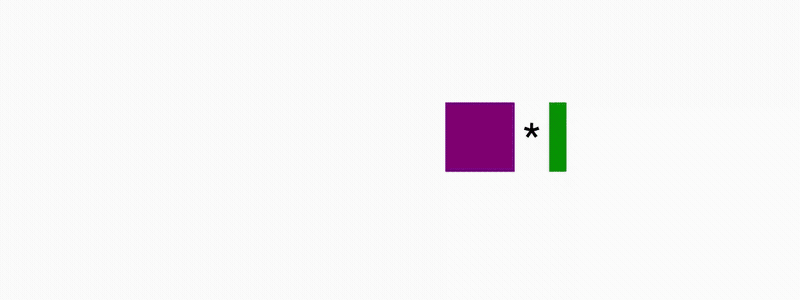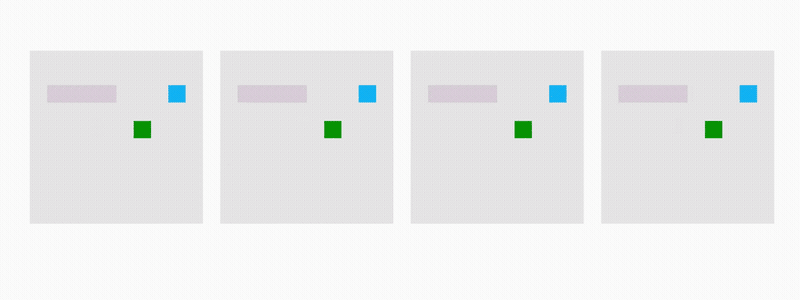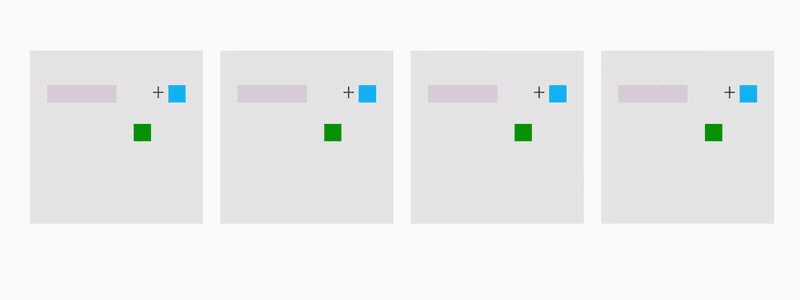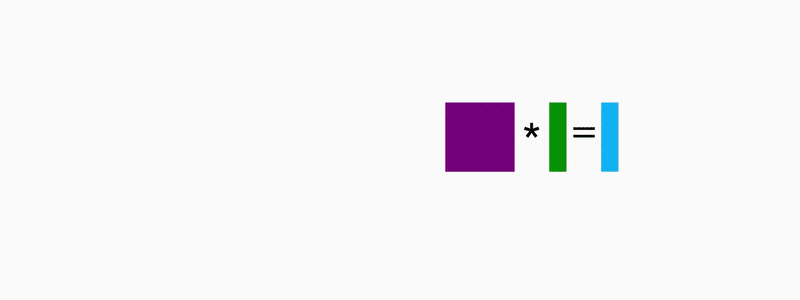
图: 该动画展示了一个分片矩阵-向量乘积如何与产生它的 AllReduce(上文情形 3)重叠。完整的 matmul 由多个矩阵-向量乘积组成。
简单地说,我们可以在为前一些块开始环 reduce 的同时,对一个矩阵块做 matmul。某些情况下我们也可以在 batch 维度或矩阵输入维度上做 tile 切分。我们在 第 10 部分 中给出了一个简单的 JAX 实现,Mosaic 文档 也给出了一个 GPU 上的好例子。我们鼓励你在某个时点实现一个版本。
What Have We Learned?(我们学到了什么?)#
- 数组的分片由两部分指定:一个Mesh——为我们的 TPU 网格的物理硬件轴命名;以及一个Sharding——把网格轴名指派给数组的逻辑轴。
- 例如 A[IXY, J] 描述一个抽象数组 A,其第一维沿两根网格轴 X、Y 分片。结合 Mesh(mesh_shape=(4, 8), axis_names=(‘X’, ‘Y’)) 或缩写 Mesh({‘X’: 4, ‘Y’: 8}),告诉我们数组沿第一维被切成 32 份。
- 分片数组的算术运算与未分片数组完全一样,除非你沿某个分片轴做收缩。 一旦如此,我们就必须引入一些通信。我们考虑四种情形:
- 两个数组都未沿收缩维度分片:无需通信。
- 一个数组沿收缩维度分片(或两个收缩维度沿不同的轴分片):我们在执行操作前先 AllGather 其中一个输入。
- 两个数组都沿收缩维度按相同方式分片:我们先在本地相乘分片,再做 AllReduce 或 ReduceScatter。
- 两个数组在非收缩维度上沿同一根网格轴分片:先 AllGather 其中一个输入。
- TPU 大致使用 4 个核心通信原语:
- AllGather:$[A_X, B] \to [A, B]$
- ReduceScatter:$[A, B] {U_X} \to [A_X, B]$
- AllToAll:$[A, B_X] \to [A_X, B]$
- AllReduce:$[A_X, B]{U_Y} \to [A_X, B]$(严格说不是原语,因为它合并了 ReduceScatter + AllGather)
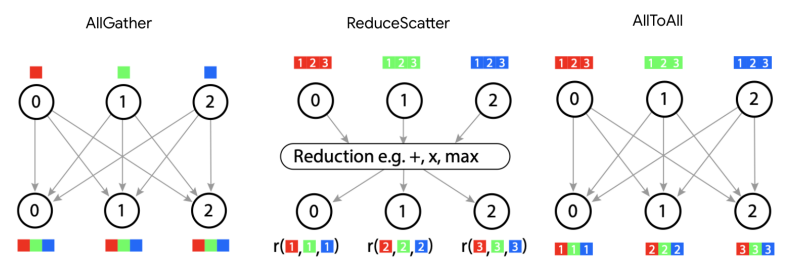
- 这些操作的代价与延迟不依赖于轴的大小(只要处于带宽受限),只依赖于输入数组的大小与链路带宽。对于单向 AllGather/ReduceScatter:
- AllReduce 由 ReduceScatter 加 AllGather 组成,因此代价是上式的 2 倍。AllToAll 只需把分片在环上传递部分距离,因此代价为 AllGather 的 ¼。下面是一个总结:
| 操作 | 描述 | 语法 | 用时 |
|---|---|---|---|
| AllGather | 沿某根轴收集分片数组的所有分片,去掉一个下标。 | $[A_X, B] \to [A, B]$ | bytes / (双向 ICI 带宽 * num_axes) |
| ReduceScatter | 沿某根轴对部分求和数组求和,并沿另一根轴分片(添加一个下标)。 | $[A, B] {U_X} \to [A_X, B]$ | 同 AllGather |
| AllReduce | 沿某根轴对部分求和数组求和。去掉一个 { Ux }。合并了 AllGather 与 ReduceScatter。 | $[A_X, B]{U_Y} \to [A_X, B]$ | 2 * AllGather |
| AllToAll | 沿同一根轴 gather(复制)一根轴并 shard 另一根维度。 | $[A, B_X] \to [A_X, B]$ | 在双向环上 AllGather / 4 |
Some Problems to Work(一些习题)#
这里给出一些基于本节内容的有指导意义的题目。我们暂时不给出全部答案,会在后续逐步补上更多答案。
问题 1 [复制分片]:一个数组分片为 $A[I_X, J, K, \ldots]$(即只沿 $X$ 分片),网格为 Mesh({'X': 4, 'Y': 8, 'Z': 2})。$A$ 在所有芯片上占用的总字节数与该数组单份大小之比是多少?
点击查看答案。
我们的数组只沿 X 分片,X 大小为 4,所以每份分片实际上大小为 $[I / 4, J, K, \ldots] = \text{sizeof}(A) / 4$。由于在 Y 与 Z 上复制,总大小是 $Y \cdot Z \cdot \text{sizeof}(A)$,所以总大小与单芯片大小之比是 $Y \cdot Z \cdot \text{sizeof}(A) / \text{sizeof}(A) = 16$。
问题 2 [AllGather 延迟]:在网格 Mesh({'X': 4, 'Y': 4, 'Z': 4}) 的 TPU v4p 4x4x4 切片上,如果 $B=1024$、$D=4096$,bfloat16,$\text{AllGather}X([B_X, D_Y])$ 应该耗时多久?$\text{AllGather}{XY}([B_X, D_Y])$ 呢?$\text{AllReduce}_Z([B_X, D_Y] {U_Z })$ 呢?
点击查看答案。
由于是完整的 4x4x4 立方体,所有轴上都有回环连接,所以可用的双向带宽是 9e10。
因为我们只在一根轴上 gather,而另一根已分片,等价于在 1 根轴上 gather $2BD / Y$ 字节。想象沿 Y 轴的单一片,X 上的 AllGather 就像未分片的 AllGather,只是字节数变成 1 / Y。 TPU v4p 的双向 ICI 带宽为 9e10 字节/秒,所以耗时 $2BD / (\text{9e10} \cdot Y) = 2 \cdot 1024 \cdot 4096 / (\text{9e10} \cdot 4) = 23 \mu s$。
我们带宽是之前的两倍,但要 AllGather 整个数组,所以
T = 2BD / (2 * W) = 2*1024*4096 / (2 * 9e10) = 46us。距离延迟界 4us(每跳 1us)远,没问题。AllReduce 的代价是 AllGather 的两倍。每片大小为 $2BD / (X * Y)$,所以代价约为 $4BD / (X * Y * W)$,即
4 * 1024 * 4096 / (16 * 9e10) = 11.6us。
问题 3 [延迟受限的 AllGather]:假设我们做 $\text{AllGather}_X([B_X])$ 但 $B$ 很小(比如 128)。在网格 Mesh({'X': 4, 'Y': 4, 'Z': 4}) 的 TPU v4p 4x4x4 切片上,bfloat16,应该耗时多久?提示:你多半处于延迟受限。
点击查看答案。
bfloat16 下我们的数组共 256 字节,每设备 64 字节。由于 TPU v4p 上一根大小为 4 的轴有回环,我们可以在两个方向上都发送数组。单向带宽 4.5e10,每跳约 64 / 4.5e10 ~ 0,所以肯定是延迟受限。数一下跳数,整个 gather 只需 2 跳,所以约 2us 是个不错的估计。
问题 4 [matmul 策略]:要执行 $X[B, D] \cdot_D Y[D_X, F] \to Z[B, F]$,本节告诉你先做 $\text{AllGather}_X(Y[D_X, F])$ 再乘完全复制后的矩阵(情形 2,策略 1)。另一种做法是先乘本地分片 $X[B, D_X] \cdot_D Y[D_X, F] \to Z[B, F] {U_X}$(情形 3,策略 2),然后做 $\text{AllReduce}_X(Z[B, F] { U_X})$。每种策略各做多少 FLOPs 与多少通信?哪种更好,为什么?
点击查看答案。
先看基线(策略 1)。如已展示,AllGather 代价为 $2DF / W_\text{ici}$。一旦得到完全复制的数组,总计算时间是 $2BDF / C$(其中 $C$ 是加速器的 FLOPs/s,因为每个 TPU 做相同的 FLOPs)。所以
$$ T_\text{total (Strategy 1)} = \max\left(\frac{2BDF}{C}, \frac{2DF}{W_\text{ici}}\right) $$相比之下,新策略(策略 2)对 $2BF$ 字节做一次 AllReduce,代价 $4BF / W_\text{ici}$,但 FLOPs 减少 $1 / X$ 倍(因为计算被分片了)。这意味着我们做 $2\cdot B\cdot D\cdot F / X$ FLOPs,结果的 AllReduce 在 bfloat16 下传输 $2 \cdot 2 \cdot B \cdot F$ 字节。因此 策略 2(无 AllGather,只在稍后做 AllReduce)的总时间约为
$$ T_\text{total} = \max\left(\frac{2BDF}{X \cdot C}, \frac{4BF}{W_\text{ici}}\right) $$问题是:哪种更大? 当 $D / (X \cdot C) > 2 / W_\text{ici}$ 即 $D / 2X > C / W_\text{ici} \approx 2550 \rightarrow X < D / (2 * 2550)$ 时,策略 (2) 是计算受限的。我们可以合理预期 $D \approx 8k$,则约 $X < 2$,这不太可能——因此策略 2 基本上总是通信受限。对于基线(策略 1),当 $B < C / W_\text{ici} = 2550$ 时是通信受限的,常但并非总是成立。
所以当 $B < 2550$ 时,两者都是通信受限,我们有
$$ T_\text{comms for Strategy 2} < T_\text{comms for Strategy 1} \Leftrightarrow \frac{4BF}{W_\text{ici}} < \frac{2DF}{W_\text{ici}} $$这在 $D > 2B$(其中 $2B < 5100$)时成立。这种情况经常发生,所以策略 2 在 batch 较小时有时更好。当 batch 较大时($B > 2550$),我们有
$$ T_\text{comms for Strategy 2} < T_\text{math for Strategy 1} \Leftrightarrow \frac{4BF}{W_\text{ici}} < \frac{2BDF}{C} $$这在 $2 / W_\text{ici} < D / C$ 即 $D > 2 * 2550 = 5100$ 时成立,对大模型通常如此。所以这种替代策略对大模型通常更好,除非 $D$ 较小。
为什么不总是这么做? 实际上我们有时会这么做,但通常 matmul 中某个输入的收缩维度沿着另一个输入未分片的某根轴分片这种情况比较少见。例如做 FSDP(在 第 5 节 解释)时,参数沿 data 维度分片,激活_也_沿 data 分片。所以从这个意义上讲,这种情形并不常出现。
问题 5 [最小延迟]:假设我想在 TPU v4p 4x4x4 上以最小延迟做 matmul $A[I, J] \cdot_J B[J, K] \to C[I, K]$。假设输入可以任意分片,但结果应当完全复制。我的输入应当如何分片?总 FLOPs 与通信时间是多少?
点击查看(部分)答案。
我们这里不给出完整答案,只描述四种最有可能的方案:
- $A[I_{XYZ}, J] \cdot B[J, K]$ + 末尾 AG
- $A[I, J] \cdot B[J, K_{XYZ}]$ + 末尾 AG
- $A[I, J_{XYZ}] \cdot B[J_{XYZ}, K]$ + 末尾 AR
- $A[I, J] \cdot B[J, K]$(完全复制)
我们也可以考虑把不同的轴沿不同的网格轴分片,但不太可能改变最终代价。除 (4) 外,每个 TPU 的总 FLOPs 都相同,但通信不同。我们只需对每种计算通信代价并挑出最低的。一句话总结:(1) 与 (2) 一样好。
问题 6:假设我们想在 TPU v5e 4x4 上做 $A[I_X, J_Y] \cdot_J B[J_Y, K] \to C[I_X, K]$。我们要做哪些通信?通信与计算各占多少时间?
- 那 $A[I_X, J] \cdot_J B[J_X, K_Y] \to C[I_X, K_Y]$ 呢?这是训练中最标准的设置——结合数据、张量与 ZeRO 分片。
- 那 $A[I_X, J] \cdot_J B[J, K_Y] \to C[I_X, K_Y]$ 呢?这是推理中标准的——纯张量并行(+数据)。
问题 7:一个典型的 Transformer 块有两个矩阵 $W_\text{in}[D, F]$ 与 $W_\text{out}[F, D]$,其中 $F \gg D$。设 batch 大小为 B。则完整的块为 $In[B, D] \cdot W_\text{in}[D, F] \cdot W_\text{out}[F, D]$。取 $D=8192$、$F=32768$、$B=128$,假设全部 bfloat16。假设我们运行在 TPU v5e 2x2 切片上,但假设每个 TPU 只有 300MB 的可用内存。In、$W_\text{in}$、$W_\text{out}$ 与 Out 应如何分片,才能在内存限制下使总耗时最小?通信与 FLOPs 各花多少时间?提示:最终输出不必完全复制,但应与输入相同分片,以便"层"可以重复。
点击查看(部分)答案。
先想一下内存。两个大矩阵每个使用 2 * 8192 * 32768 = 536MB。我们的激活 In 大小为 2 * 128 * 8192 = 2MB(小到无需担心)。由于每个设备只剩 300MB 内存,显然必须分片我们的 matmul。
- $In[B_X, D] * W_\text{in}[D_{XY}, F] * W_\text{out}[F, D_{XY}] \rightarrow Out[B_X, D]$(这通常称为 FSDP)
- $In[B, D_{XY}] * W_\text{in}[D, F_{XY}] * W_\text{out}[F_{XY}, D] \rightarrow Out[B, D_{XY}]$(这称为张量并行)
第一种很糟,因为我们需要先 AllGather 大权重或激活。第二种需要在开头做一次 AllGather、在末尾做一次 ReduceScatter(比 AllReduce 更便宜)。剩下的算式留作练习。
问题 8 [挑战]:用上面那段简短的代码片段作为模板,分配一个分片数组并用 pmap 或 shard_map 基准测试 4 个主要通信原语(AllGather、AllReduce、ReduceScatter 与 AllToAll)。你需要用到 jax.lax.all_gather、jax.lax.psum、jax.lax.psum_scatter 与 jax.lax.all_to_all。你理解这些函数的语义吗?它们各耗时多久?
问题 9 [又一种分片 matmul 策略?]:上文 我们说过,当 matmul 中只有一个输入沿其收缩维度被分片时,我们应当 AllGather 该分片矩阵并在本地做收缩。你也许会想到的另一种策略是:做分片 matmul,然后 AllReduce 结果(就当两个输入都沿收缩维度分片)。即对 $A[I, J_X] *_J B[J, K] \to C[I, K]$ 通过:
- $C[I, K] { U_X } = A[I, J_X] \cdot B[J_X, K]$
- $C[I, K] = \text{AllReduce}(C[I, K] { U_X})$
请回答以下问题:
- 显式写出该算法对矩阵 $A[N, M]$ 与 $B[M, K]$ 的过程,用下标说明在哪个设备上做了什么计算。假设 $A$ 在 ND 设备上分片为 $A[I, J_X]$,且你希望输出在所有设备上复制。
- 现在假设你能接受最终结果不在每个设备上复制,而是被分片(沿 N 或 K 维度)。上面的算法会如何变化?
- 仅看上面策略(第 2 部分,而非第 1 部分)的通信代价,它与"先 AllGather A 再做 matmul"算法的通信代价相比如何?
点击查看答案。
- 先做外积,结果存入 $O[N, K]: o_{kj} = \sum_i a_{ki} b_{ij}$。注意重复下标不是被收缩的下标,因为我们做的是外积。这里求和的范围是当前设备上存储的 i 值集合。例如,若收缩轴大小为 16、有 4 个设备,则在设备 0 上 i 取自 {0, 1, 2, 3};设备 1 上 i 取自 {4, 5, 6, 7};设备 2 上 i 取自 {8, 9, 10, 11};设备 3 上 i 取自 {12, 13, 14, 15}。然后对各设备上 $O[N, K]$ 的部分和做 AllReduce,即可得到完整的 $O[N, K]$。
- 第 2 步可以不用 AllReduce,而用更便宜的 ReduceScatter,沿任一根轴:$[N, K] { U_X } \to [N_X, K]$ 或 $[N, K] { U_X } \to [N, K_X]$。
- 如上文所述,吞吐受限时 AllGather 的代价与 ReduceScatter 相同,等于我们处理的完整矩阵的大小。所以在 gather-then-matmul 算法中,代价规模为 $NM$(因为我们 $\text{AllGather}$-ing $A$);在 matmul-then-reduce-scatter 算法中,规模为 NK(因为我们 reduce-scatter $O$)。所以两个算法的通信代价比为
M/K。
问题 10:AllToAll 之乐:上表中提到 AllToAll 的耗时比 AllGather 或 ReduceScatter 低 4 倍(在吞吐受限的情形下)。本题我们将看清这个 4 倍是怎么来的,以及如果我们只有单向 ICI 链路(而非双向),这个倍数会如何变化。
- 先看单向情形。设我们在环拓扑中有 D 个设备,要对 N x N 矩阵 $A[I_X, J]$ 做 AllGather 或 ReduceScatter(为简单起见 $D$ 整除 $N$)。描述这两个集合操作涉及的通信,并计算整个算法过程中单根 ICI 链路上传输的标量(float 或 int)总数。
- 现在考虑 AllToAll,仍然是单向 ICI。这种情形的算法与 AllGather 有何不同?计算单根 ICI 链路上传输的标量数。
- 你应该会发现 (a) 与 (b) 答案的比值是个不错的数。简单解释这个倍数从何而来。
- 现在加上双向通信。这对 AllGather 的总用时有何影响?
- 加上双向通信对 AllToAll 的总用时有何影响?
- 简单解释双向环上 AllGather 用时与 AllToAll 用时之比。
点击查看答案。
(1) 解: 过程很简单:算法的每一步中,每个设备都向其最近邻发送一个单一分片的"条带"(共 $\frac{N}{D} \times N$ 个元素)。这个过程进行 $D-1$ 次,因为每个分片都需要传给除其起始设备以外的所有设备。因此每个设备总共传输 $\frac{N^2(D-1)}{D}$ 个标量,即流过单根 ICI 链路的量。
答案: $N^2 (1-\frac{1}{D})$,或当 $D » 1$ 时简化为 $N^2$。
(2) 解: 从通信的角度看,AllToAll 与 AllGather 的关键差别是:在 AllToAll 中,某设备上的整个分片不需要传到其他每个设备。想象设备 0 上的分片为 $[A, B, C, D]$(这里 A、B、C、D 是矩阵,假设有 4 个设备的环作为示例)。现在矩阵 $A$ 不需要传到任何地方,矩阵 $B$ 需要落到设备 1,矩阵 $C$ 落到设备 2,矩阵 $D$ 落到设备 3。所以算法第一步把 $B$、$C$、$D$ 发给设备 1;下一步设备 1 把 $C$、$D$ 转发给设备 2;最后一步设备 2 把 $D$ 发给设备 3。这种情形下传输的参数总数是 $(\text{A/B/C/D 大小}) * (3 + 2 + 1)$。一般情形下 A/B/C/D 大小为 $\frac{N^2}{D^2}$,$(3 + 2 + 1)$ 项变成 $((D-1) + (D-2) + … + 1)$,即 $\frac{(D)(D-1)}{2}$。所以单根 ICI 链路上传输的字节总数是 $\frac{N^2(D-1)}{D \times 2}$。
答案: $\frac{N^2}{2}(1-\frac{1}{D})$,或当 $D » 1$ 时简化为 $\frac{N^2}{2}$。
(3) 解: 倍数就是 $\frac{1}{2}$,即在单向环拓扑下 AllToAll 的代价是 AllGather/ReduceScatter 的一半。回看上面的推导,这归根到底是因为:在 AllGather 情形中,我们传输相同大小的块共 $(D-1)$ 次,即做的是 $\text{tiny block size} * (D + D + D + … + D)$;而在 AllToAll 情形中,我们做的是 $\text{tiny block size} * (D + D-1 + D-2 + … + 1)$。这个 2 倍本质上来自 $1 + 2 + \ldots + n = n(n+1)/2$。
(4) 解:任何一根链路要承担的标量总数减半,因为在双向环中每个"分片条带"可以同时朝两个方向发送。
(5) 解:在这种情形下,相比单向情形我们赢了 4 倍。最容易看出的方式是考虑单条分片条带中每个大小 $(N^2/D^2)$ 的块的命运,比如来自设备 0 的那个条带。不再像单向情形那样把其中一块送 D-1 距离、另一块送 D - 2、…一直到 1,而是把条带分成往左/往右走的块,最大移动距离 floor(D/2)。所以对应的求和变成 $D/2 + D/2 - 1 + D/2 - 2 + … = D/2 \cdot (D/2+1)/2$,在大 $D$ 极限下为 $D^2/8$。比较单向情形的 $D^2/2$,我们看到我们赢了 4 倍。
(6) 解: 在单向环上,我们已经看到 AllToAll 时间是 AllGather 时间的 1/2;这来自于我们不需要把完整条带发送到每一个设备。然后加上双向后,AllToAll 多赢 4 倍而 AllGather 只多赢 2 倍。把这些比值合起来,就得到了我们要的 4 倍。
第 3 部分到此结束!第 4 部分(关于 Transformer 数学),请点击 这里!
Citation(引用)#
学术场合的引用,请使用:
Austin et al., "How to Scale Your Model", Google DeepMind, online, 2025.或者 BibTeX 条目:
@article{scaling-book,
  title = {How to Scale Your Model},
  author = {Austin, Jacob and Douglas, Sholto and Frostig, Roy and Levskaya, Anselm and Chen, Charlie and Vikram, Sharad
  and Lebron, Federico and Choy, Peter and Ramasesh, Vinay and Webson, Albert and Pope, Reiner},
  publisher = {Google DeepMind},
  howpublished = {Online},
  note = {Retrieved from https://jax-ml.github.io/scaling-book/},
  year = {2025}
}