All About Rooflines(Roofline 全解析)#
How To Scale Your Model 第 1 部分(第 0 部分:引言 | 第 2 部分:TPUs)
当我们在硬件上运行算法时,会受到三个因素的限制:计算机执行数学运算的速度(OPs/秒)、用于移动数据的可用带宽(字节/秒)以及用于存储数据的总内存(字节)。这些"roofline(屋顶线)“约束让我们能够给出某个计算的时间上下界。
目录
时间都去哪儿了?#
让我们从一个极其简单的问题开始:为什么一个算法耗时 50 毫秒,而不是 50 秒或 5 毫秒?模型内部到底在做什么会占用大量时间?我们应该预期它需要多久?
计算(Computation): 深度学习模型本质上是一堆矩阵乘法,每个矩阵乘法由浮点乘法和加法"运算”(FLOPs)组成。我们的加速器速度决定了这些运算需要多长时间:
$$\begin{equation} T_\text{math} = \frac{\text{Computation FLOPs}}{\text{Accelerator FLOPs/s}} \end{equation}$$例如,NVIDIA H100 每秒可以执行约 9.89e14 次 bfloat16 FLOPs,而 TPU v6e 每秒可以执行 9.1e14 次 FLOPs。这意味着在 H100 上执行 1e12 次 FLOPs 大约需要 1e12 / 9.89e14 = 1.01ms,在 TPU v6e 上则需要 1e12 / 9.1e14 = 1.1ms。
芯片内通信(Communication within a chip): 在一个加速器内部,张量需要在加速器内存(HBM)和计算核心之间传输。你会看到这条链路的带宽被称为"HBM 带宽"。在 H100 上,这大约是 3.35TB/s,在 TPU v6e 上大约是 1.6TB/s。
芯片间通信(Communication between chips): 当我们在多个加速器_之间_分布一个模型时,张量经常需要在它们之间传输。在我们的硬件上通常有几种选择(ICI、DCN 和 PCIe),每种都有不同的带宽。
无论是芯片内还是芯片间通信,我们都用字节/秒来度量,并通过以下公式估算总通信时间:
$$\begin{equation} T_\text{comms} = \frac{\text{Communication Bytes}}{\text{Network/Memory Bandwidth Bytes/s}} \end{equation}$$通常(但并非总是),单个芯片内的计算可以与芯片内和芯片间的通信重叠。这意味着我们可以使用计算和通信时间的最大值给出训练和推理时间的下界。我们也可以用它们的和给出上界。在实践中,我们以最大值为优化目标,因为代数表达更简单,并且通过让通信和计算重叠通常可以接近这个界。如果我们以最大值为目标进行优化,那么下界和上界最多相差 2 倍,因为 $T_\text{math} + T_\text{comms} \leq 2 * \max(T_\text{math}, T_\text{comms})$。我们随后通过建模"重叠区域"和开销来进一步提高精度,这可以通过对你的特定模型和目标系统进行 profile 来获得信息。
$$\begin{equation} T_\text{lower}=\max(T_\text{math}, T_\text{comms}) \end{equation}$$$$\begin{equation} T_\text{upper} = T_\text{math} + T_\text{comms} \end{equation}$$如果我们假设可以完美地重叠通信和计算,那么当 $T_\text{math} > T_\text{comms}$ 时,我们能从硬件中获得完整的利用率。我们称这种情况为"compute-bound(计算受限)"。当 $T_\text{comms} > T_\text{math}$ 时,我们往往是"communication-bound(通信受限)",加速器至少有一部分 FLOPs/s 因等待数据传输而被浪费。判断一个操作是计算受限还是通信受限的一种方法是查看其"arithmetic intensity(算术强度)“或”operational intensity(操作强度)"。
定义: 一个算法的 arithmetic intensity(算术强度)由其执行的总 FLOPs 数与需要通信的字节数(无论是芯片内还是芯片间)的比值给出。
$$\begin{equation} \text{Arithmetic Intensity} = \frac{\text{Computation FLOPs}}{\text{Communication Bytes}} \end{equation}$$算术强度衡量的是给定操作的"每字节 FLOPs 数"。一阶近似下,当算术强度较高时,$T_\text{math}$ 相对于 $T_\text{comms}$ 较大,我们通常会用满大部分可用 FLOPs。反之,我们就会在通信上花费更多时间,浪费 FLOPs。这个临界点就是我们硬件的"peak arithmetic intensity(峰值算术强度)",即峰值加速器 FLOPs/s 与加速器带宽的比值。
$$\begin{align*} T_\text{math} > T_\text{comms} \Leftrightarrow \frac{\text{Computation FLOPs}} {\text{Accelerator FLOPs/s}} > \frac{\text{Communication Bytes}}{\text{Bandwidth Bytes/s}} & \\[0.5em] \Leftrightarrow \frac{\text{Computation FLOPs}}{\text{Communication Bytes}} > \frac{\text{Accelerator FLOPs/s}}{\text{Bandwidth Bytes/s}} & \\[0.5em] \Leftrightarrow \text{Intensity}(\text{Computation}) > \text{Intensity}(\text{Accelerator}) & \\ \end{align*}$$$\text{Intensity}(\text{Accelerator})$ 这个量是加速器达到其峰值 FLOPs/s 时对应的算术强度。对于 TPU v5e MXU 来说,这大约是 240 FLOPs/byte,因为 TPU 可以执行 1.97e14 FLOPs/s,并能从 HBM 加载 8.2e11 字节/秒。这意味着如果一个算法的算术强度低于 240 FLOPs/byte,它将受限于字节加载,因此我们无法很好地利用硬件。让我们看一个这样的例子:
示例(点积): 要在 bfloat16 精度下计算两个向量的点积 x • y: bf16[N], bf16[N] → bf16[1],我们需要从内存中加载 $x$ 和 $y$,每个有 $2 * N = 2N$ 字节,执行 $N$ 次乘法和 $N-1$ 次加法,并将 $2$ 字节写回 HBM。
当 $N\rightarrow\infty$ 时。所以点积的算术强度是 $\frac{1}{2}$,换句话说,点积每加载一个字节执行 0.5 次浮点运算。这意味着我们的算术强度低于硬件强度,我们将是通信受限的。
可视化 roofline(Visualizing rooflines)#
我们可以用一张 roofline plot(roofline 图) 来可视化内存与计算之间的权衡,它绘制算法在硬件上可达到的峰值 FLOPs/s(吞吐量,y 轴)与该算法的算术强度(x 轴)之间的关系。下面是一个对数-对数图的例子:
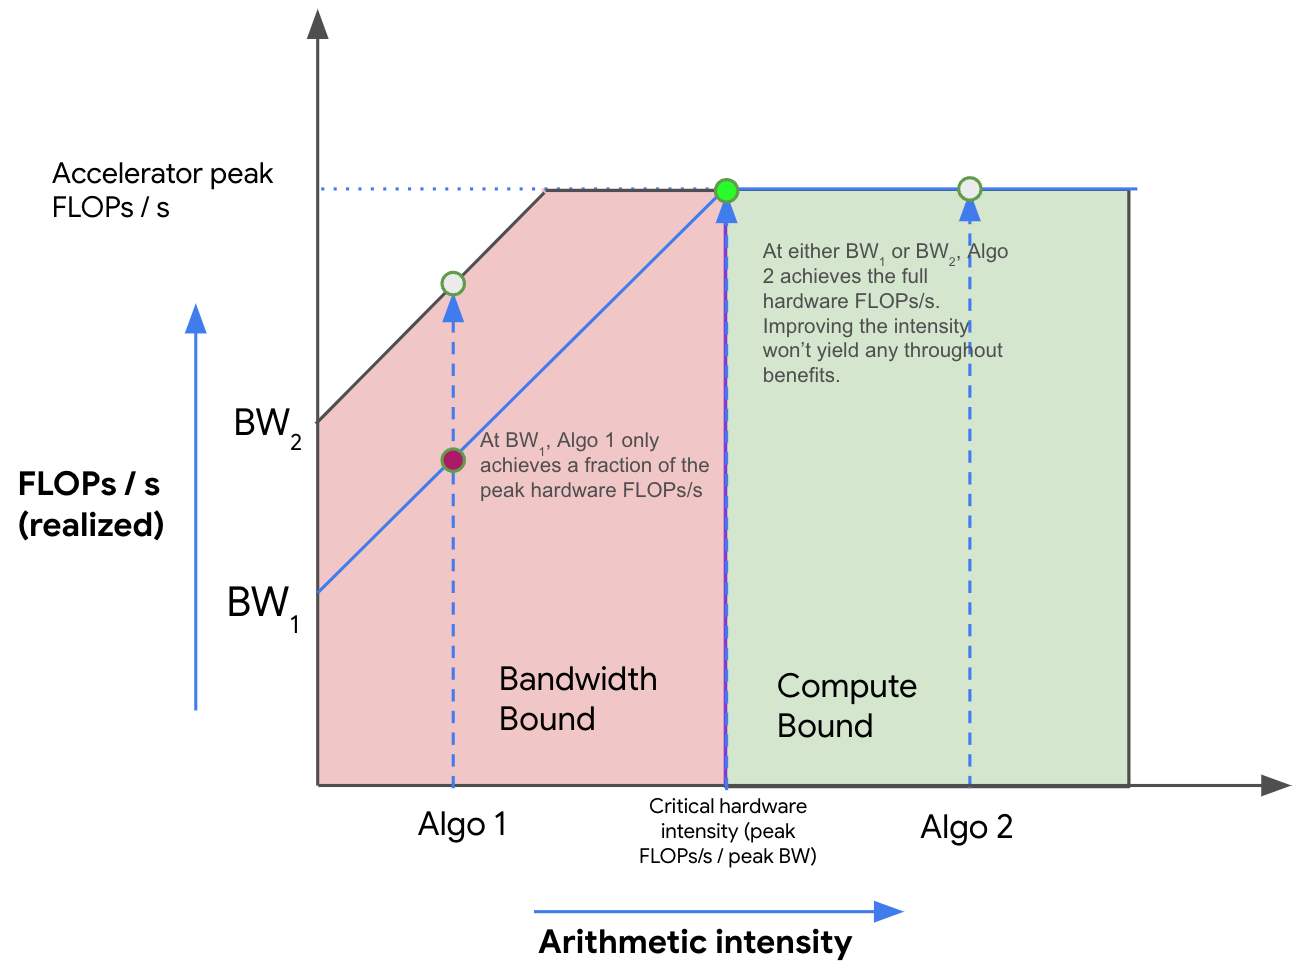
图: 一个 roofline plot 的例子,展示了两种具有不同算术强度的算法(Algo 1 和 Algo 2)以及它们在不同带宽(BW1 和 BW2)下对应的理论峰值吞吐量。在红色区域,算法在两种带宽下都是带宽受限,浪费了硬件峰值 FLOPs/s 的一部分。黄色区域只在较低带宽(BW1)下是带宽受限的。绿色区域在所有带宽下都是计算受限的。这里我们使用加速器的峰值 FLOPs/s,进一步增加带宽或提高强度都不会带来好处。
如上图所示,随着强度增加(从左到右移动),我们最初看到算法性能(以 FLOPs/s 计)线性增长,直到达到硬件的临界算术强度,对于 TPU v5e 来说是 240。任何强度低于此值的算法都将是带宽(BW)受限,受限于峰值内存带宽(红色显示)。任何在右侧的算法都将充分利用我们的 FLOPs(绿色显示)。这里,Algo 1 是通信受限的,只使用了硬件总 FLOPs/s 的一部分。Algo 2 是计算受限的。我们通常可以通过提高算法的算术强度或增加可用内存带宽(从 BW1 移动到 BW2)来改善算法的性能。
矩阵乘法(Matrix multiplication)#
让我们看看我们即将最钟爱的算法:matrix multiplication(矩阵乘法,又称 matmul)。我们记 $X * Y \rightarrow Z$,其中 $X$ 形状为 $\text{bf16}[B, D]$,$Y$ 形状为 $\text{bf16}[D, F]$,$Z$ 形状为 $\text{bf16}[B, F]$。要进行矩阵乘法,我们需要加载 $2DF + 2BD$ 字节,执行 $2BDF$ FLOPs,并写回 $2BF$ 字节。因此:
$$\begin{equation} \text{Intensity}(\text{matmul}) = \frac{2BDF}{2BD + 2DF + 2BF} = \frac{BDF}{BD + DF + BF} \end{equation}$$如果我们假设"batch size(批量大小)" $B$ 相对于 $D$ 和 $F$ 较小,可以得到一个不错的简化:
$$\begin{equation} \frac{BDF}{BD + DF + BF} \approx \frac{BDF}{DF} = B \end{equation}$$$$\begin{equation} \text{Intensity}(\text{matmul}) > \text{Intensity}(\text{TPU}) \implies B > \frac{1.97e14}{8.20e11} = 240 \end{equation}$$对于 Transformer 矩阵乘法来说这是一个合理的假设,因为我们通常有 local(per-replica)batch size $B < 1024$ tokens(而不是序列),但 $D$ 和 $F > 8000$。因此,当我们的 per-replica batch size 大于 240 个 token 时,我们通常变为计算受限,这是一条非常简单的规则!
要点: 对于 bfloat16 矩阵乘法在大多数 TPU 上达到计算受限,我们需要 per-replica token batch size 大于 240。
这有一些值得注意的注意事项,我们将在下面的练习题中探讨,特别是关于 quantization(量化)的(例如,如果我们量化激活但仍然进行全精度 FLOPs)。但这是一条值得记住的好规则。对于 GPU,这个数字稍高(接近 300),但同样的结论一般成立。当我们将一个大的 matmul 分解为更小的 matmul 时,tile 大小也很重要。
网络通信 roofline(Network communication rooflines)#
到目前为止我们讨论的所有 roofline 都是内存带宽 roofline,全部是在单个芯片内。这不应被视为一个规则。事实上,本书中我们关心的大多数 roofline 都涉及芯片间通信:通常是分片在多个 TPU 上的矩阵乘法。
举一个略显刻意的例子,假设我们要乘两个大矩阵 $X\sim \text{bfloat16[B, D]}$ 和 $Y \sim \text{bfloat16[D, F]}$,它们沿 $D$ 维度均匀分布在 2 个 TPU/GPU 上。要进行这个乘法(正如我们将在第 3 节中看到的),我们可以在每个 TPU 上乘半个矩阵(在 TPU 0 上 A = X[:, :D // 2] @ Y[:D // 2, :],在 TPU 1 上 B = X[:, D // 2:] @ Y[D // 2:, :]),然后将得到的"partial sums(部分和)“复制到另一个 TPU 上并相加。假设我们可以在每个方向上以 4.5e10 字节/秒的速度复制,并在每个芯片上执行 1.97e14 FLOPs/s。$T_\text{math}$ 和 $T_\text{comms}$ 分别是多少?
$T_\text{math}$ 显然是之前的一半,因为每个 TPU 完成一半的工作,即
$$T_\text{math} = \frac{2BDF}{2 \cdot \text{Accelerator FLOPs/s}} = \frac{BDF}{1.97e14}$$那么 $T_\text{comms}$ 呢?这现在指的是芯片间的通信时间!这就是发送的总字节数除以网络带宽,即
$$T_\text{comms} = \frac{2BF}{\text{Network Bandwidth}} = \frac{2BF}{4.5e10}$$因此,当 $\text{Intensity}(\text{matmul (2-chips)}) > \text{Intensity}(\text{TPU w.r.t. inter-chip network})$,或者等价地,当 $\frac{BDF}{2BF} = \frac{D}{2} > \frac{1.97e14}{4.5e10} = 4377$ 或 $D > 8755$ 时,我们变为计算受限(现在是相对于芯片间网络)。注意,与之前不同的是,临界阈值现在依赖于 $D$ 而不是 $B$!想想为什么会这样。这只是一个例子,但我们要强调,这种 roofline 对于了解何时可以在多个 TPU 上并行化一个操作至关重要。
一些练习题(A Few Problems to Work)#
问题 1 [int8 matmul]: 假设我们想用 int8 精度(每个参数 1 字节)而不是 bfloat16(每个参数 2 字节)进行矩阵乘法 $X[B, D] \cdot_D Y[D, F] \rightarrow Z[B, F]$,因为 TPU/GPU 在较低精度下可以更快地执行矩阵乘法。
- 需要从内存加载多少字节?需要写回内存多少字节?
- 总共执行多少 OPs?
- 算术强度是多少?
- $T_\text{math}$ 和 $T_\text{comms}$ 的 roofline 估计是什么?整个操作运行时间的合理上下界是什么?
假设 HBM 带宽为 8.1e11 字节/秒,int8 峰值 OPs/s 为 3.94e14(约为 bfloat16 的 2 倍)。
点击查看答案。
- 因为我们用 int8 存储参数,每个参数 1 字节,所以从 HBM 加载 $BD + DF$ 字节,写回 $BF$ 字节。
- 这与 bfloat16 相同,但理论上 int8 OPs/s 应该更快。所以仍然是 $2BDF$ FLOPs。
- 算术强度是 $2BDF / (BD + DF + BF)$。如果我们做与上面相同的假设 $B \ll D$ 且 $B \ll F$,我们得到算术强度为 $2B$,这意味着我们的规则变为 $B > \text{HBM int8 arithmetic intensity} / 2$。使用给定的数字,这个 int8 强度为
3.94e14 / 8.1e11 = 486,所以规则是 $B > 486 / 2 = 243$。注意这基本上没变! - $T_\text{math} = 2BDF / 3.94e14$ 且 $T_\text{comms} = (BD + DF + BF) / 8.1e11$,所以一个合理的下界是 $\max(T_\text{math}, T_\text{comms})$,上界是 $T_\text{math} + T_\text{comms}$。
问题 2 [int8 + bf16 matmul]: 在实践中我们经常对权重和激活做不同的量化,所以我们可能将权重存储在非常低的精度,但保持激活(和计算)在更高的精度。假设我们想将权重量化为 int8 但保持激活(和计算)在 bfloat16。在什么 batch size 下我们变为计算受限?假设 1.97e14 bfloat16 FLOPs/s。
提示:这具体意味着 bfloat16[B, D] * int8[D, F] -> bfloat16[B, F],其中 $B$ 是"batch size”。
点击查看答案。
再次假设 B 很小,我们有 2BDF bfloat16 FLOPs,但只有 DF 个权重(而不是 bfloat16 中的 2DF)。这意味着当 $2B > 240$ 或 $B > 120$ 时我们变为计算受限。这低很多,意味着如果我们能做 int8 权重量化(这相对容易做到)但仍然进行 bfloat16 FLOPs,我们在效率上获得有意义的提升(虽然 int8 OPs 会更好)。
问题 3: 沿用问题 2 的设置,绘制 $F = D = 4096$ 和 $F = D = 1024$ 时峰值 FLOPs/s 与 $B$ 的 roofline 图。使用精确的加载字节数,而不是近似值。
点击查看答案。
这是问题中的图:
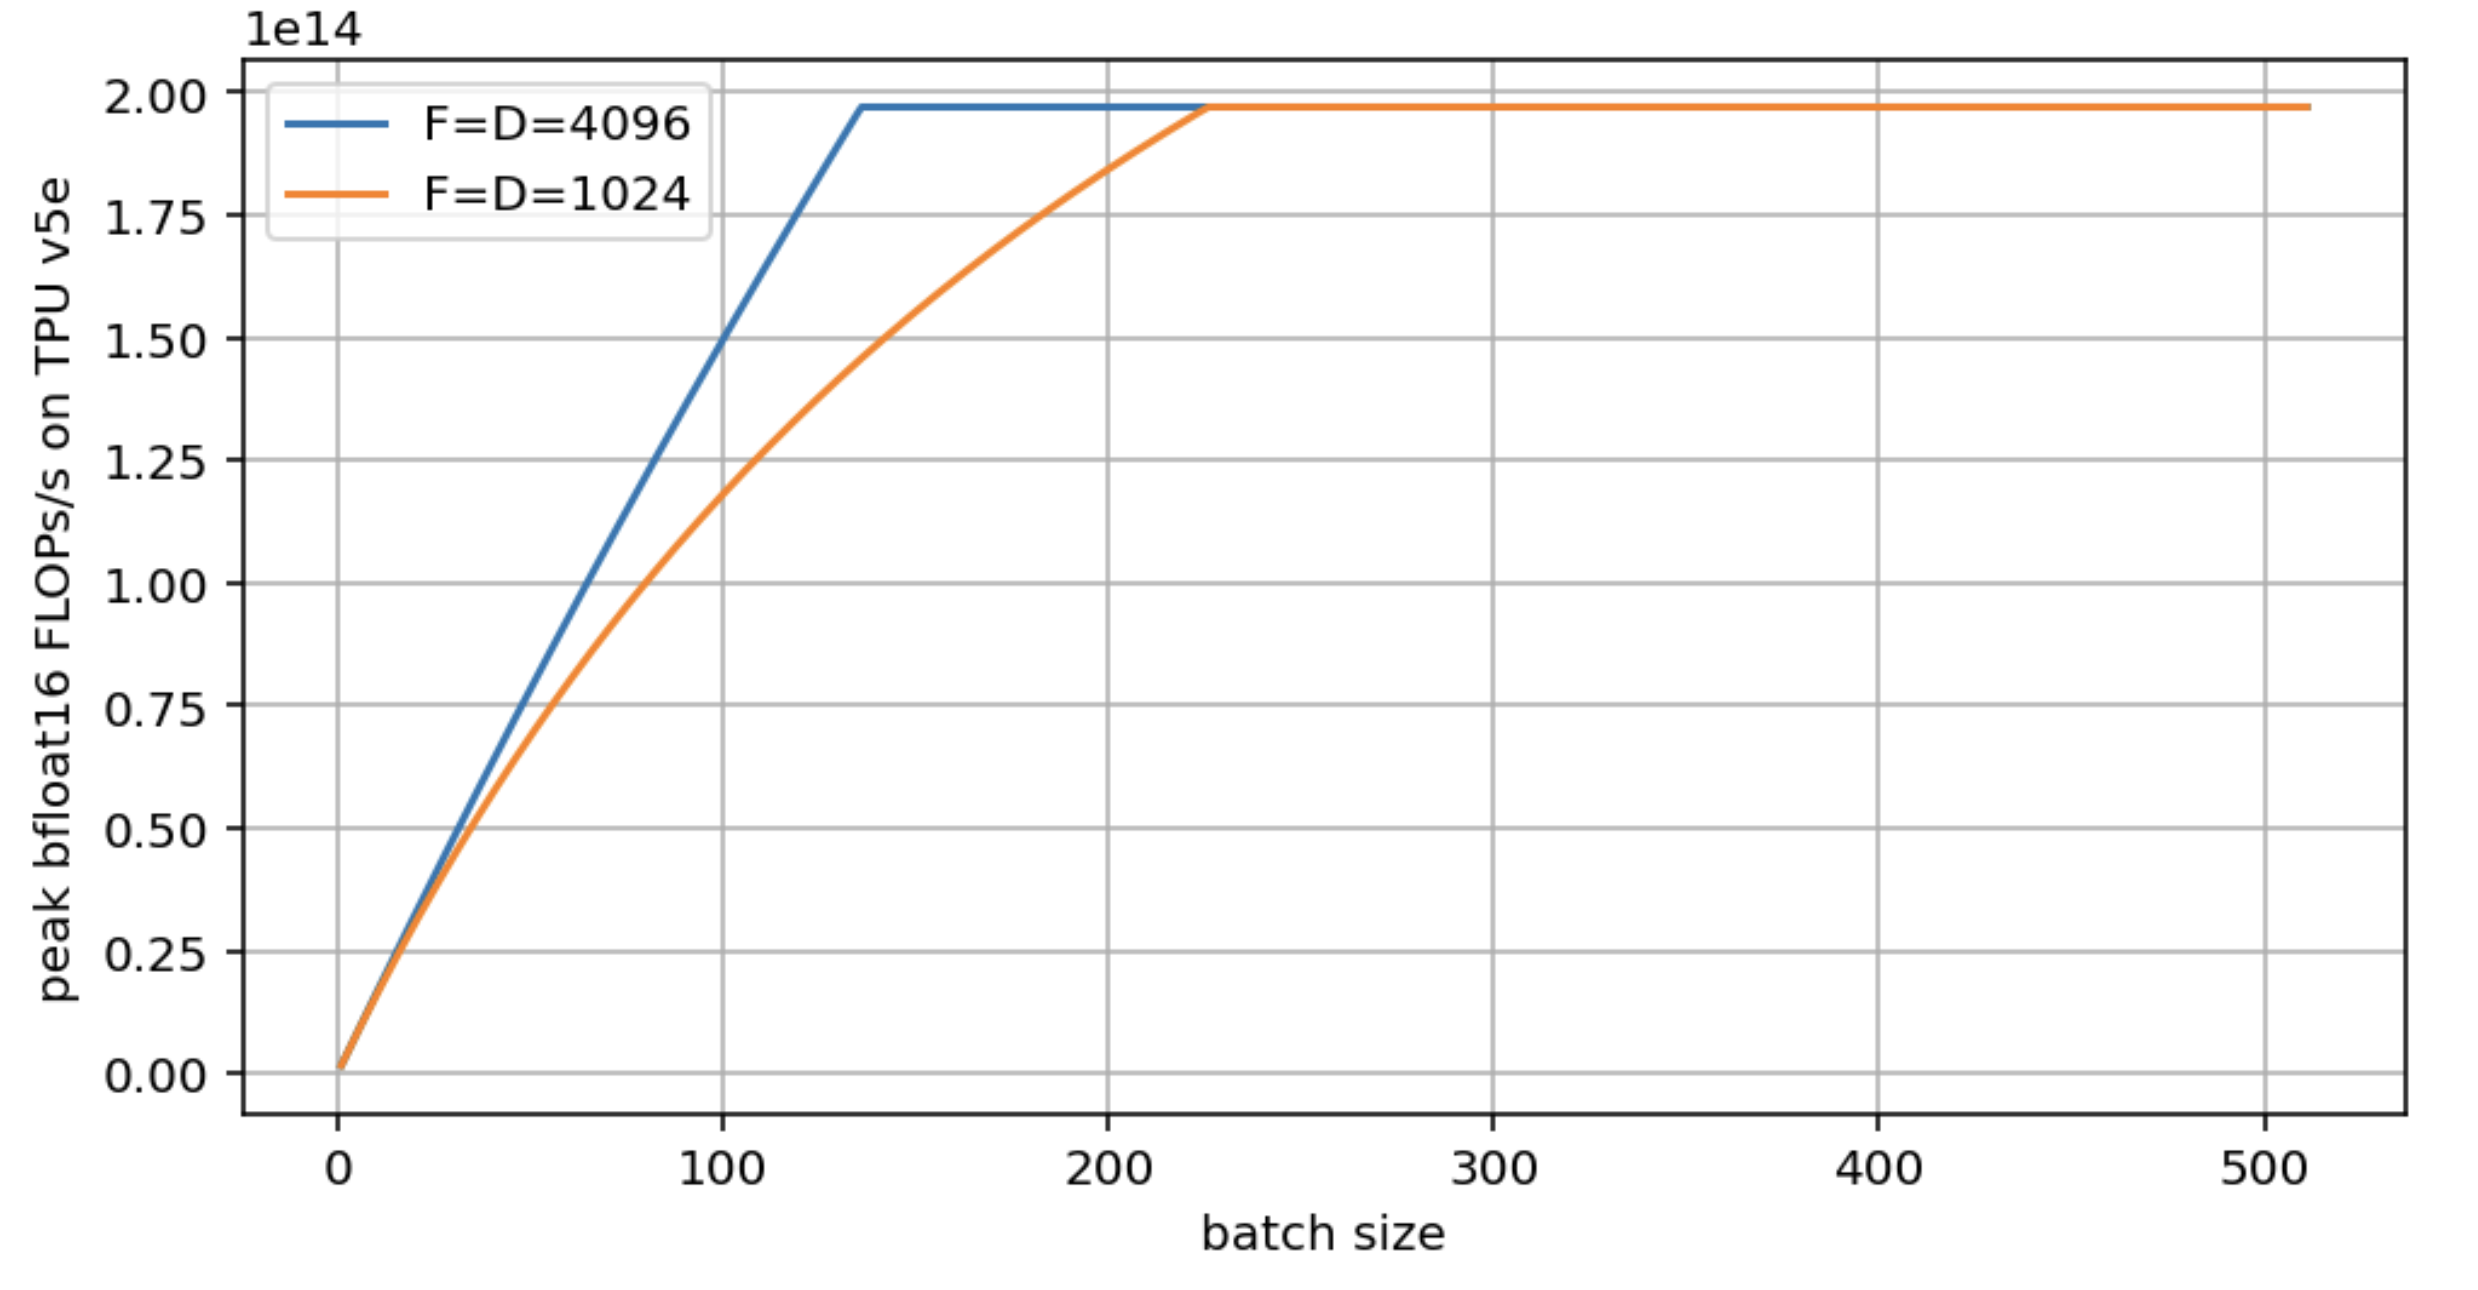
注意,两个模型最终都达到了硬件峰值 FLOPs/s,但更大的 D/F 更早达到。D=F=1024 几乎使临界 batch size 翻倍。生成这个图的代码如下:
import matplotlib.pyplot as plt
import numpy as np

bs = np.arange(1, 512)

def roofline(B, D, F):
  total_flops = 2*B*D*F
  flops_time = total_flops / 1.97e14
  comms_time = (2*B*D + D*F + 2*B*F) / 8.2e11
  total_time = np.maximum(flops_time, comms_time)
  return total_flops / total_time

roofline_big = roofline(bs, 4096, 4096)
roofline_small = roofline(bs, 1024, 1024)

plt.figure(figsize=(8, 4))
plt.plot(bs, roofline_big, label='F=D=4096')
plt.plot(bs, roofline_small, label='F=D=1024')
plt.legend()
plt.xlabel('batch size')
plt.ylabel('peak bfloat16 FLOPs/s on TPU v5e')
plt.grid()
问题 4: 如果我们想执行 $\text{int8[B, D]} *_D \text{int8[B, D, F]} \rightarrow \text{int8[B, F]}$,即设想为每个 batch 元素配一个不同的矩阵。这个操作的算术强度是多少?
点击查看答案。
让我们从查看总 FLOPs 和通信开始。
- 总 FLOPs:FLOPs 基本相同,因为我们做的是相同数量的 $BD \times DF$ matmul(这在第 4 节中有更多讨论)。所以这就是 $2BDF$。
- 总通信:这里我们有更多的通信:$BD + BDF + BF$。
- 因此,我们的算术强度现在实际上是 $2BDF / (BD + BDF + BF)$。由于 $BDF$ 主导分母,这大致是 $2$。所以与依赖于 batch size 不同,这实际上是一个常数。这很糟糕,因为这意味着无论如何我们基本上总是通信受限的。
问题 5 [GPU 的内存 Roofline]: 使用 NVIDIA 提供的 H100 SXM 规格表,计算 bfloat16 矩阵乘法变为计算受限时的 batch size。注意 Tensor Core FLOPs 数字是真实值的两倍,因为它们只能在结构化稀疏性下达到。
点击查看答案。
从规格表中可以看到,报告的 bfloat16 FLOPs 值为 1.979e15 FLOPs/s,带星号注明"with sparsity(带稀疏性)"。没有稀疏性的真实值是这个的一半,意味着接近 1e15 FLOPs/s。内存带宽是 3.35TB/s,即 3.35e12 字节/秒。因此 $B_\text{crit}$ 为 1e15 / 3.35e12 = 298,与 TPU 相当类似。
第 1 部分到此结束!第 2 部分我们将看看真实的 TPU 如何处理 FLOPs 和通信,点击这里。