用 JAX 编程 TPU(Programming TPUs in JAX)#
《How To Scale Your Model》第 10 部分(第 9 部分:性能分析 | 第 11 部分:结论)
如何使用 JAX 高效地为 TPU 编程!本节内容大部分参考自这里。你可以在 Google Colab 上使用免费的 TPU 运行本节的代码示例。
目录
JAX 中的并行机制是如何工作的?#
JAX 为多设备编程提供了三种思路:
- 让编译器掌舵! 让 XLA 编译器自动对数组进行分区,并决定为给定程序添加什么样的通信。这让你可以把一个在单设备上运行的程序,自动扩展到数千个设备上运行而无需修改任何代码。
- 让 JAX 掌舵! 自动并行很棒,但有时编译器会做一些奇怪的事情。显式分片(Explicit sharding)让你可以像往常一样编写单设备代码,但由 JAX(而非编译器)来处理分片传播。这意味着当你的意图不明确时,JAX 可以向你寻求澄清。
- 让我直接写我想要的,别废话! 编译器虽然不错,但有时会做错事情,添加你并不希望的通信。有时我们希望明确地指定要执行哪些通信。
| 模式 | 视角 | 显式分片? | 显式集合通信? |
|---|---|---|---|
| Auto | 全局 | ❌ | ❌ |
| Explicit | 全局 | ✅ | ❌ |
| Manual | 每设备 | ✅ | ✅ |
相应地,JAX 为这些模式提供了对应的 API:
jax.jit(搭配Automesh 轴)让你可以把任何现有的 JAX 函数用分片输入来调用。然后 JAX 使用 XLA 的 Shardy 编译器自动并行化程序。XLA 会在需要时为你添加通信(AllGather、ReduceScatter、AllReduce 等)以支持现有操作。虽然不完美,但通常能在不修改代码的情况下,把你的程序自动扩展到任意数量的芯片上。jax.jit搭配Explicitmesh 轴看起来与 (1) 类似,但让 JAX(而不是 XLA)来处理分片传播。这意味着数组的分片实际上是 JAX 类型系统的一部分,JAX 在检测到模糊的通信时可以报错,让用户来解决。jax.shard_map是更手动的方式。你获得程序的设备本地视角,必须显式地写出所有想要的通信。有一个分片数组想让每个设备都拿到完整数据?添加一个jax.lax.all_gather。想跨设备求和数组?添加一个jax.lax.psum(即 AllReduce)。编程更难,但更不容易做出你不想要的事情。
自动分片模式(Auto sharding mode)#
jax.jit 在 JAX 内部扮演两种角色。顾名思义,它"即时"(just-in-time)将一个 Python 函数编译成字节码(通过 XLA/HLO/LLO),让它运行得更快。但如果输入是分片的,或者用户指定了 in_sharding 或 out_sharding,它还会让 XLA 把计算分布到多个设备上,并按需添加通信。例如,下面是用 jax.jit 编写一个分片矩阵乘法的方式:
import jax
import jax.numpy as jnp

# Running on a TPU v5e 4x2. This assigns names to the two physical axes of the hardware.
mesh = jax.make_mesh(axis_shapes=(4, 2), axis_names=('X', 'Y'))

# This tells JAX to use this mesh for all operations, so you can just specify the PartitionSpec P.
jax.set_mesh(mesh)

# We create a matrix W and input activations In sharded across our devices.
In = jnp.zeros((8, 2048), dtype=jnp.bfloat16, device=jax.NamedSharding(mesh, jax.P('X', 'Y')))
W = jnp.zeros((2048, 8192), dtype=jnp.bfloat16, device=jax.NamedSharding(mesh, jax.P('Y', None)))

def matmul_square(In, W):
  return jnp.einsum('bd,df->bf', jnp.square(In), W)

# We can explicitly compile the sharded matmul function here. This adds all the
# necessary comms (e.g. an AllReduce after the matmul).
jit_matmul = jax.jit(matmul_square, out_shardings=jax.P('X', None)).lower(In, W).compile()

out = jit_matmul(In, W)这段代码会自动处理任意分片,并把计算分区到我们的设备上。但在硬件层面到底发生了什么?
- 首先我们创建跨设备分片的 In 和 W。W 沿收缩维度被切成 2 份,而 In 被切成 4 份(沿收缩维度和输出维度)。这对应于分片 W[DY, F] 和 In[BX, DY],相当于一种模型并行与数据并行的组合。
- 如果在本地(即在一个设备上)运行,
matmul_square只会简单地对输入求平方然后做一次普通的矩阵乘法。但因为我们指定了out_shardings为P('X', None),输出将沿 batch 维度分片但在模型维度上复制,需要一次 AllReduce 来计算。
用我们之前章节的记号,这大致会做:
- Out[BX, F] { UY } = In[BX, DY] *D W[DY, F]
- Out[BX, F] = AllReduce(Out[BX, F] { UY })
jax.jit 会自动为我们添加这一步!我们实际上可以用 jit_matmul.as_text() 打印出 HLO,看到下面的内容(大幅省略后):
# This fusion is the actual matmul of the sharded inputs and matrix
%fusion = bf16[2,8192]{1,0:T(4,128)(2,1)S(1)} fusion(bf16[2,1024]{1,0:T(4,128)(2,1)} %param, bf16[8192,1024]{1,0:T(8,128)(2,1)S(1)} %copy-done)

# We reduce the partially summed results across devices
ROOT %AllReduce = bf16[2,8192]{1,0:T(4,128)(2,1)} AllReduce(bf16[2,8192]{1,0:T(4,128)(2,1)S(1)} %fusion)
我们可以看到上面的矩阵乘法(fusion)和 AllReduce。特别注意一下形状。bf16[2, 1024] 是激活的本地视角,因为我们的 batch_size=8 被分到 4 个设备上,而 d_model=2048 同样被切成 2 份。
这真的很神奇! 无论我们的程序多复杂,Shardy 和 jit 都会尝试为所有中间激活找到分片方案,并在需要时添加通信。话虽如此,Shardy 并不完美。它也会犯错。有时你查看一个性能分析(profile),会发现某些地方出了问题。一个巨大的 AllGather 占据了 80% 的运行时间,而它本不必如此。当出现这种情况时,我们可以尝试用 jax.lax.with_sharding_constraint 显式地为中间张量添加注解来纠正编译器。例如,对于两个矩阵乘法,我可以用下面的方法强制中间激活沿 y 维度分片(不是说这是个好主意):
import jax
import jax.numpy as jnp

mesh = jax.make_mesh((4, 2), ('X', 'Y'))

def matmul(x, Win, Wout):
  hidden = jnp.einsum('bd,df->bf', x, Win)
  hidden = jax.lax.with_sharding_constraint(hidden, jax.P('X', 'Y'))
  return jnp.einsum('bf,df->bd', hidden, Wout)
在自动分区的世界里,通过 jax.lax.with_sharding_constraint 控制中间分片,这大约占 JAX 并行编程的 60%。但"取悦编译器"(compiler tickling)是一种众所周知不那么有趣的编程模型。你可以为每个中间变量添加注解,但仍然不知道是否能得到正确的结果。那么,能不能让 JAX 自己来处理和控制分片传播呢?
显式分片模式(Explicit sharding mode)#
显式分片(或称"类型中的分片")看起来很像自动分片,但分片传播发生在 JAX 层面!每个 JAX 操作都有一个分片规则,它接收操作参数的分片,并产生操作结果的分片。你可以使用 jax.typeof 查看得到的分片:
import jax
import jax.numpy as jnp
import jax.sharding as shd
import numpy as np

# Running on a TPU v5e 2x2. This assigns names to the two physical axes of the hardware.
mesh = jax.make_mesh(axis_shapes=(2, 2), axis_names=('X', 'Y'),
                                       axis_types=(shd.AxisType.Explicit, shd.AxisType.Explicit))

# This tells JAX to use this mesh for all operations, so you can just specify the PartitionSpec P.
jax.set_mesh(mesh)

x = jax.device_put(np.arange(16).reshape(8, 2), jax.P('X', 'Y'))

@jax.jit
def f(x):
  print(jax.typeof(x))  # bfloat16[8@X,2@Y]
  out = x * 2
  print(jax.typeof(out))  # bfloat16[8@X,2@Y]
  return out

f(x)
如你所见,JAX 把分片从输入(x)传播到了输出(x),可以在 trace 阶段通过 jax.typeof 检查。对于大多数操作,这些规则简单且显而易见,因为只有一个合理的选择(例如逐元素操作保持相同的分片)。但对于某些操作来说,结果该如何分片是模糊的,这种情况下 JAX 会在 trace 时抛出错误,要求程序员显式提供 out_sharding 参数(例如 jnp.einsum、jnp.reshape 等)。让我们看另一个有冲突的例子:
# We create a matrix W and input activations In sharded across our devices.
In = jnp.zeros((8, 2048), dtype=jnp.bfloat16, out_sharding=jax.P('X', 'Y'))
W = jnp.zeros((2048, 8192), dtype=jnp.bfloat16, out_sharding=jax.P('Y', None))

@jax.jit
def matmul_square(In, W):
  print(jax.typeof(In))  # bfloat16[8@X, 2048@Y]
  print(jax.typeof(W))  # bfloat16[2048@Y, 8192]
  return jnp.einsum('bd,df->bf', jnp.square(In), W)

matmul_square(In, W) # This will error这段代码会报错:Contracting dimensions are sharded and it is ambiguous how the output should be sharded. Please specify the output sharding via the out_sharding parameter. Got lhs_contracting_spec=('Y',) and rhs_contracting_spec=('Y',)
这非常棒,因为 einsum 的输出该如何分片是模糊的。输出分片可以是:
- P(‘X’, ‘Y’),这会引发一个 reduce-scatter;或者
- P(‘X’, None),这会引发一个 all-reduce。
与 Auto 模式不同,Explicit 模式在检测到模糊通信时会报错,要求用户解决。所以这里你可以这样写:
@jax.jit
def matmul_square(In, W):
  return jnp.einsum('bd,df->bf', jnp.square(In), W, out_sharding=jax.P('X', 'Y'))

out = matmul_square(In, W)
print(jax.typeof(out))  # bfloat16[8@X,8192@Y]
Auto 模式和 Explicit 模式可以通过 jax.sharding.auto_axes 和 jax.sharding.explicit_axes API 组合使用。这篇文档非常值得一读,可以了解更多信息。
shard_map:对程序进行显式并行控制#
如果说 Shardy 是"让编译器掌舵"模式,那么 jax 的 shard_map 就是把一切都交到你手里。你像在 jax.jit 中一样指定输入的分片,但接下来你要显式地写出所有通信。jax.jit 给你的是程序的全局跨设备视角,而 shard_map 给你的是每个设备的本地视角。
下面是一个例子。试着推理一下这个函数的功能:
import jax
import jax.numpy as jnp
import jax.sharding as shd

mesh = jax.make_mesh((2, 4), ('x', 'y'), (shd.AxisType.Explicit, shd.AxisType.Explicit))
jax.set_mesh(mesh)

x = jnp.arange(0, 512, dtype=jnp.int32, out_sharding=jax.P(('x', 'y')))

# This function will operate on 1/8th of the array.
@jax.shard_map(in_specs=jax.P(('x', 'y')), out_specs=jax.P())
def slice_and_average(x):
  assert x.shape == (512 // 8,)
  return jax.lax.pmean(x[:4], axis_name=('x', 'y'))

out = slice_and_average(x)
assert out.shape == (4,)
这个函数做了什么? slice_and_average 在每个 TPU 上对数组的 1/8 进行操作,从中切出前 4 个元素,然后在整个 mesh 上对它们求平均。这意味着我们实际上是在做 mean(x[:4], x[64:68], x[128:132], …)。这非常酷,因为这种操作在 JAX 中其他方式很难表达。
为什么用这个而不是 jax.jit? 如果用 jax.jit,slice_and_average 会看到数组的全局视角(完整的 [512,] 数组)。我们必须切出这个非均匀切片,然后做平均,XLA 必须正确地解释这一切。XLA 可能会添加错误的通信或者搞混。在这里我们看到的是本地视角,只写我们需要的通信。
示例 [Collective Matmul]: 来举一个更现实的例子,假设我们想实现模型并行,激活最初是按模型分片的,即 A[BX, DY] * W[D, FY] -> Out[BX, FY]。最朴素的做法是先 AllGather A,然后做本地矩阵乘法:
- A[BX, D] = AllGatherY(A[BX, DY])
- Out[BX, FY] = A[BX, D] *D W[D, FY]
可惜,这样做不好,因为我们无法将通信与计算重叠。可以通过"集合矩阵乘法(collective matmul)“实现重叠,详见 Wang et al. 2023。基本算法如下:
- 对每个 Y 分片,把 A 的本地块与 W 的本地块做矩阵乘法,得到形状为
[B / X, F / Y]的结果。同时,置换(permute)A,使下一块到达本地,再做矩阵乘法,并把结果累加。
我们可以用 jax.shard_map 很容易实现:
import functools

import jax
import jax.numpy as jnp
import jax.sharding as shd
import numpy as np

# This is intended to run on a TPU v5e-8 runtime. If you can't get this,
# try setting jax.config.update('jax_num_cpu_devices', 8).
#
mesh = jax.make_mesh(axis_shapes=(2, 4), axis_names=('X', 'Y'),
                                       axis_types=(shd.AxisType.Explicit, shd.AxisType.Explicit))
jax.set_mesh(mesh)

B, D, F = 1024, 2048, 8192
A = jnp.arange(np.prod((B, D))).reshape((B, D))
W = jnp.arange(np.prod((D, F))).reshape((D, F))

A = jax.device_put(A, jax.P('X', 'Y'))
W = jax.device_put(W, jax.P(None, 'Y'))

@functools.partial(jax.jit, out_shardings=jax.P('X', 'Y'))
def matmul(lhs, rhs):
  return lhs @ rhs

def collective_matmul_allgather_lhs_contracting(lhs, rhs):
  # lhs is the looped operand; rhs is the local operand
  axis_size = jax.lax.axis_size('Y')  # axis_size = 4 for this example
  idx = jax.lax.axis_index('Y')

  chunk_size = lhs.shape[1]
  assert rhs.shape[0] % chunk_size == 0

  def f(i, carrys):
    accum, lhs = carrys
    rhs_chunk = jax.lax.dynamic_slice_in_dim(rhs, (idx + i) % axis_size * chunk_size, chunk_size)
    # Matmul for a chunk
    update = lhs @ rhs_chunk
    # Circular shift to the left
    lhs = jax.lax.ppermute(
        lhs,
        axis_name='Y',
        perm=[(j, (j - 1) % axis_size) for j in range(axis_size)]
    )
    return accum + update, lhs

  accum = jnp.zeros((lhs.shape[0], rhs.shape[1]), dtype=lhs.dtype)
  accum = jax.lax.pvary(accum, ('X', 'Y'))
  accum, lhs = jax.lax.fori_loop(0, axis_size - 1, f, (accum, lhs), unroll=True)

  # Compute the last chunk after the final permute to leave lhs in the state we found it
  i = axis_size - 1
  rhs_chunk = jax.lax.dynamic_slice_in_dim(rhs, (idx + i) % axis_size * chunk_size, chunk_size)
  update = lhs @ rhs_chunk
  return accum + update

jit_sharded_f = jax.jit(jax.shard_map(
  collective_matmul_allgather_lhs_contracting,
  in_specs=(jax.P('X', 'Y'), jax.P(None, 'Y')), out_specs=jax.P('X', 'Y')))

shmapped_out = jit_sharded_f(A, W)
expected_out = matmul(A, W)

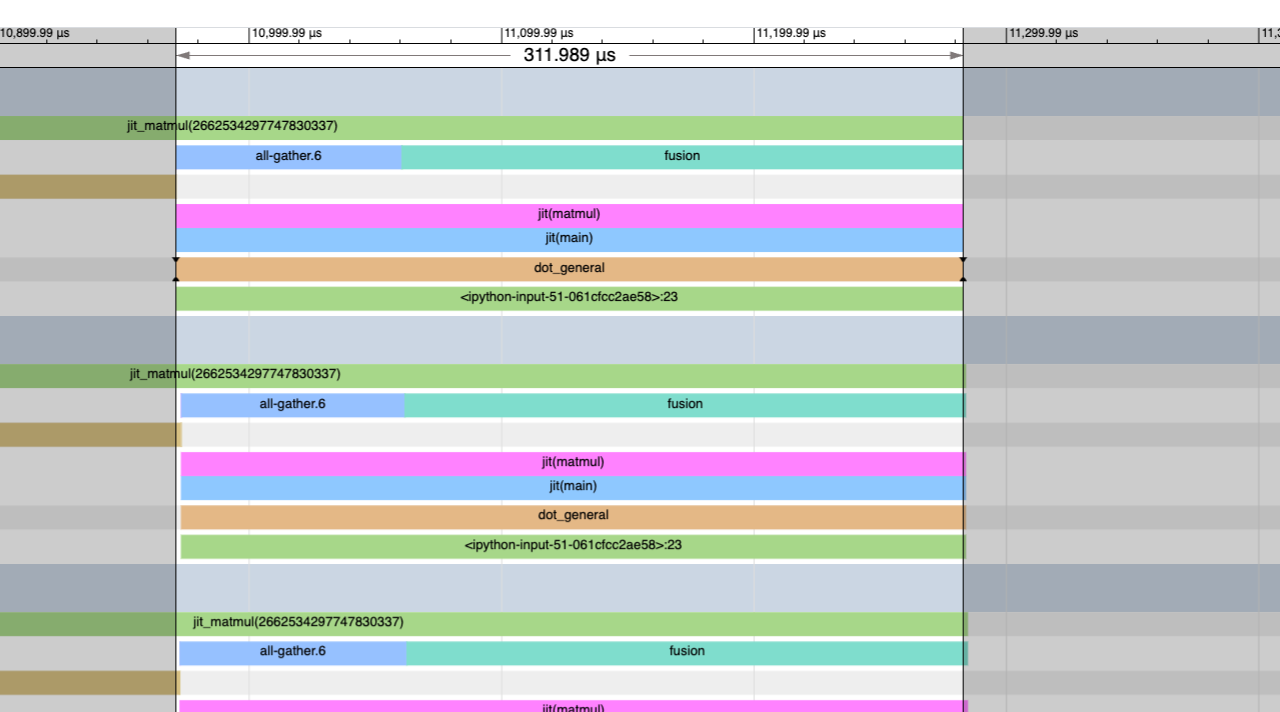
np.testing.assert_array_equal(shmapped_out, expected_out)这非常棒!我们可以基准测试一下,会发现它也快得多!这里是默认 jit 矩阵乘法的性能分析,耗时 311us,开头有一个巨大的阻塞 AllGather:
而这里是上面那个版本,耗时 244us。可以看到这个性能分析中没有了 AllGather。全部都是有用的工作!我们的 FLOPs 利用率也高得多。
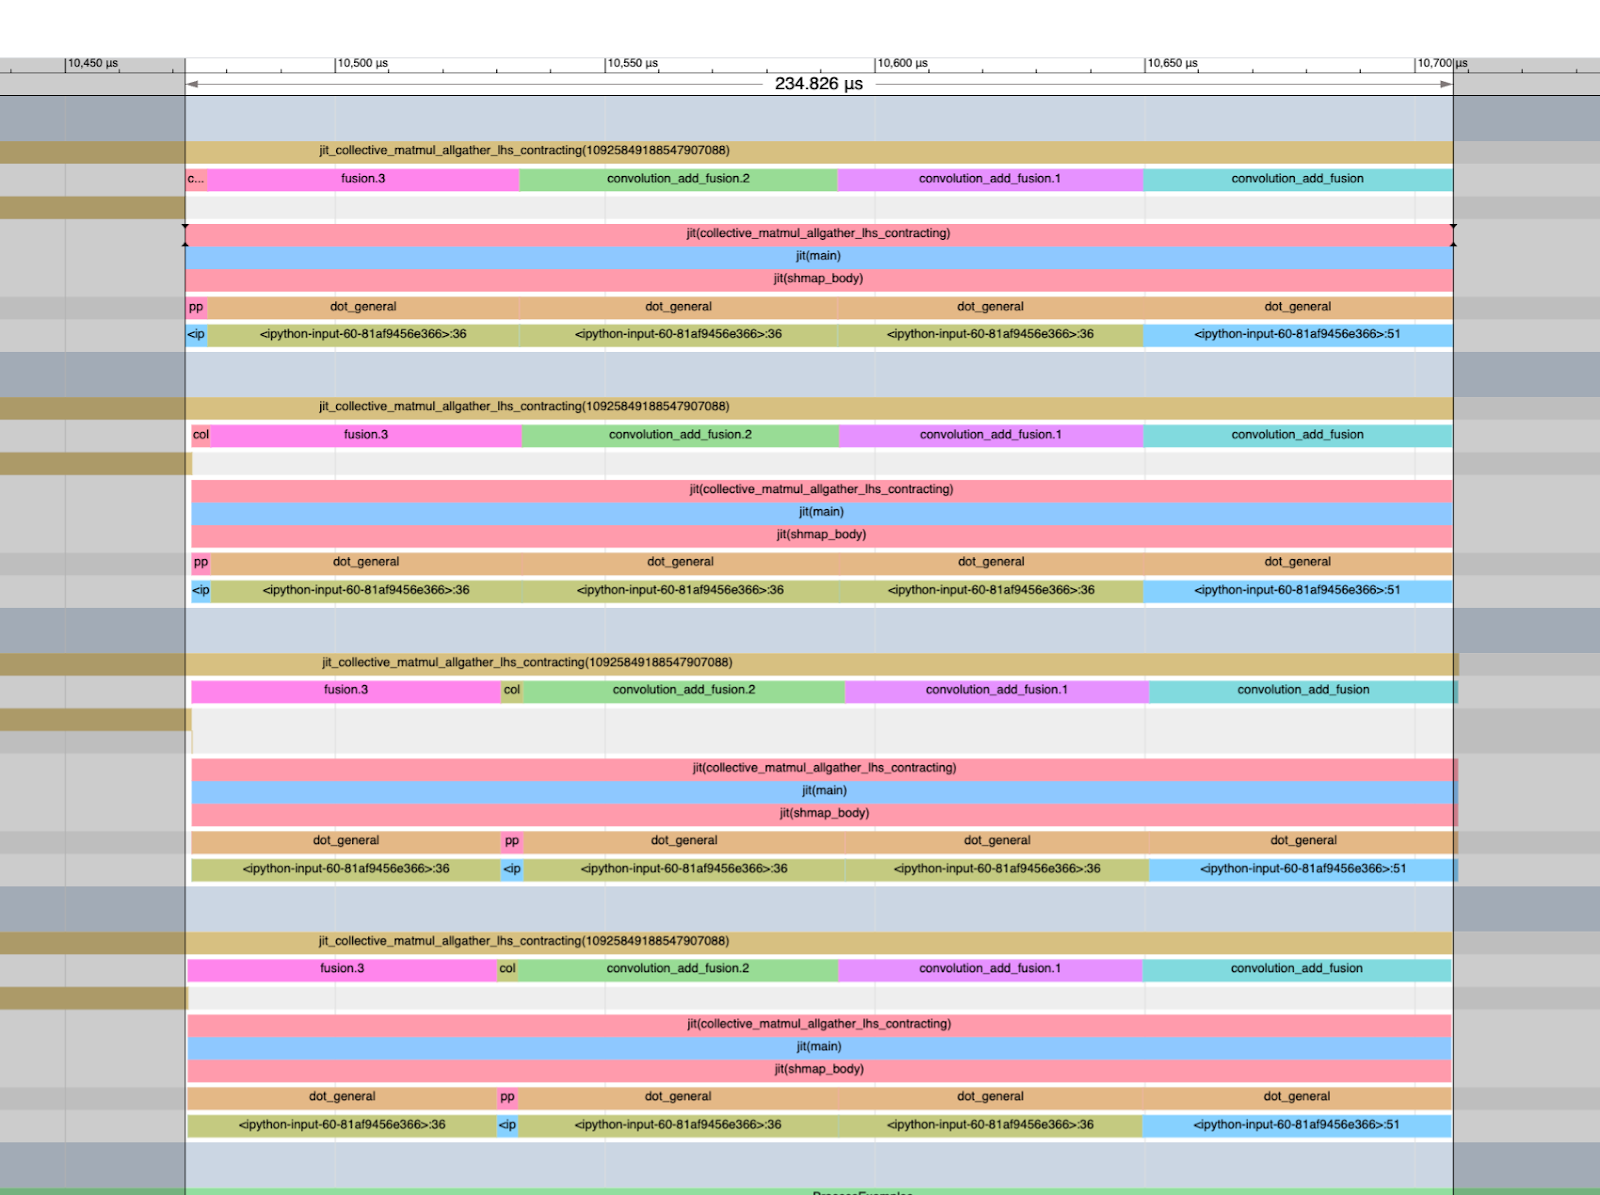
值得一提的是,没有沿收缩维度分片的矩阵乘法时间是 224us,所以我们这里非常接近未分片的基线。这是一个很好的例子,展示了为提升 TPU 利用率你可能要做的那种性能工程。更多 shard_map 的例子,这篇笔记很棒。
下面是一些值得用 jax.jit 或 shard_map 实现的有用实战问题!
实战问题(Worked Problems)#
这里有一些与 JAX 相关的随机问题。我之后会再加一些。所有这些都需要在 Colab 上有一定数量的 TPU。你可以用一个公开的 Colab,配 TPUv2-8。从现在起,我们假设你有 N 个设备可用。
问题 1: 设 A 是一个形状为 float32[SX, DY] 的激活数组,其中 X * Y = N。请完成以下任务:
用 JAX 编写一个函数,计算每个
(X, Y)分片内的平均值,即返回一个形状为 [X, Y] 的数组,其中arr[i, j]是分片(i, j)的平均值。分别用jax.jit和shard_map实现。对每个进行性能分析,看耗时多少。是否添加了任何通信?提示:本不该有通信,但有时 XLA 还是会添加。用 JAX 编写一个函数,对每个 X 分片内的 x 返回 roll(x, shift, axis=0) - x,其中 shift 是某个偏移量。我没有那么受虐倾向,不会让你用 jax.jit 来做,所以只用
shard_map实现就行。
点击查看答案。
第 1 部分:这是第 1 部分的解答。注意我们为 jax.jit 解法所做的相当复杂的 reshape。
import numpy as np

import jax
import jax.numpy as jnp

mesh = jax.make_mesh((4, 2), ('X','Y'))

average_shmap = jax.shard_map(
    lambda x: x.mean(keepdims=True),
    mesh=mesh,
    in_specs=jax.P('X','Y'), out_specs=jax.P('X','Y')
)

def average(x):
  X, Y = mesh.axis_sizes
  return x.reshape(X, x.shape[0] // X, Y, x.shape[1] // Y).mean(axis=(1, 3))

average_jit = jax.jit(average, out_shardings=jax.NamedSharding(mesh, jax.P('X','Y')))

x = jnp.arange(8 * 64 * 8, dtype=jnp.int32).reshape(8 * 64, 8)
x = jax.device_put(x, jax.NamedSharding(mesh, jax.P('X','Y')))

y1 = average_shmap(x)
y2 = average_jit(x)

np.testing.assert_array_equal(y1, y2)
第 2 部分:这是第 2 部分类似的解法。
import numpy as np

import jax
import jax.numpy as jnp

import functools

P = jax.sharding.PartitionSpec

mesh = jax.make_mesh((4, 2), ('X','Y'))

def shift_shmap(x, shift: int):
  shmapped = jax.shard_map(
      lambda x: jnp.roll(x, shift, axis=0),
      mesh=mesh,
      in_specs=jax.P('X','Y'), out_specs=jax.P('X','Y')
  )
  return shmapped(x)

@functools.partial(jax.jit, static_argnames=['shift'], out_shardings=jax.NamedSharding(mesh, jax.P('X','Y')))
def shift_jit(x, shift: int):
  X, Y = mesh.axis_sizes
  reshaped = x.reshape(X, x.shape[0] // X, -1)
  return jnp.roll(reshaped, shift, axis=1).reshape(x.shape[0], x.shape[1])

x = jnp.arange(8 * 64 * 8, dtype=jnp.int32).reshape(8 * 64, 8)
x = jax.device_put(x, jax.NamedSharding(mesh, jax.P('X','Y')))

y1 = shift_shmap(x, 5)
y2 = shift_jit(x, 5)

np.testing.assert_array_equal(y1, y2)
问题 2: 这里我们一起搭一个基础的"专家混合(mixture of experts,MoE)“模型。设 W: float32[EX, D, F] 是一组 E 个"专家"矩阵。设 A: float32[SX, D](我们的激活),B: int32[SX] 是一组"路由分配”,其中 B[i] 是 [0, E) 范围内的整数,告诉我们要用哪个矩阵处理这个激活。我们要在 JAX 中编写一个函数,返回 Out[i] = W[B[i]] @ A[i]。
先完全忽略分片。把所有这些张量做小,能放进一个设备里。写出这个函数的本地实现。确保不要物化形状为
[S, D, F]的数组!提示:试着把 token 排序到一个新的形状为[E, S, D]的缓冲区里,注意 mask 的处理(为什么第二维需要大小 S?)。如果你只是
jax.jit上面的方法,会发生些事情。对它做性能分析,看它决定做什么通信。耗时多少?你会注意到上面的一个问题是它可能会本地 gather 全部的激活 A,即 AllGatherX([SX, D])。这不仅在通信上昂贵,如果完整激活无法本地放下,内存上也极其昂贵。用
shard_map和显式通信实现上述功能。第一遍可以用
jax.lax.all_gather重排序,就像 (a) 中那样最简单。第二遍尝试不物化任何形状为
[E, S, D]的数组,即在jax.lax.while_loop内部使用jax.lax.all_to_all以"参差不齐(ragged)“的方式执行计算。这样你可以避免物化完整激活,避免在 padding 上浪费计算。这比你最初的实现快多少?
大多数 MoE 路由到多个(k 个)专家然后对结果求平均。重构上面的代码以实现这一点。在这种情况下设 B: int32[S, k],对应路由到 k 个专家。
点击查看(部分)答案。
1/2. 对于第 (1) 部分,你有很多选择。下面是一种使用 mask 在专家上迭代的方案:
def moe_local(W: jnp.ndarray, A: jnp.ndarray, B: jnp.ndarray) -> jnp.ndarray:
    S, _ = A.shape
    E, _, F = W.shape

    def expert_forward(carry, e):
        output = carry  # [S, F]
        mask = (B == e)[:, None]  # [S, 1]
        expert_result = A @ W[e]  # [S, F] - this expert's transform of ALL tokens
        output = output + expert_result * mask  # Only keep results for assigned tokens
        return output, None

    output = jnp.zeros((S, F))
    output, _ = lax.scan(expert_forward, output, jnp.arange(E))

    return output
你也可以使用 jax.lax.ragged_dot,它会做类似的事情,但更高效。
- 这里我只草拟一下伪代码(如果你有干净的解法欢迎补充):
chunk_size = 128
def matmul(W, x, B):
  i = 0
  x = # sort x according to assignments
  while (chunk := x[i:i+chunk_size].any()):
     chunk = all_to_all(chunk)
     out = matmul_local(W, chunk)
  return concat(out)
基本思路是按数组的块迭代,对它们排序并做 all_to_all,然后做本地 FLOPs。
问题 3: 上面的集合矩阵乘法例子对真实的 LLM 非常相关。让我们调整这个例子,做完整的 Transformer 栈。
作为练习,我们先实现一个 AllReduce 集合矩阵乘法,即 A[BX, DY] *D W[DY, F] -> Out[BX, F]。注意输出没有复制。朴素算法上面已经讨论过,基本就是本地矩阵乘法后跟一个 AllReduce。试着做一个通信重叠的"集合"版本。提示:在输出维度上做 tile,可以使用
jax.lax.psum(即 AllReduce)。 注意:由于 XLA 处理这个的方式,它实际上可能并不比基线更快。上述 AllReduce 集合矩阵乘法的对偶是 ReduceScatter 集合矩阵乘法,即 Tmp[BX, FY] *F W2[FY, D] -> Out[BX, DY]。这出现在 Transformer 的下投影矩阵中。在 JAX 中实现一个集合的、重叠的版本。注意只传递你需要的最少数据。提示:在累加结果时尝试对其进行置换。
把上面这两个组合起来,搭一个端到端的 Transformer block,执行 In[BX, DY] *D Win[D, FY] *F Wout[FY, D] -> Out[BX, DY],并实现通信重叠。这比
jax.jit实现快多少?
问题 4: 上面实现的所有集合矩阵乘法都是单向的:它们只在一个方向上置换。重写集合 AllReduce 矩阵乘法和集合 ReduceScatter 矩阵乘法以使用双向通信。这些版本快多少?
第 10 部分到此结束。基本就是这样了!最终结论和延伸阅读,请点击这里。
杂项#
*工作在 Google DeepMind 完成,现就职于 MatX。
引用(Citation)#
学术引用请使用以下格式:
Austin et al., "How to Scale Your Model", Google DeepMind, online, 2025.或者 BibTeX 条目:
@article{scaling-book,
  title = {How to Scale Your Model},
  author = {Austin, Jacob and Douglas, Sholto and Frostig, Roy and Levskaya, Anselm and Chen, Charlie and Vikram, Sharad
  and Lebron, Federico and Choy, Peter and Ramasesh, Vinay and Webson, Albert and Pope, Reiner},
  publisher = {Google DeepMind},
  howpublished = {Online},
  note = {Retrieved from https://jax-ml.github.io/scaling-book/},
  year = {2025}
}