How to Scale Your Model(如何扩展你的模型)#
A Systems View of LLMs on TPUs(从系统视角看 TPU 上的 LLM)(Part 0: Intro | Part 1: Rooflines)
训练 LLM(大语言模型)常常让人感觉像在搞炼金术,但理解和优化模型的性能并不必如此。本书旨在揭开扩展语言模型这门科学的神秘面纱:TPU(和 GPU)是如何工作的、它们之间如何通信、LLM 在真实硬件上是如何运行的,以及如何在训练和推理过程中并行化你的模型,使其能够在大规模下高效运行。如果你曾经想过"训练这个 LLM 应该花多少钱"或"我自己部署这个模型需要多少内存"或"什么是 AllGather",那么我们希望本书对你有所帮助。
Contents(目录)
深度学习的很多内容仍然类似某种黑魔法,但优化模型的性能并不必如此——即使在巨大规模下也是如此!相对简单的原则在任何地方都适用——从处理单个加速器到上万个加速器——理解这些原则能让你做很多有用的事情:
- 大致估算模型各部分距离其理论最优值有多近。
- 在不同规模下针对不同的并行化方案做出明智的选择(即如何将计算切分到多个设备上)。
- 估算训练和运行大型 Transformer 模型所需的成本与时间。
- 设计能够利用特定硬件特性的算法。
- 基于对当前算法性能瓶颈的明确理解来设计硬件。
预期背景: 我们假设你对 LLM 和 Transformer 架构有基本的理解,但不一定理解它们在大规模下如何运作。你应该了解 LLM 训练的基础知识,最好对 JAX 也有一些基本的了解。一些有用的背景阅读包括这篇关于 Transformer 架构的博客文章以及原始的 Transformer 论文。也可以查看这个列表以获取更多有用的并行和后续阅读资料。
目标与反馈: 读完本书后,你应当能够熟练地估算给定硬件平台上 Transformer 模型的最佳并行化方案,以及训练和推理大致需要多长时间。如果做不到,请给我们发邮件或留言!我们很想知道如何能讲得更清楚。
你也许还会喜欢阅读关于 NVIDIA GPU 的新章节 Section 12!
Why should you care?(为什么你应该关心这个?)#
三四年前,我想大多数 ML 研究者并不需要理解本书中的任何内容。但今天即便是"小"模型也运行得非常接近硬件极限,做新颖的研究需要你思考大规模下的效率问题。从历史上看,ML 研究遵循着一种系统创新与软件改进交替进行的"tick-tock"循环。Alex Krizhevsky 不得不写恐怖的 CUDA 代码才能让 CNN 跑得快,但几年之内,像 Theano 和 TensorFlow 这样的库就让你不必这么做了。也许这种事在这里也会发生,本书中的所有内容几年后都会被抽象掉。但 scaling laws(扩展定律)已经将我们的模型持续推向硬件的最前沿,看起来在可预见的未来,做尖端研究将不可避免地与如何把模型高效扩展到大型硬件拓扑上紧密相连。如果一个 20% 的基准提升要以 20% 的 roofline 效率为代价,那它就是无关紧要的。 那些有前景的模型架构经常失败,要么是因为它们无法在大规模下高效运行,要么是因为没人愿意投入工作让它们做到这一点。
“模型扩展"的目标是:能够增加用于训练或推理的芯片数量,同时获得吞吐量的成比例线性增长。 这被称为”strong scaling(强扩展)"。虽然增加额外的芯片(“parallelism(并行)")通常会减少计算时间,但它也以芯片间通信增加为代价。当通信耗时超过计算耗时,我们就变成"communication bound(通信受限)",无法实现强扩展。当你的计算时间减少时,你通常也会在单芯片层面遇到瓶颈。你那闪亮的新 TPU 或 GPU 也许标称每秒能执行 500 万亿次运算,但如果不小心,由于参数在内存中搬来搬去而被拖慢,它的性能可能只有标称值的十分之一。每芯片的计算、内存带宽和总内存的相互作用对扩展故事至关重要。如果我们对硬件理解得足够好,能够预判这些瓶颈会出现在哪里,那么就能设计或重新配置我们的模型来规避它们。硬件设计者面对的是相反的问题:构建恰到好处地为我们的算法提供足够计算、带宽和内存的硬件,同时尽量减少成本。你可以想象这种"co-design(协同设计)“问题有多让人焦虑:你必须押注首批芯片实际上市时(往往是 2 到 3 年后)算法会是什么样子。TPU 的故事是这场博弈中的巨大成功。矩阵乘法是一个独特的算法,它每字节内存使用的 FLOP 数远超其他几乎所有算法(每字节 N 次 FLOP),早期的 TPU 及其 systolic array(脉动阵列)架构在它们被构建的时代实现了远远好于 GPU 的性价比。TPU 是为 ML 工作负载而设计的,而 GPU 凭借其 Tensor Cores 也在迅速变化以填补这个生态位。但你可以想象,如果神经网络没能起飞,或者以某种 TPU(其灵活性本质上不如 GPU)无法处理的根本性方式发生变化,代价会有多大。
本书的目标是解释 TPU(和 GPU)硬件如何工作,以及 Transformer 架构是如何演进以在当前硬件上表现良好的。我们希望这对设计新架构的研究者和努力让当前一代 LLM 跑得更快的工程师都有用。
High-Level Outline(高层概览)#
本书的整体结构如下:
Section 1 解释 roofline analysis(roofline 分析)以及哪些因素会限制我们的扩展能力(通信、计算和内存)。Section 2 和 Section 3 详细讨论 TPU 是如何工作的,既作为单独的芯片,又——这一点至关重要——作为一个由带宽和延迟有限的 inter-chip links(芯片间链路)互连而成的系统。我们会回答以下问题:
- 一个特定大小的矩阵乘法应该花多长时间?在什么情况下它会受限于计算、内存或通信带宽?
- TPU 是如何连接成训练集群的?系统的每个部分有多少带宽?
- 在多个 TPU 之间收集(gather)、分散(scatter)或重新分发(re-distribute)数组需要多长时间?
- 我们如何高效地相乘那些以不同方式分布在各设备上的矩阵?
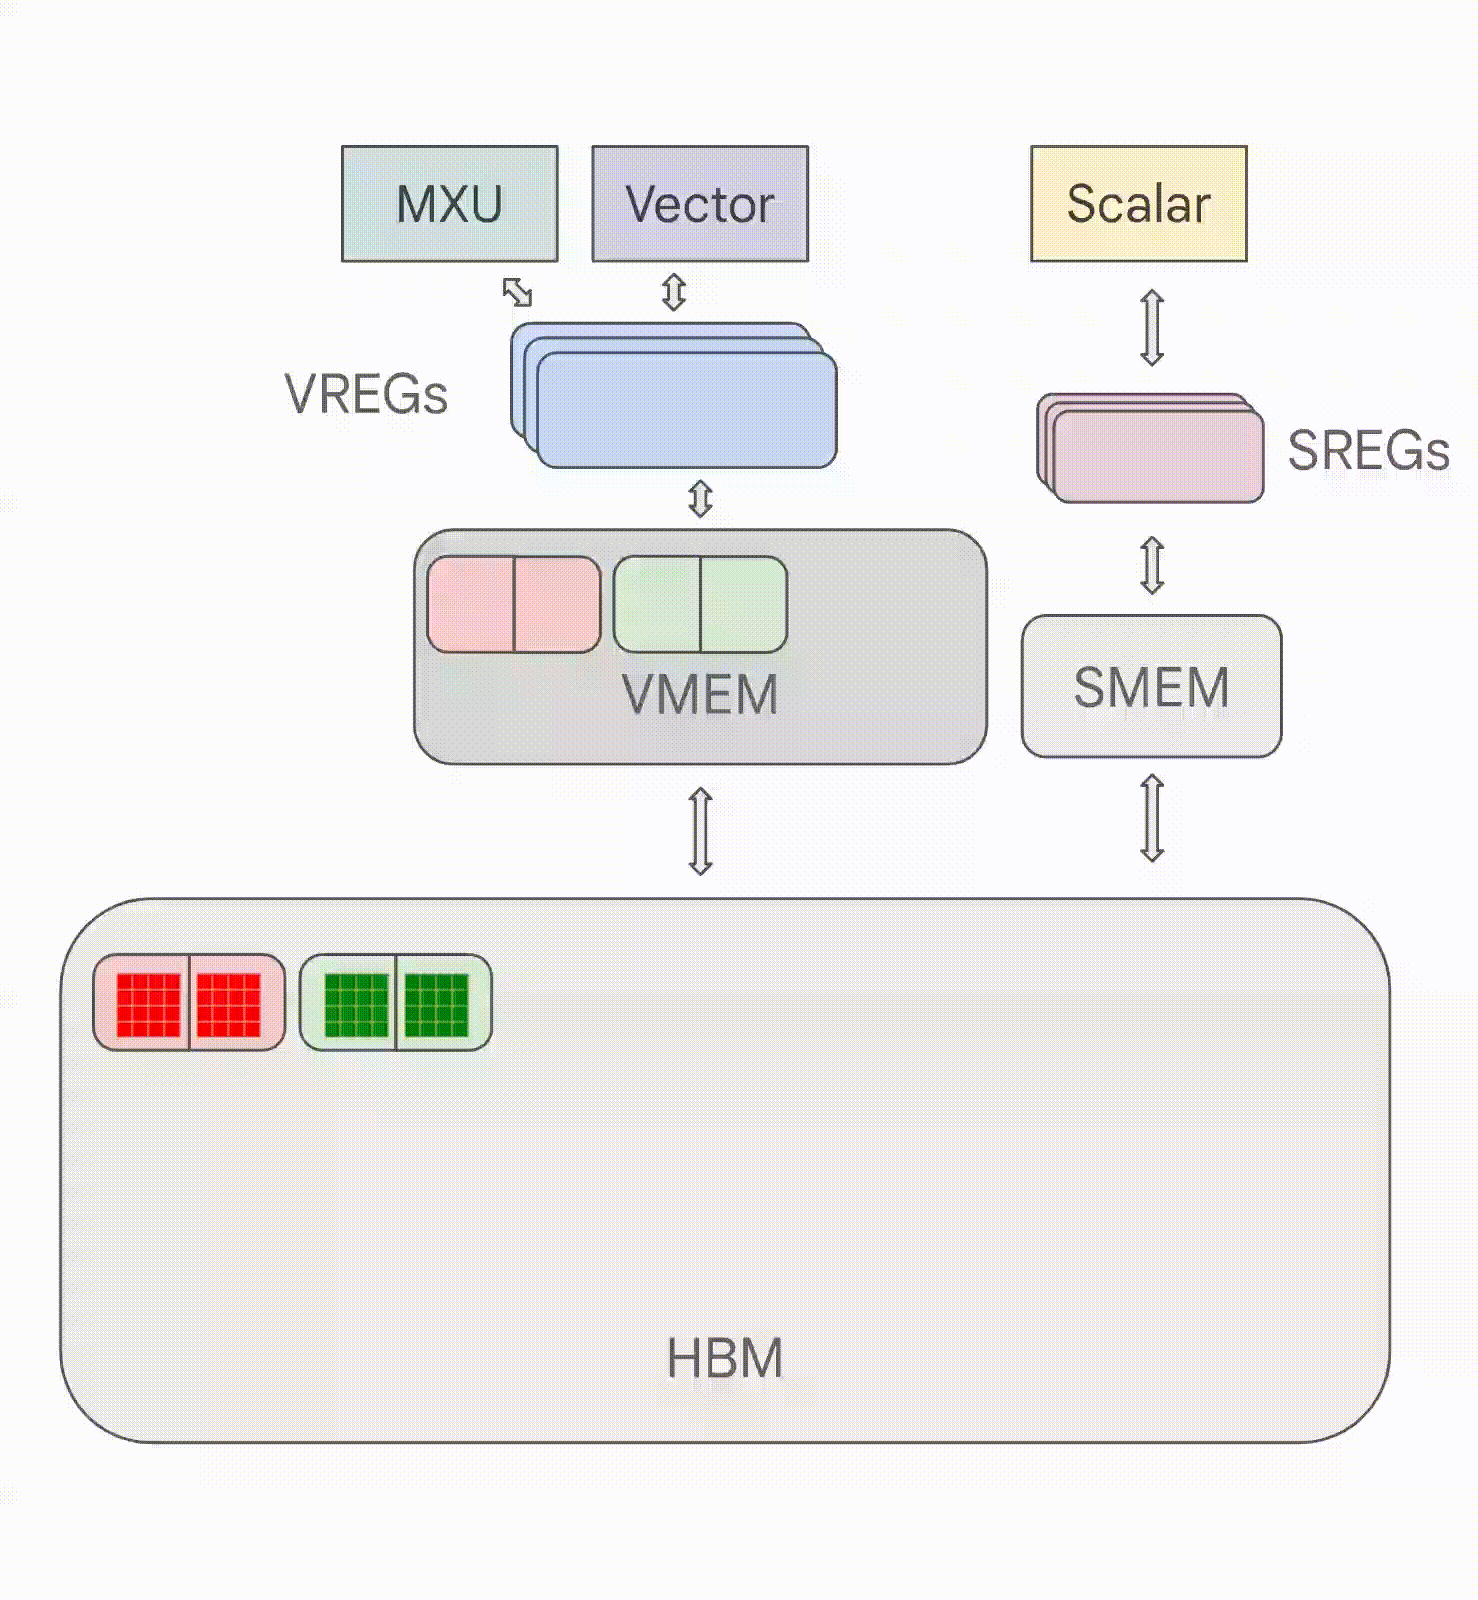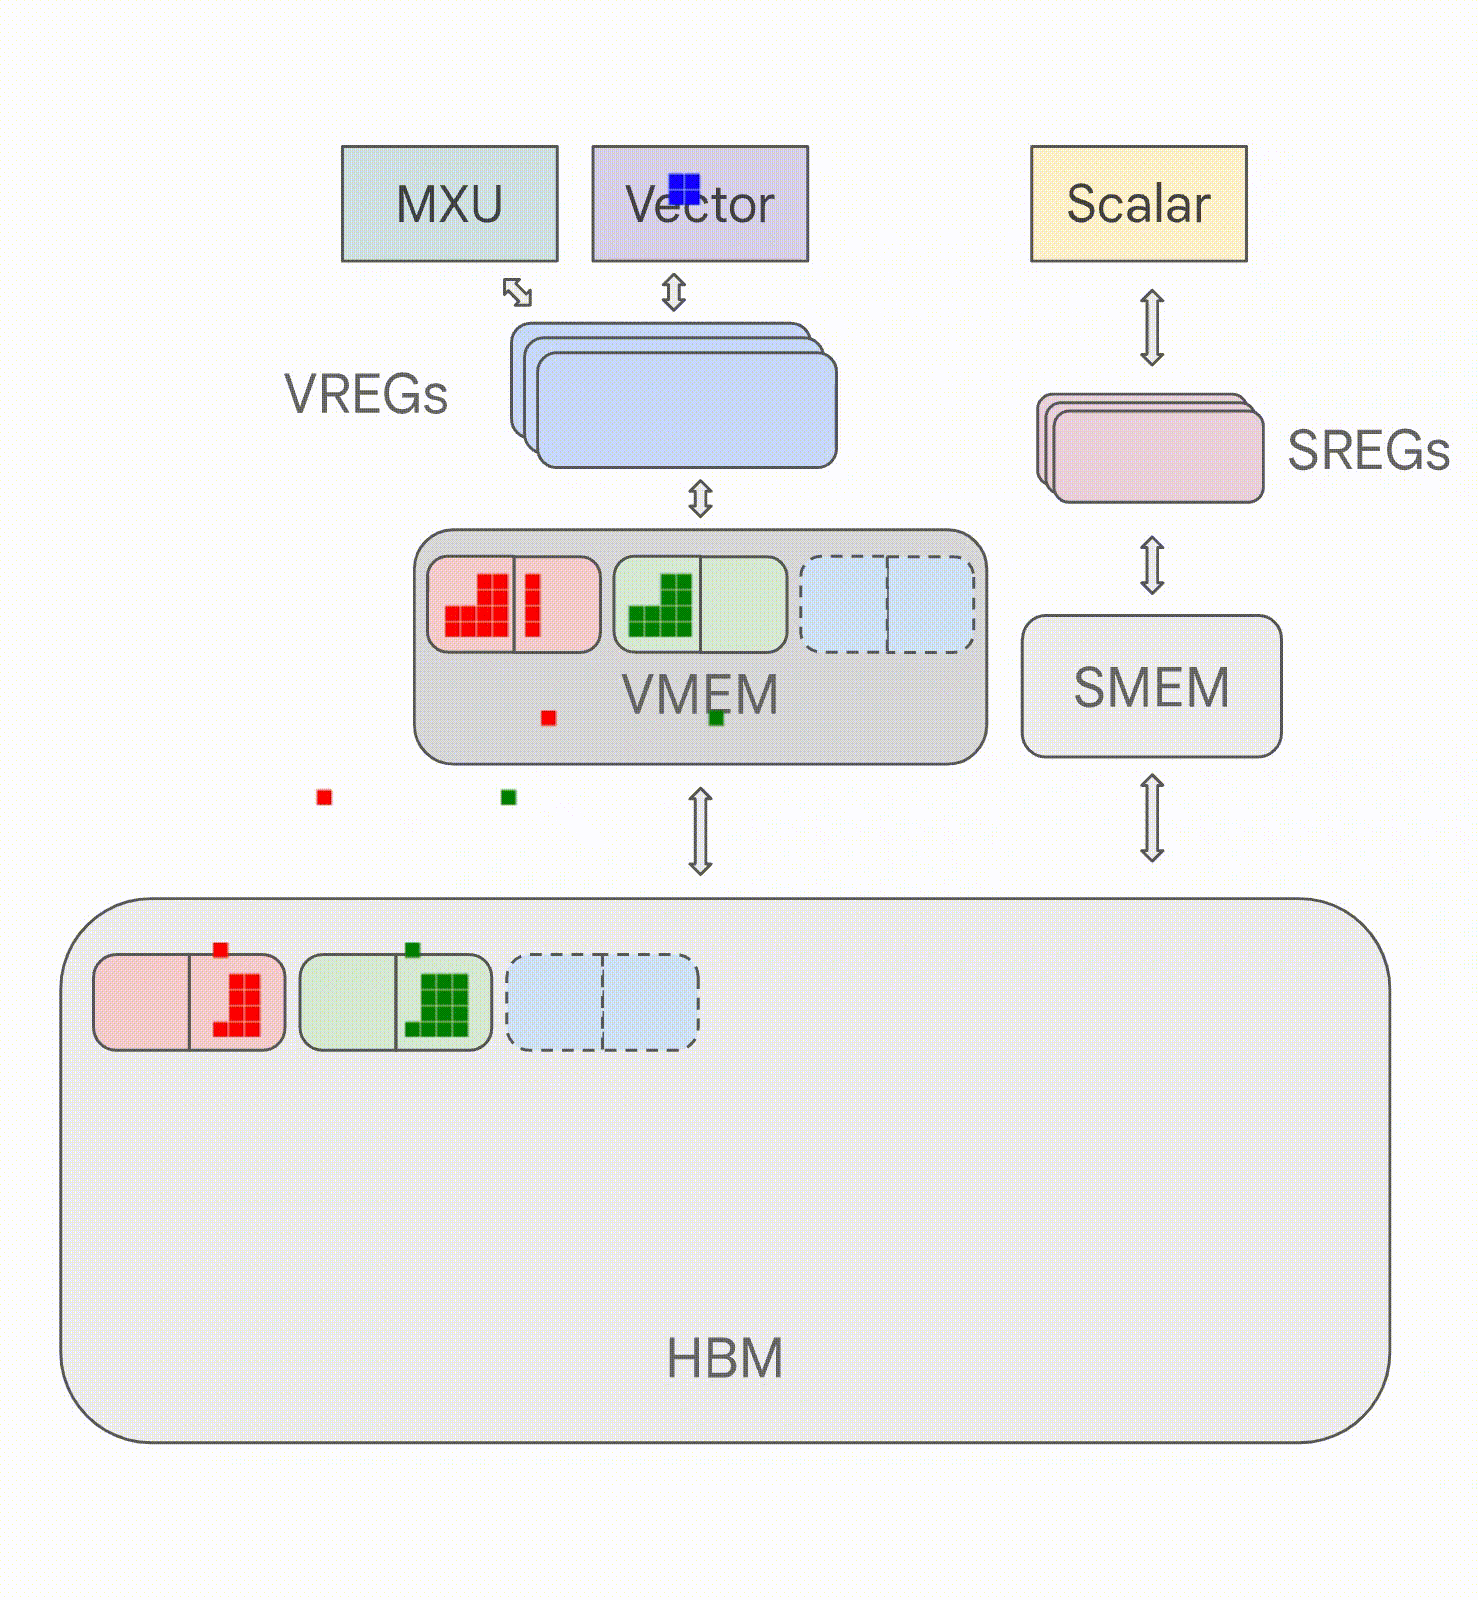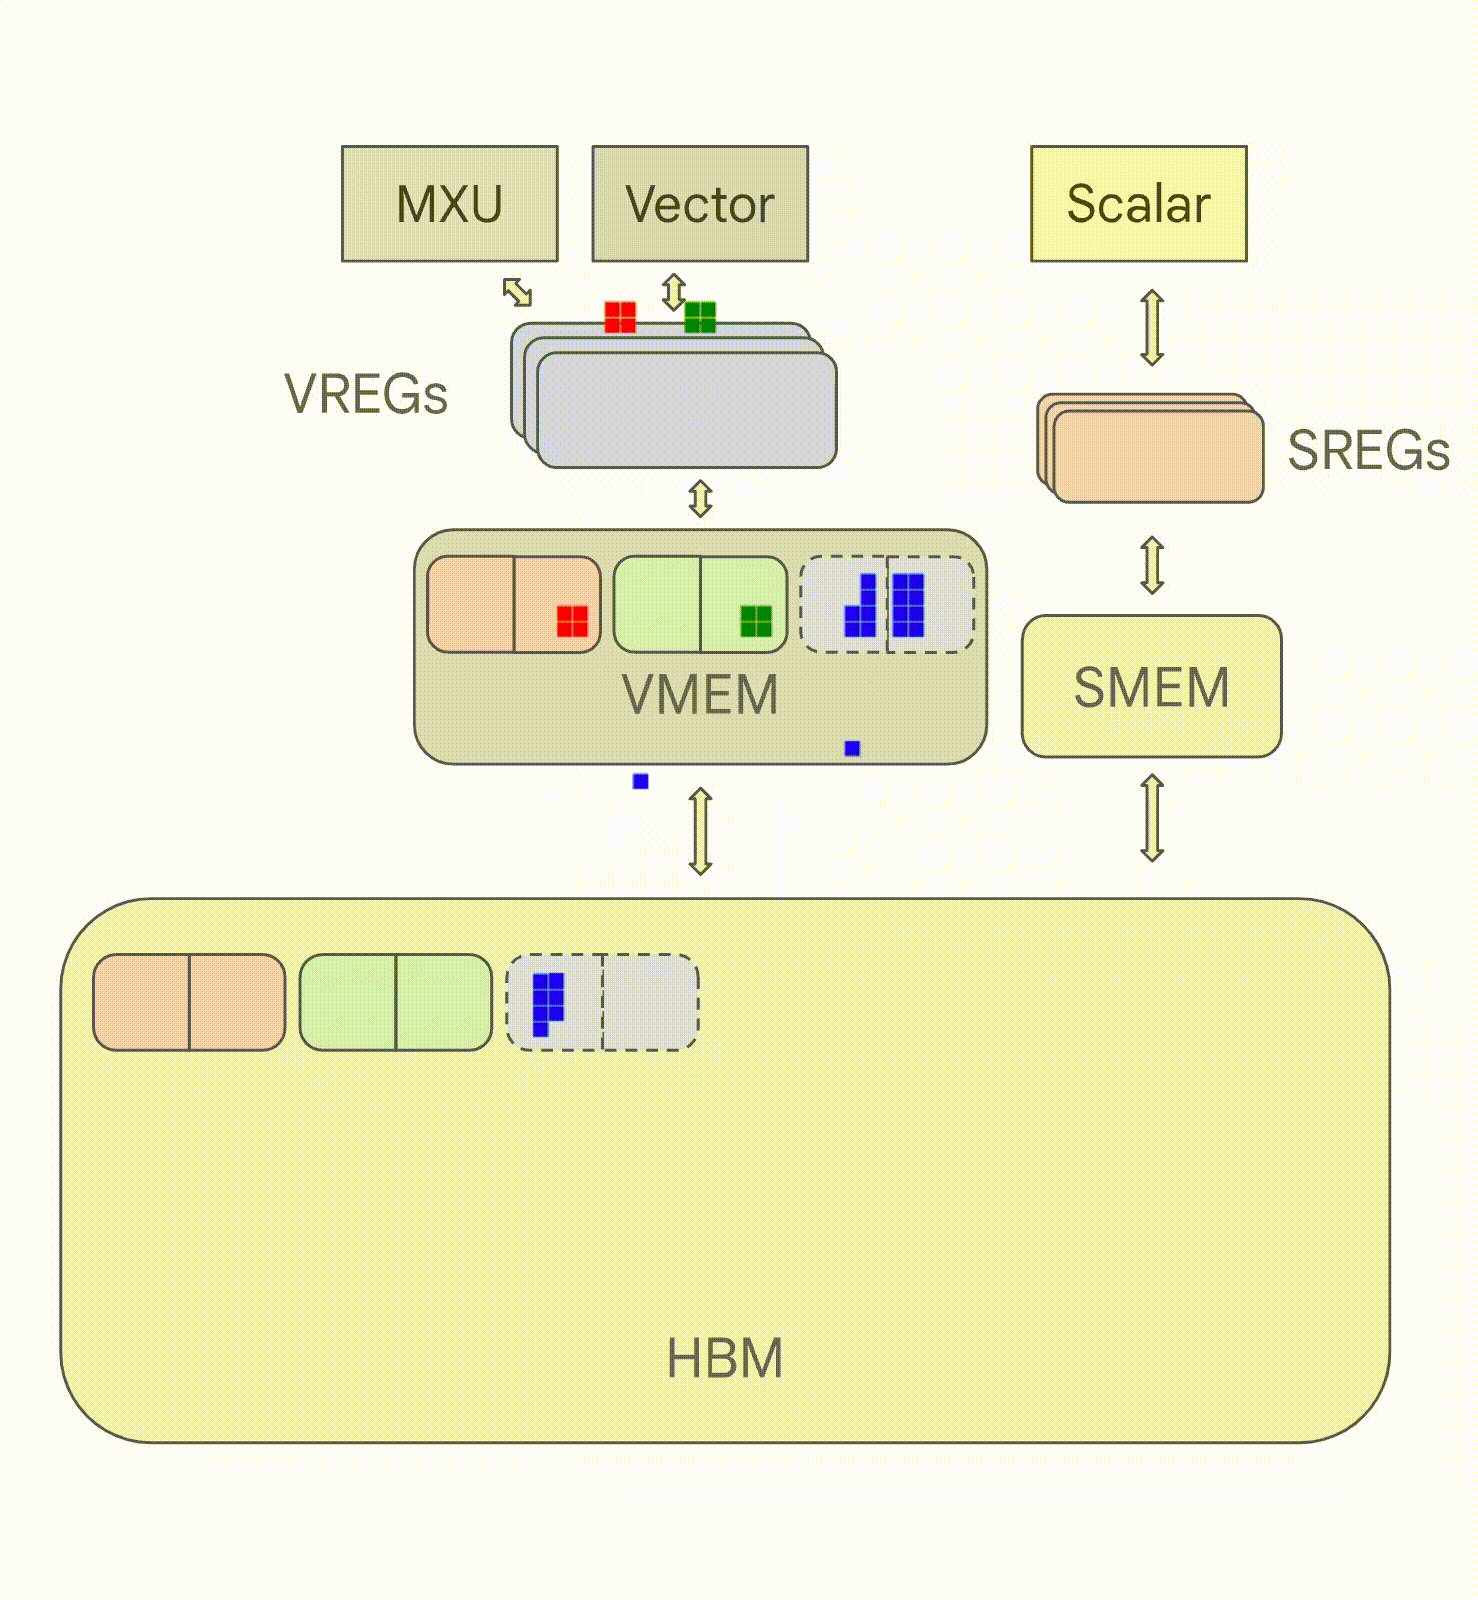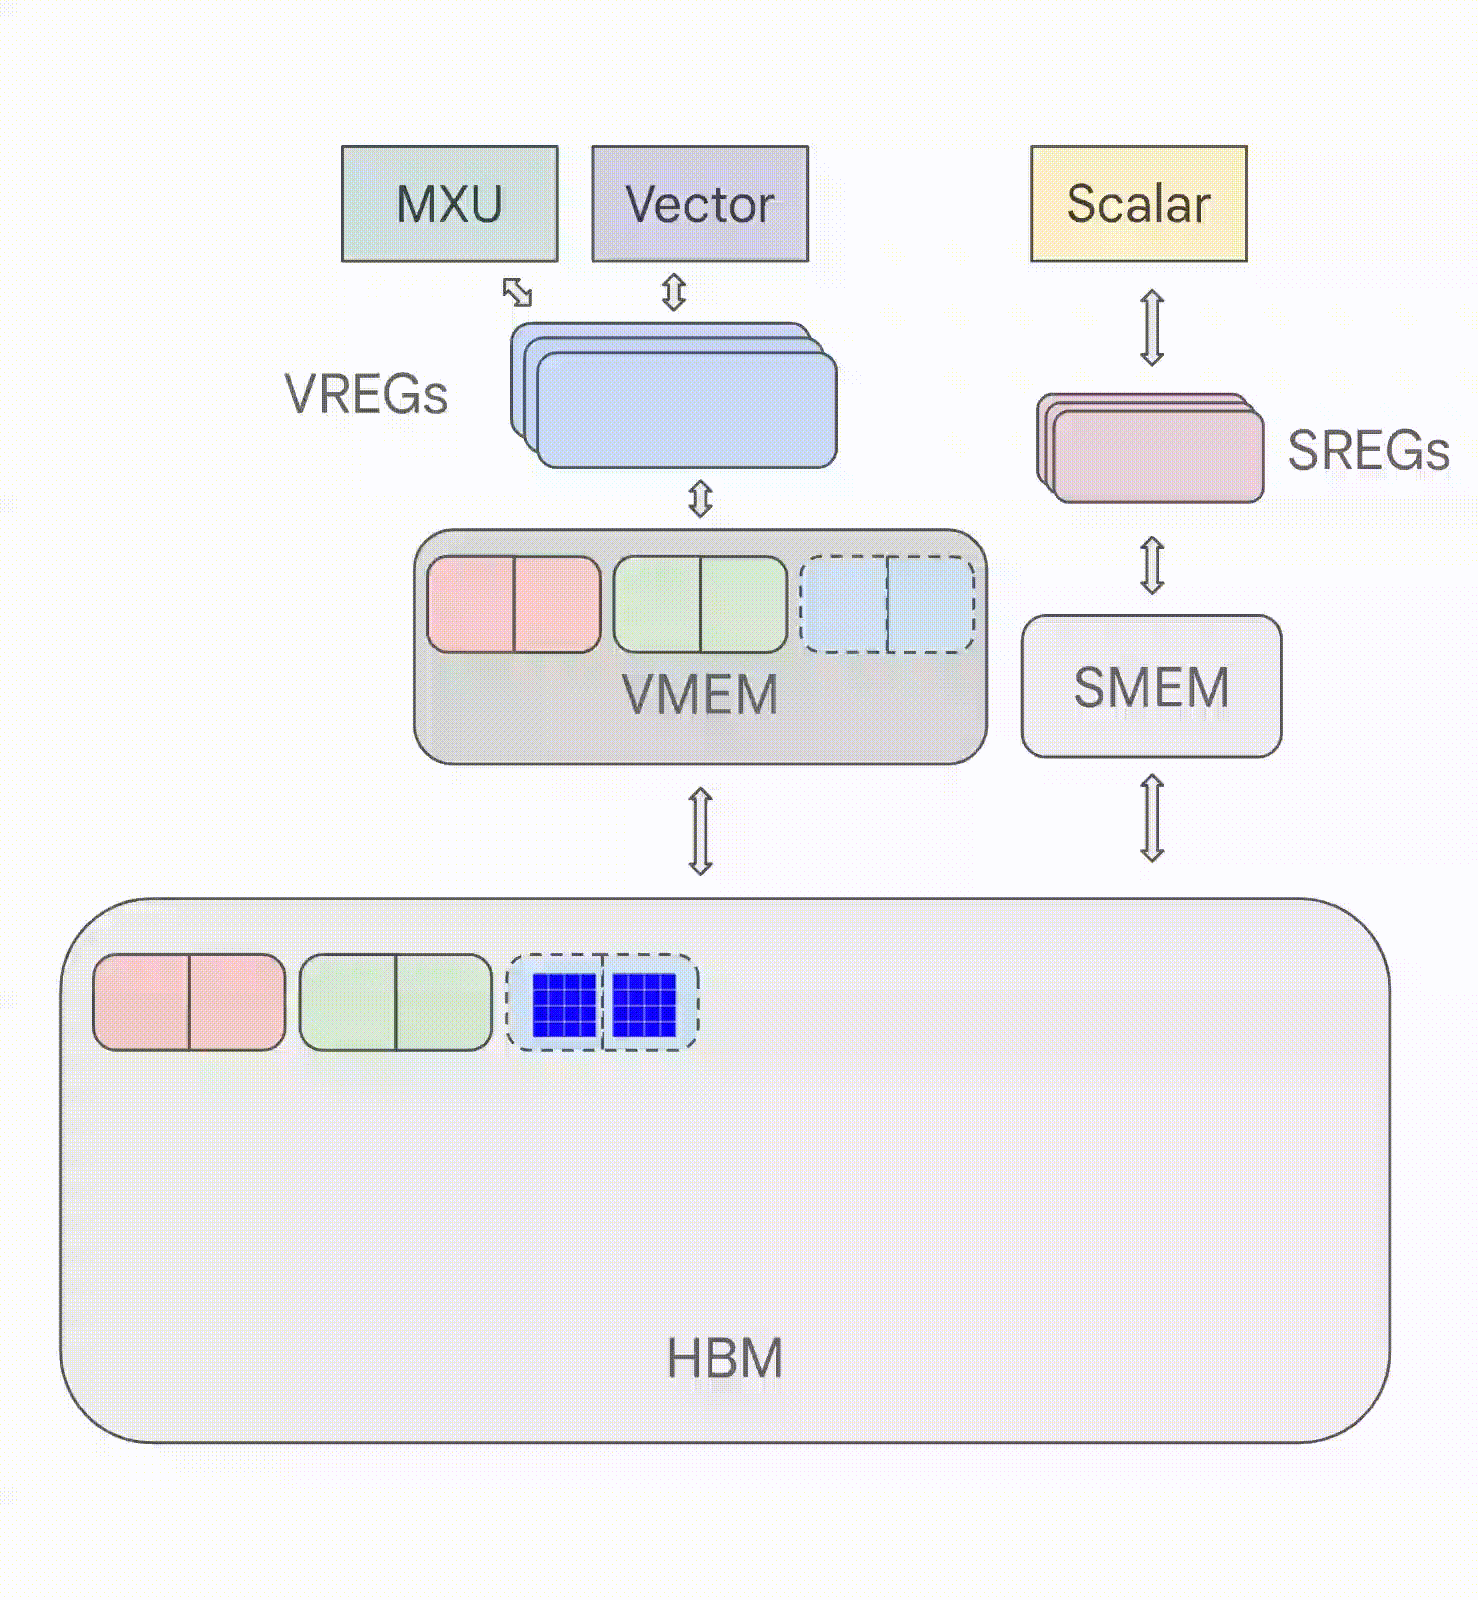
图: 来自 Section 2 的一张图,展示 TPU 如何执行 elementwise product(逐元素乘积)。根据数组大小和各种链路的带宽,我们可能会发现自己是 compute-bound(计算受限,使用了硬件的全部计算能力)或 memory-bound(内存受限,被内存加载所瓶颈)。
五年前,ML 还有一个色彩斑斓的架构图景——ConvNets、LSTMs、MLPs、Transformers——但现在我们基本上只剩下 Transformer 了。我们坚信值得理解 Transformer 架构的每一个部分:每个矩阵的精确大小、normalization(归一化)发生在哪里、每部分有多少参数和 FLOPs(FLoating point OPs,本质上就是所需的加法和乘法的总数。虽然许多资料把 FLOPs 当作"每秒运算数”,但我们用 FLOPs/s 来明确表示这一点)。Section 4 仔细讲解这套"Transformer math(Transformer 数学)",展示如何在训练和推理中分别统计参数量和 FLOPs。这告诉我们模型会用多少内存、我们会在计算或通信上花多少时间,以及 attention(注意力)相对于 feed-forward blocks(前馈块)什么时候会变得重要。
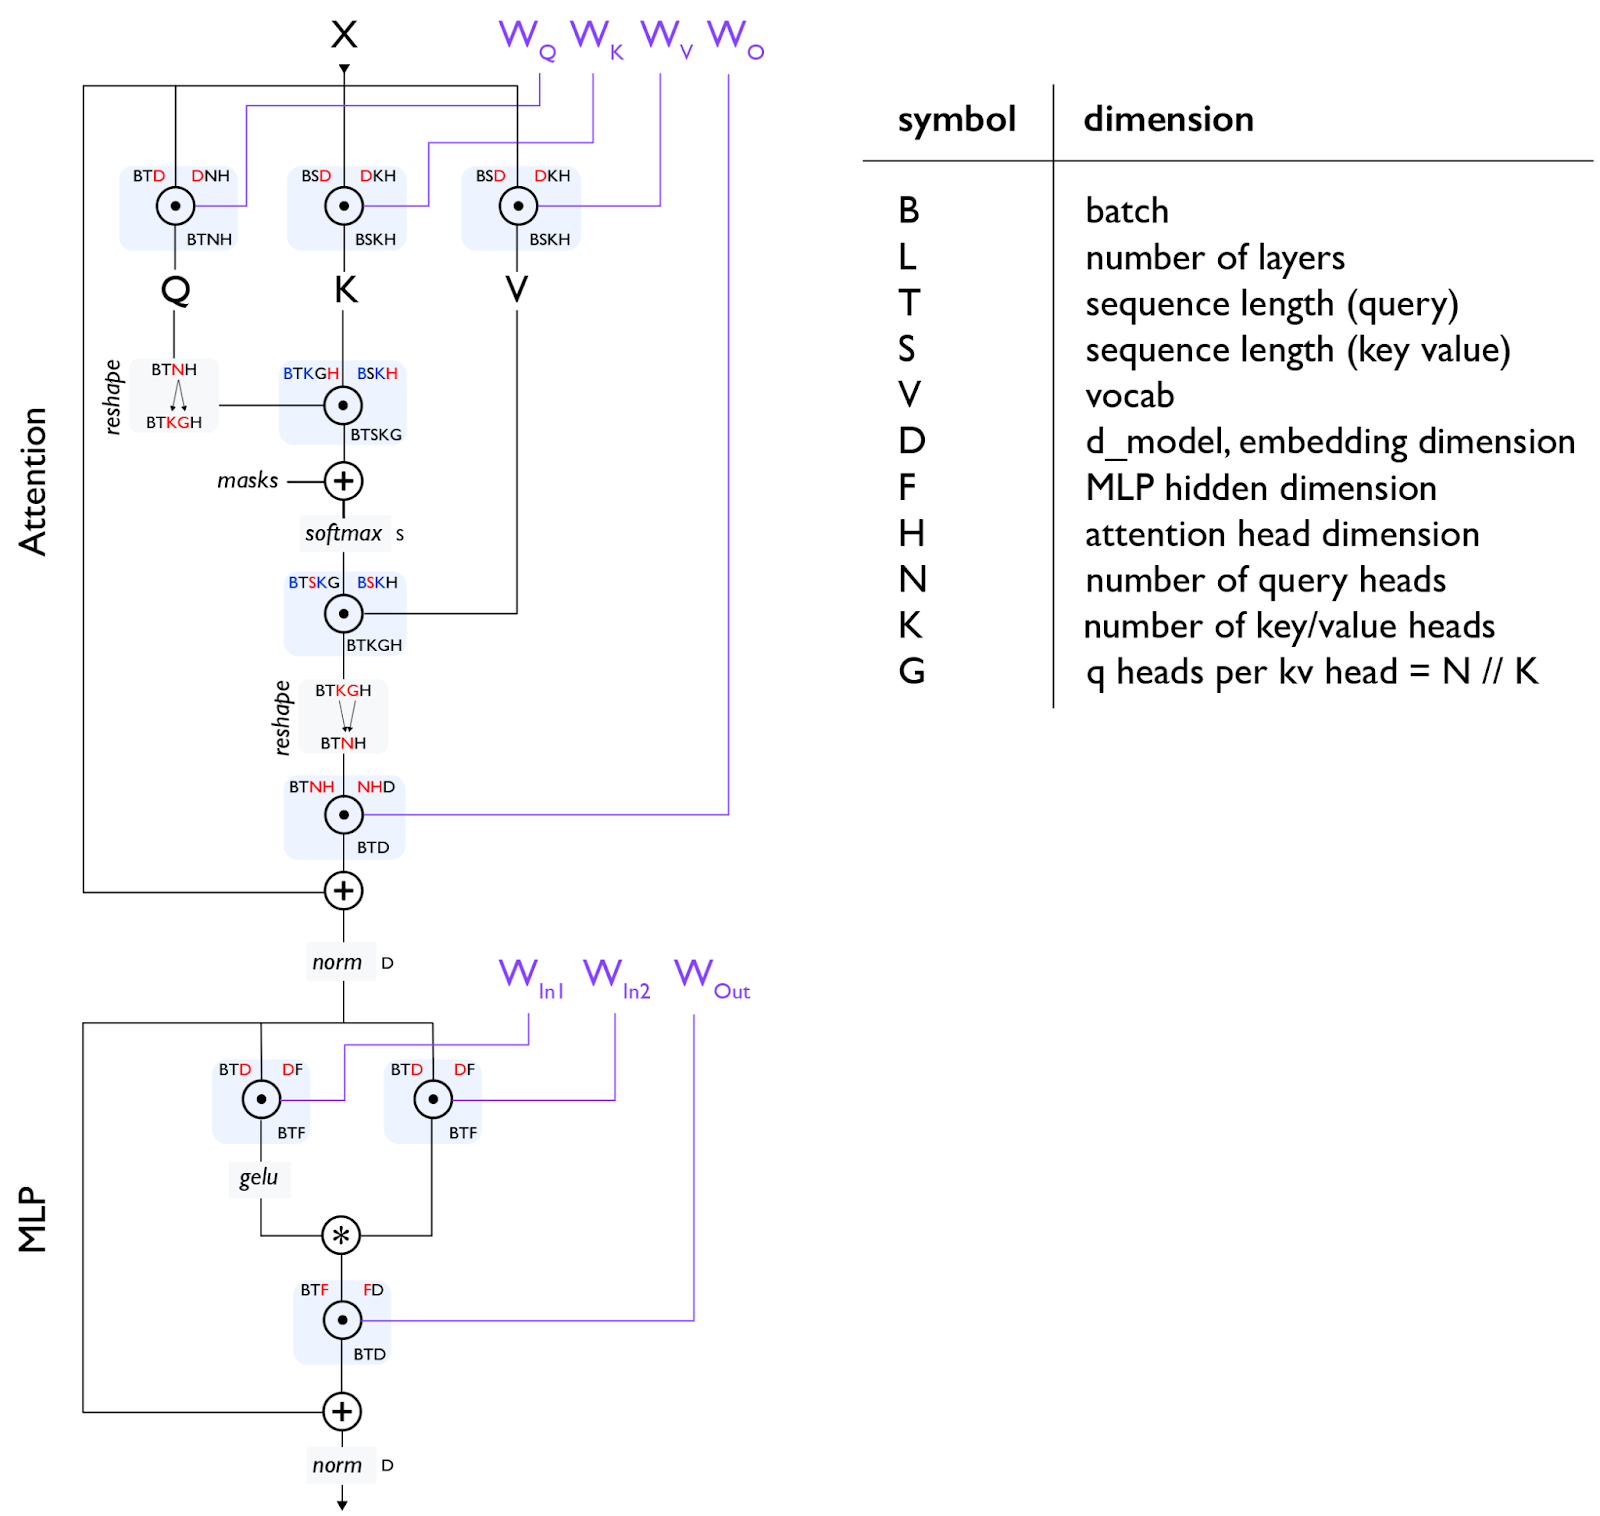
图: 一个标准的 Transformer 层,每个矩阵乘法(matmul)都用一个圆圈中的点表示。所有参数(除归一化外)都用紫色表示。Section 4 会更详细地讲解这张图。
Section 5: Training 和 Section 7: Inference 是本书的核心,我们在其中讨论根本性的问题:给定某个大小的模型和某个数量的芯片,我该如何并行化我的模型,以保持在"strong scaling(强扩展)“区域内?这是一个简单的问题,但答案出乎意料地复杂。从高层来看,有 4 种主要的并行化技术用于将模型切分到多个芯片上(data、tensor、pipeline 和 expert),还有一些其他技术用于减少内存需求(rematerialisation、optimizer/model sharding(亦即 ZeRO)、host offload、gradient accumulation)。我们在这里讨论了其中许多技术。
我们希望读完这些章节后,你能够为新架构或新场景自行选择合适的方案。Section 6 和 Section 8 是实践教程,将这些概念应用到流行的开源模型 LLaMA 3 上。
最后,Section 9 和 Section 10 探讨如何在 JAX 中实现这些想法,以及当出错时如何剖析(profile)和调试代码。Section 12 是一个新章节,深入探讨 GPU。
我们尝试在书中给你提供一些可以自行解答的问题。请不要有压力非要读完所有章节或按顺序阅读。也请留下反馈。目前这是一个草稿,并将持续修订。谢谢!
我们要感谢 James Bradbury 和 Blake Hechtman,本书中的许多想法都源自他们。
闲话少说,这里是 Section 1,关于 TPU rooflines。
Links to Sections(各章节链接)#
这个系列可能比它需要的要长,但我们希望这不会让你望而却步。前三章是预备知识,如果你已经熟悉这些材料可以跳过,不过它们引入了后面会用到的记号。最后三部分可能在实际中最有用,因为它们解释了如何处理真实的模型。
Part 1: Preliminaries(第一部分:预备知识)
Chapter 1: A Brief Intro to Roofline Analysis(Roofline 分析简介)。算法受三件事所限:计算、通信和内存。我们可以用它们来近似估算算法运行的速度。
Chapter 2: How to Think About TPUs(如何理解 TPU)。TPU 是如何工作的?这如何影响我们能训练和服务的模型?
Chapter 3: Sharded Matrices and How to Multiply Them(分片矩阵以及如何相乘它们)。这里我们通过我们最喜爱的运算——(分片的)矩阵乘法——来解释 model sharding(模型分片)和 multi-TPU parallelism(多 TPU 并行)。
Part 2: Transformers(第二部分:Transformer)
Chapter 4: All the Transformer Math You Need to Know(你需要知道的所有 Transformer 数学)。Transformer 在前向和反向传播中使用多少 FLOPs?你能算出参数的数量吗?KV caches 的大小呢?我们在这里把这些数学讲清楚。
Chapter 5: How to Parallelize a Transformer for Training(如何为训练并行化 Transformer)。FSDP。Megatron sharding。Pipeline parallelism。给定若干芯片,我该如何以尽可能高效的方式用给定的 batch size 训练给定大小的模型?
Chapter 6: Training LLaMA 3 on TPUs(在 TPU 上训练 LLaMA 3)。我们将如何在 TPU 上训练 LLaMA 3?需要多长时间?要花多少钱?
Chapter 7: All About Transformer Inference(关于 Transformer 推理的一切)。一旦我们训练好了模型,就必须服务它。推理引入了一个新的考量——延迟——并改变了内存的格局。我们将讨论 disaggregated serving(解耦式服务)如何工作,以及如何思考 KV caches。
Chapter 8: Serving LLaMA 3 on TPUs(在 TPU 上服务 LLaMA 3)。在 TPU v5e 上服务 LLaMA 3 要花多少钱?延迟与吞吐量之间的权衡是怎样的?
Part 3: Practical Tutorials(第三部分:实践教程)
Chapter 9: How to Profile TPU Code(如何剖析 TPU 代码)。真实的 LLM 从来不会像上面的理论那么简单。这里我们解释 JAX + XLA 技术栈,以及如何使用 JAX/TensorBoard profiler 来调试和修复真实问题。
Chapter 10: Programming TPUs in JAX(用 JAX 编程 TPU)。JAX 提供了一系列神奇的 API 用于并行化计算,但你需要知道如何使用它们。有趣的例子和已解决的问题。
Part 4: Conclusions and Bonus Content(第四部分:结论和额外内容)
Chapter 11: Conclusions and Further Reading(结论与进一步阅读)。关于 TPU 和 LLM 的总结性思考与进一步阅读。
Chapter 12: How to Think About GPUs(如何理解 GPU)。关于 GPU 的额外章节:它们如何工作、如何联网、它们的 rooflines 与 TPU 有何不同。
Miscellaneous(其他事项)
*在 Google DeepMind 完成的工作,作者现就职于 MatX。
Citation(引用)
在学术场景下引用,请将本作品引用为:
Austin et al., "How to Scale Your Model", Google DeepMind, online, 2025.或作为 BibTeX 条目:
@article{scaling-book,
  title = {How to Scale Your Model},
  author = {Austin, Jacob and Douglas, Sholto and Frostig, Roy and Levskaya, Anselm and Chen, Charlie and Vikram, Sharad
  and Lebron, Federico and Choy, Peter and Ramasesh, Vinay and Webson, Albert and Pope, Reiner},
  publisher = {Google DeepMind},
  howpublished = {Online},
  note = {Retrieved from https://jax-ml.github.io/scaling-book/},
  year = {2025}
}