背景#
最近 Dwarkesh Podcast 连续放出了两期 Reiner Pope 的黑板课:
- The math behind how LLMs are trained and served,2026-04-29,约 2 小时 13 分钟,对应 YouTube
- Chip design from the bottom up,2026-05-22,约 1 小时 20 分钟,对应 YouTube
Reiner Pope 现在是 MatX CEO,之前在 Google 做过 software efficiency、compiler 和 TPU architecture 相关工作,也参与过 PaLM 级别的大模型效率优化。他这两期的价值不在于爆料,而在于把很多 AI 系统现象压回到几个很硬的约束:FLOPs、HBM 带宽、内存容量、数据移动、互联拓扑、batch 调度。
如果只用一句话概括这两期:
第一期讲的是 token 为什么这么贵;第二期讲的是 芯片为什么长成现在这样。
这两件事其实是一件事。token 的价格不是 API 产品经理拍脑袋定的,芯片的形状也不是硬件工程师凭审美设计的。它们都来自同一个事实:在现代 AI 系统里,真正昂贵的往往不是乘法本身,而是让正确的数据在正确时间出现在正确位置。
第一条主线:token 成本#
第一期从一个非常朴素的问题开始:为什么有些产品的 fast mode 贵很多,但速度只快几倍?能不能付 100 倍的钱换 100 倍速度?反过来,能不能等久一点,让 token 变得极便宜?
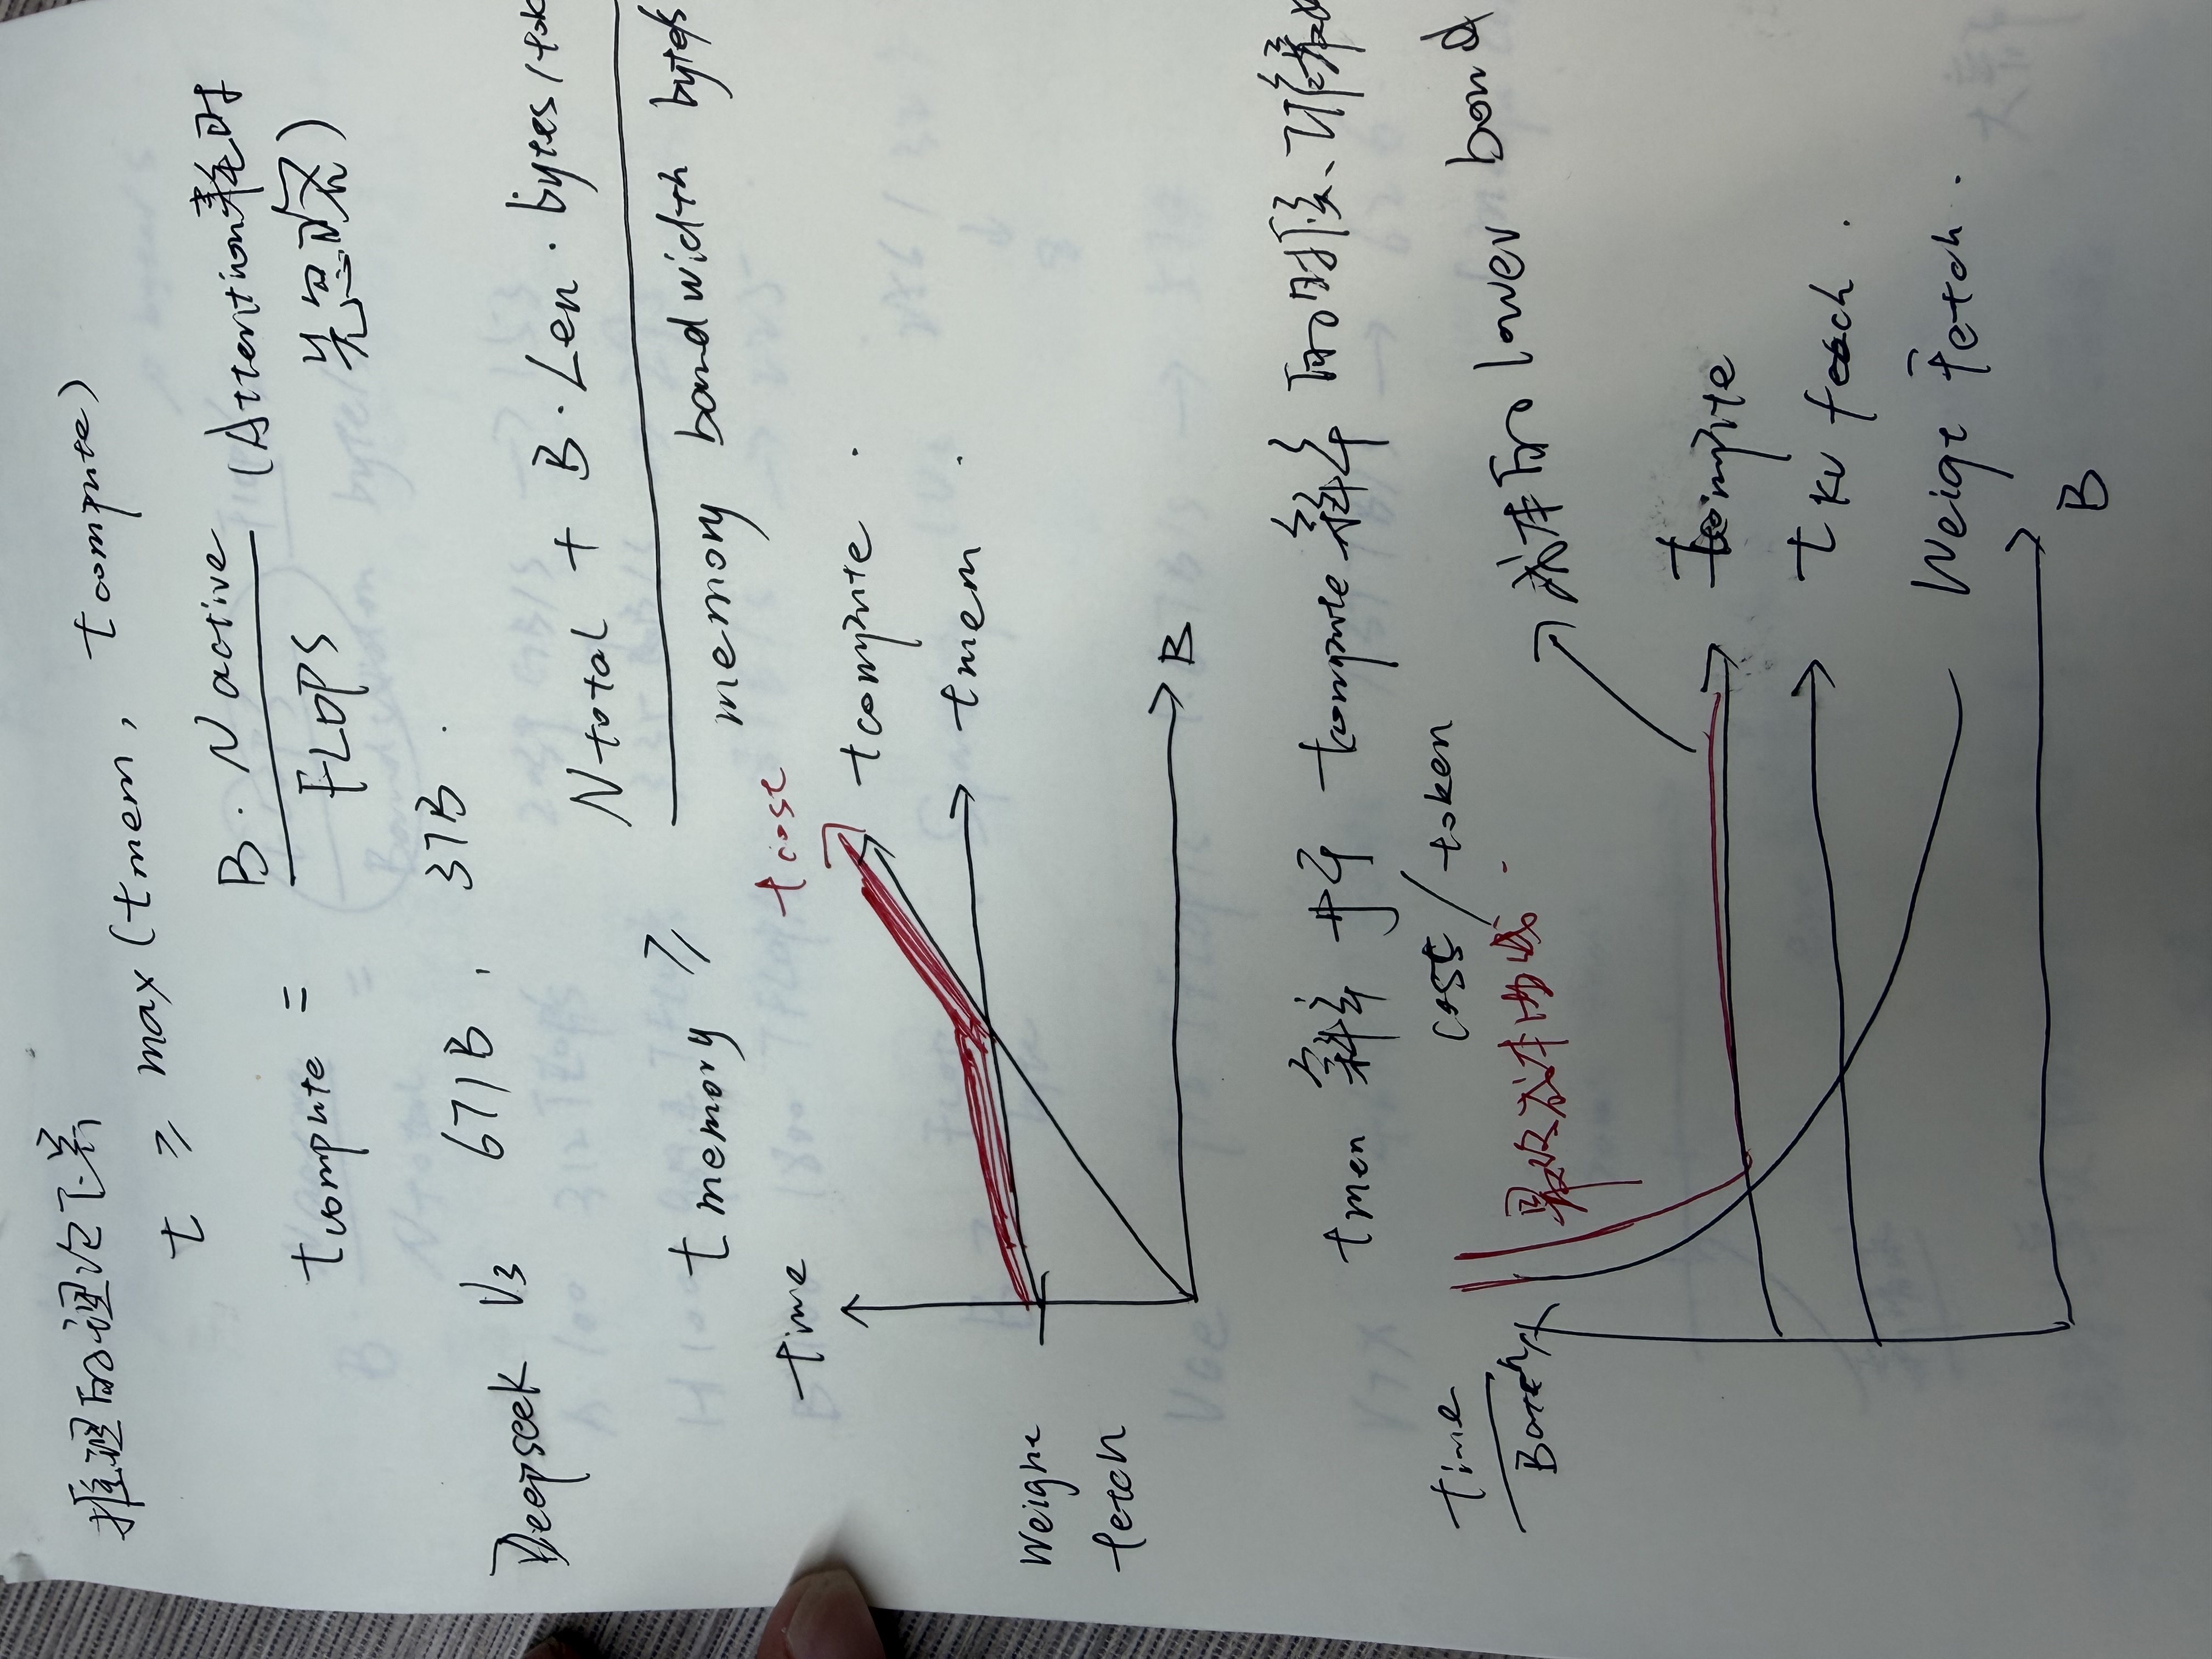
Reiner 的切入点是 Roofline。推理 decode 一个 token 时,系统至少要付出两类时间:
\[ t_{\mathrm{inference}} \ge \max\left(t_{\mathrm{compute}}, t_{\mathrm{memory}}\right) \]其中 compute time 主要来自 active parameters 上的矩阵乘法:
\[ t_{\mathrm{compute}} \approx \frac{\mathrm{batch\_size} \times \mathrm{active\_params}}{\mathrm{FLOPs}} \]memory time 则由两部分组成:
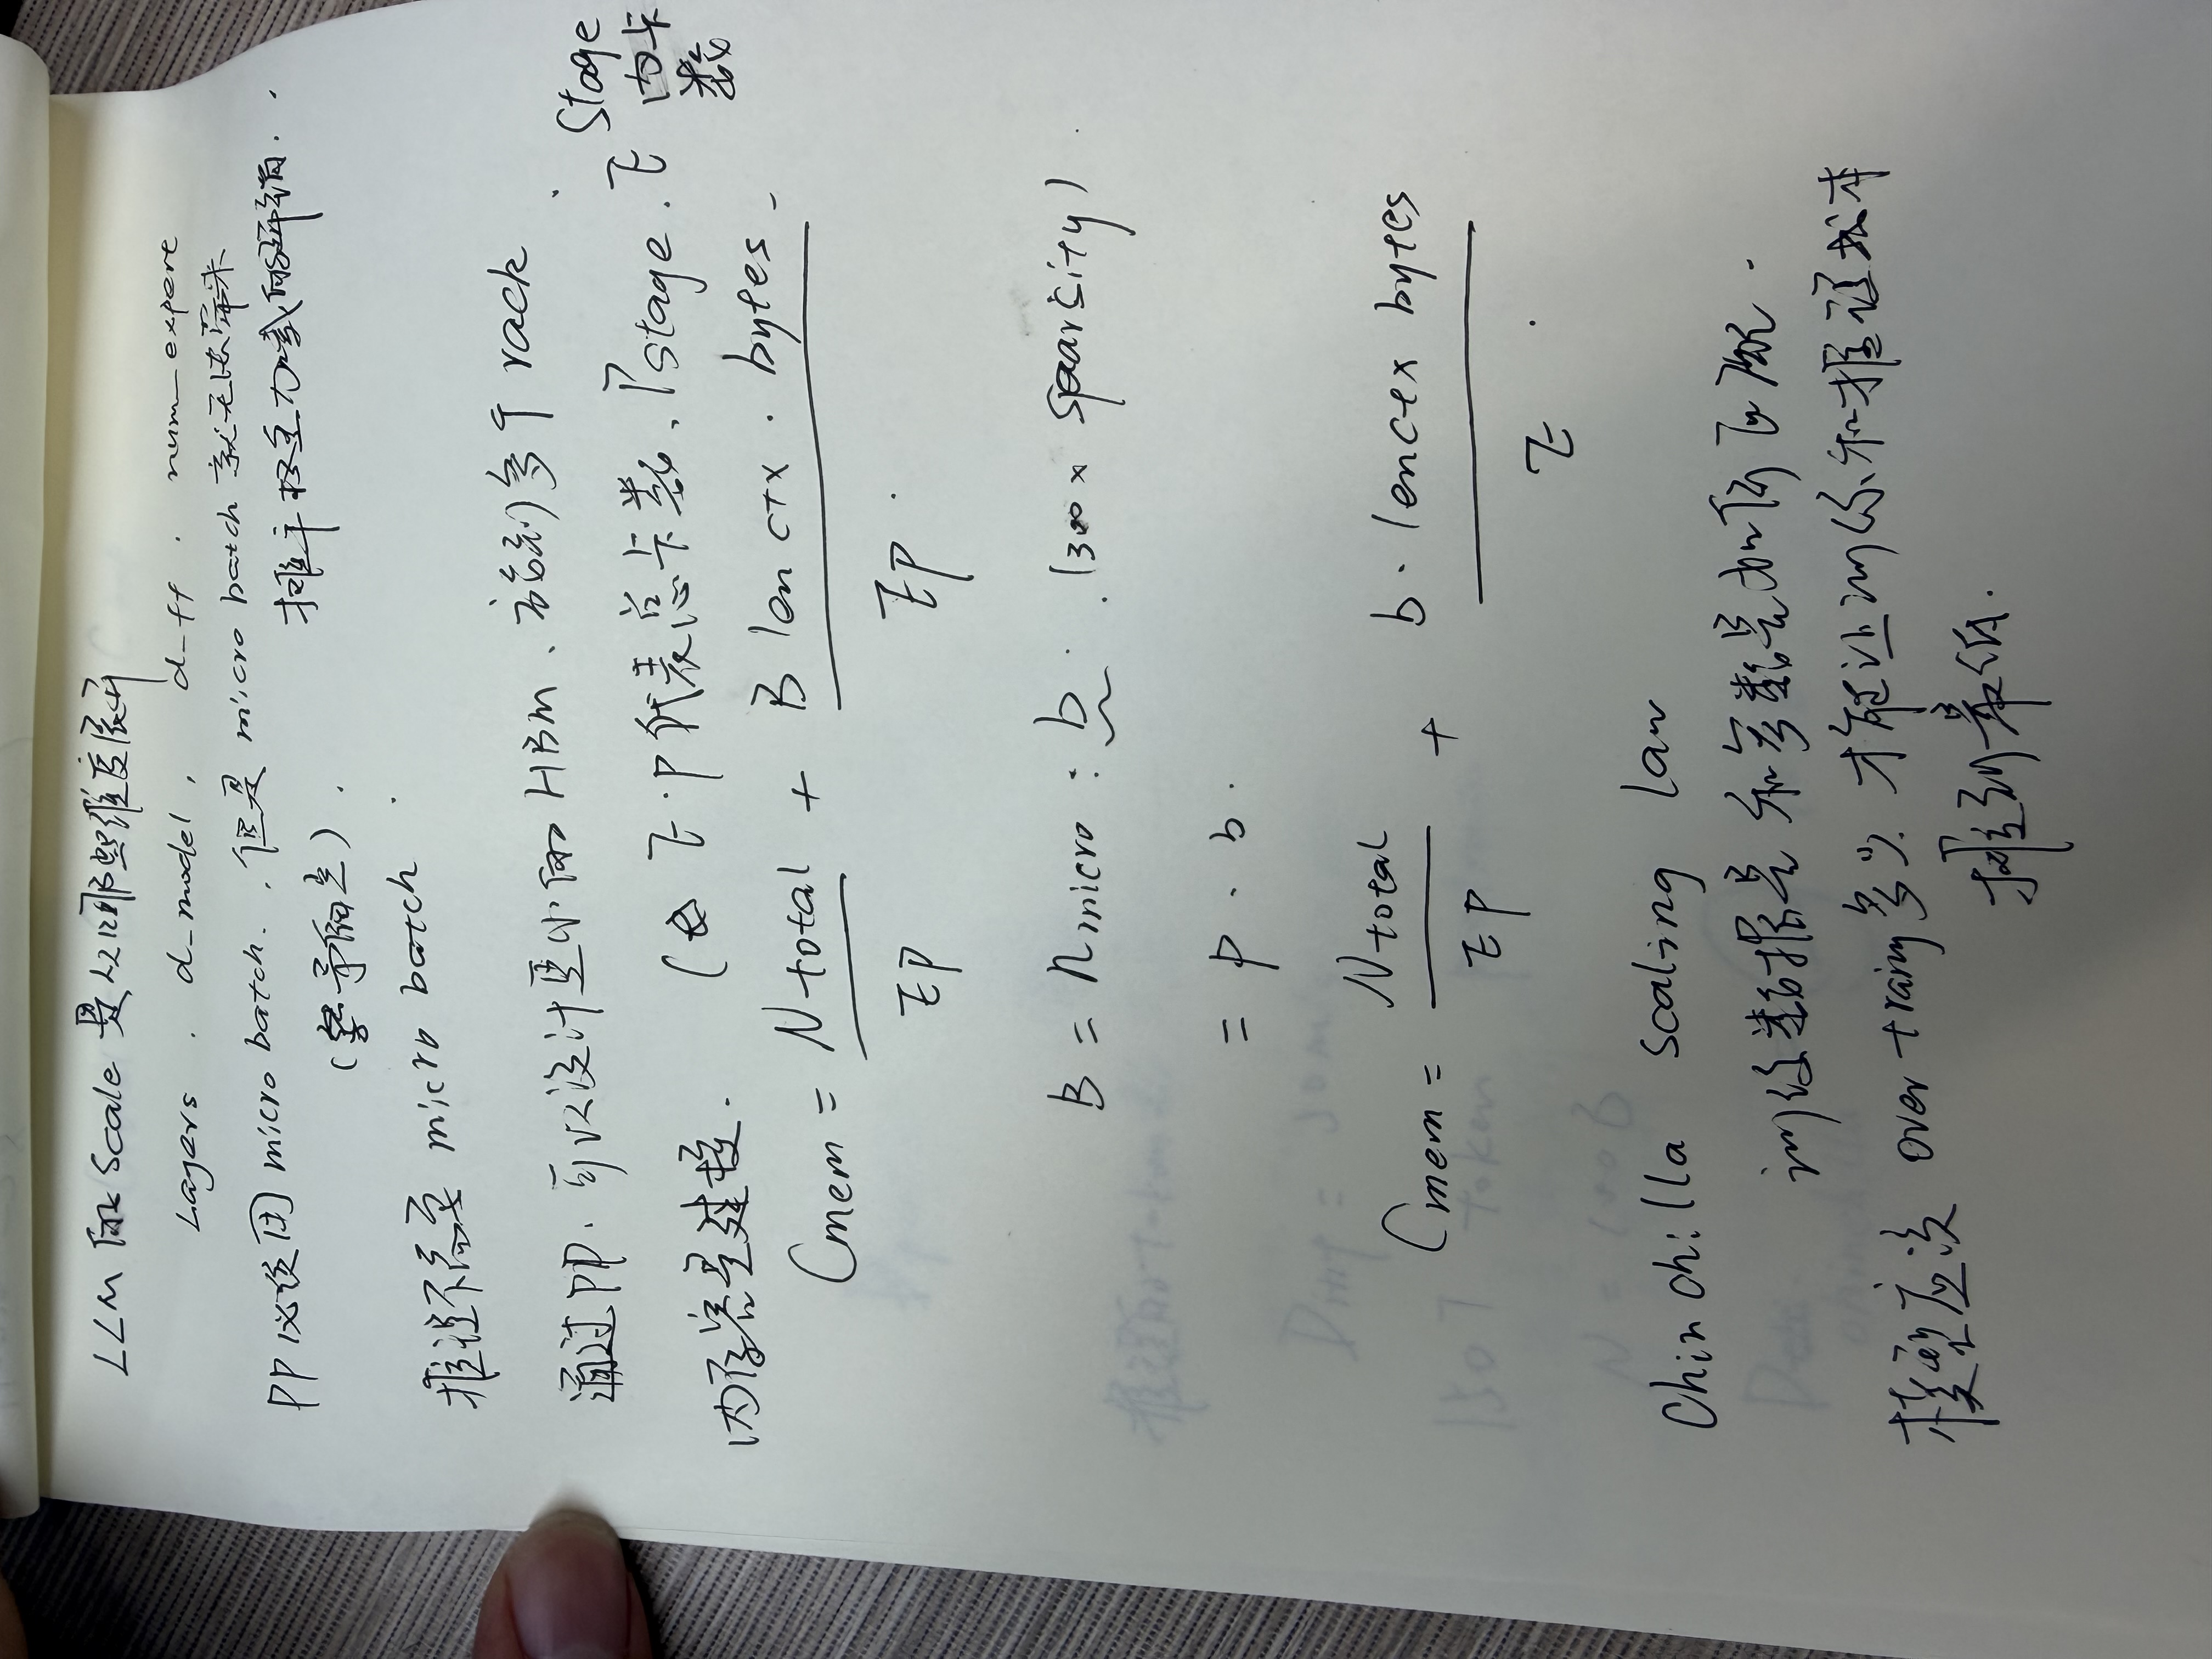
\[ \begin{aligned} t_{\mathrm{memory}} &\approx t_{\mathrm{weight\_fetch}} + t_{\mathrm{KV\_cache\_fetch}} \\ &\approx \frac{\mathrm{total\_params}}{\mathrm{memory\_bandwidth}} + \frac{\mathrm{batch\_size} \times \mathrm{context\_length} \times \mathrm{bytes\_per\_token}} {\mathrm{memory\_bandwidth}} \end{aligned} \]这个模型当然粗糙,但粗糙得很有用。它直接解释了几个常见现象:
- 小 batch 时,权重读取无法被摊销,单 token 成本很高。
- batch 增大后,weight fetch 被更多请求共享,成本迅速下降。
- 再继续增大 batch,成本会碰到 compute/KV cache 的下限,继续等也省不了多少。
- context length 增大时,KV cache 读取线性增加,系统会从 compute-bound 转向 memory-bound。
也就是说,“fast mode” 本质上常常是在买更小的 batch、更高优先级、更少排队,而不是买一个突破物理极限的推理方式。“slow mode” 也不是无限便宜,因为 KV cache 和实际矩阵计算是每个序列自己的工作,不能像 weight fetch 那样无限摊销。
Batch size 是推理经济学的核心旋钮#
第一期最重要的一个经验式是:
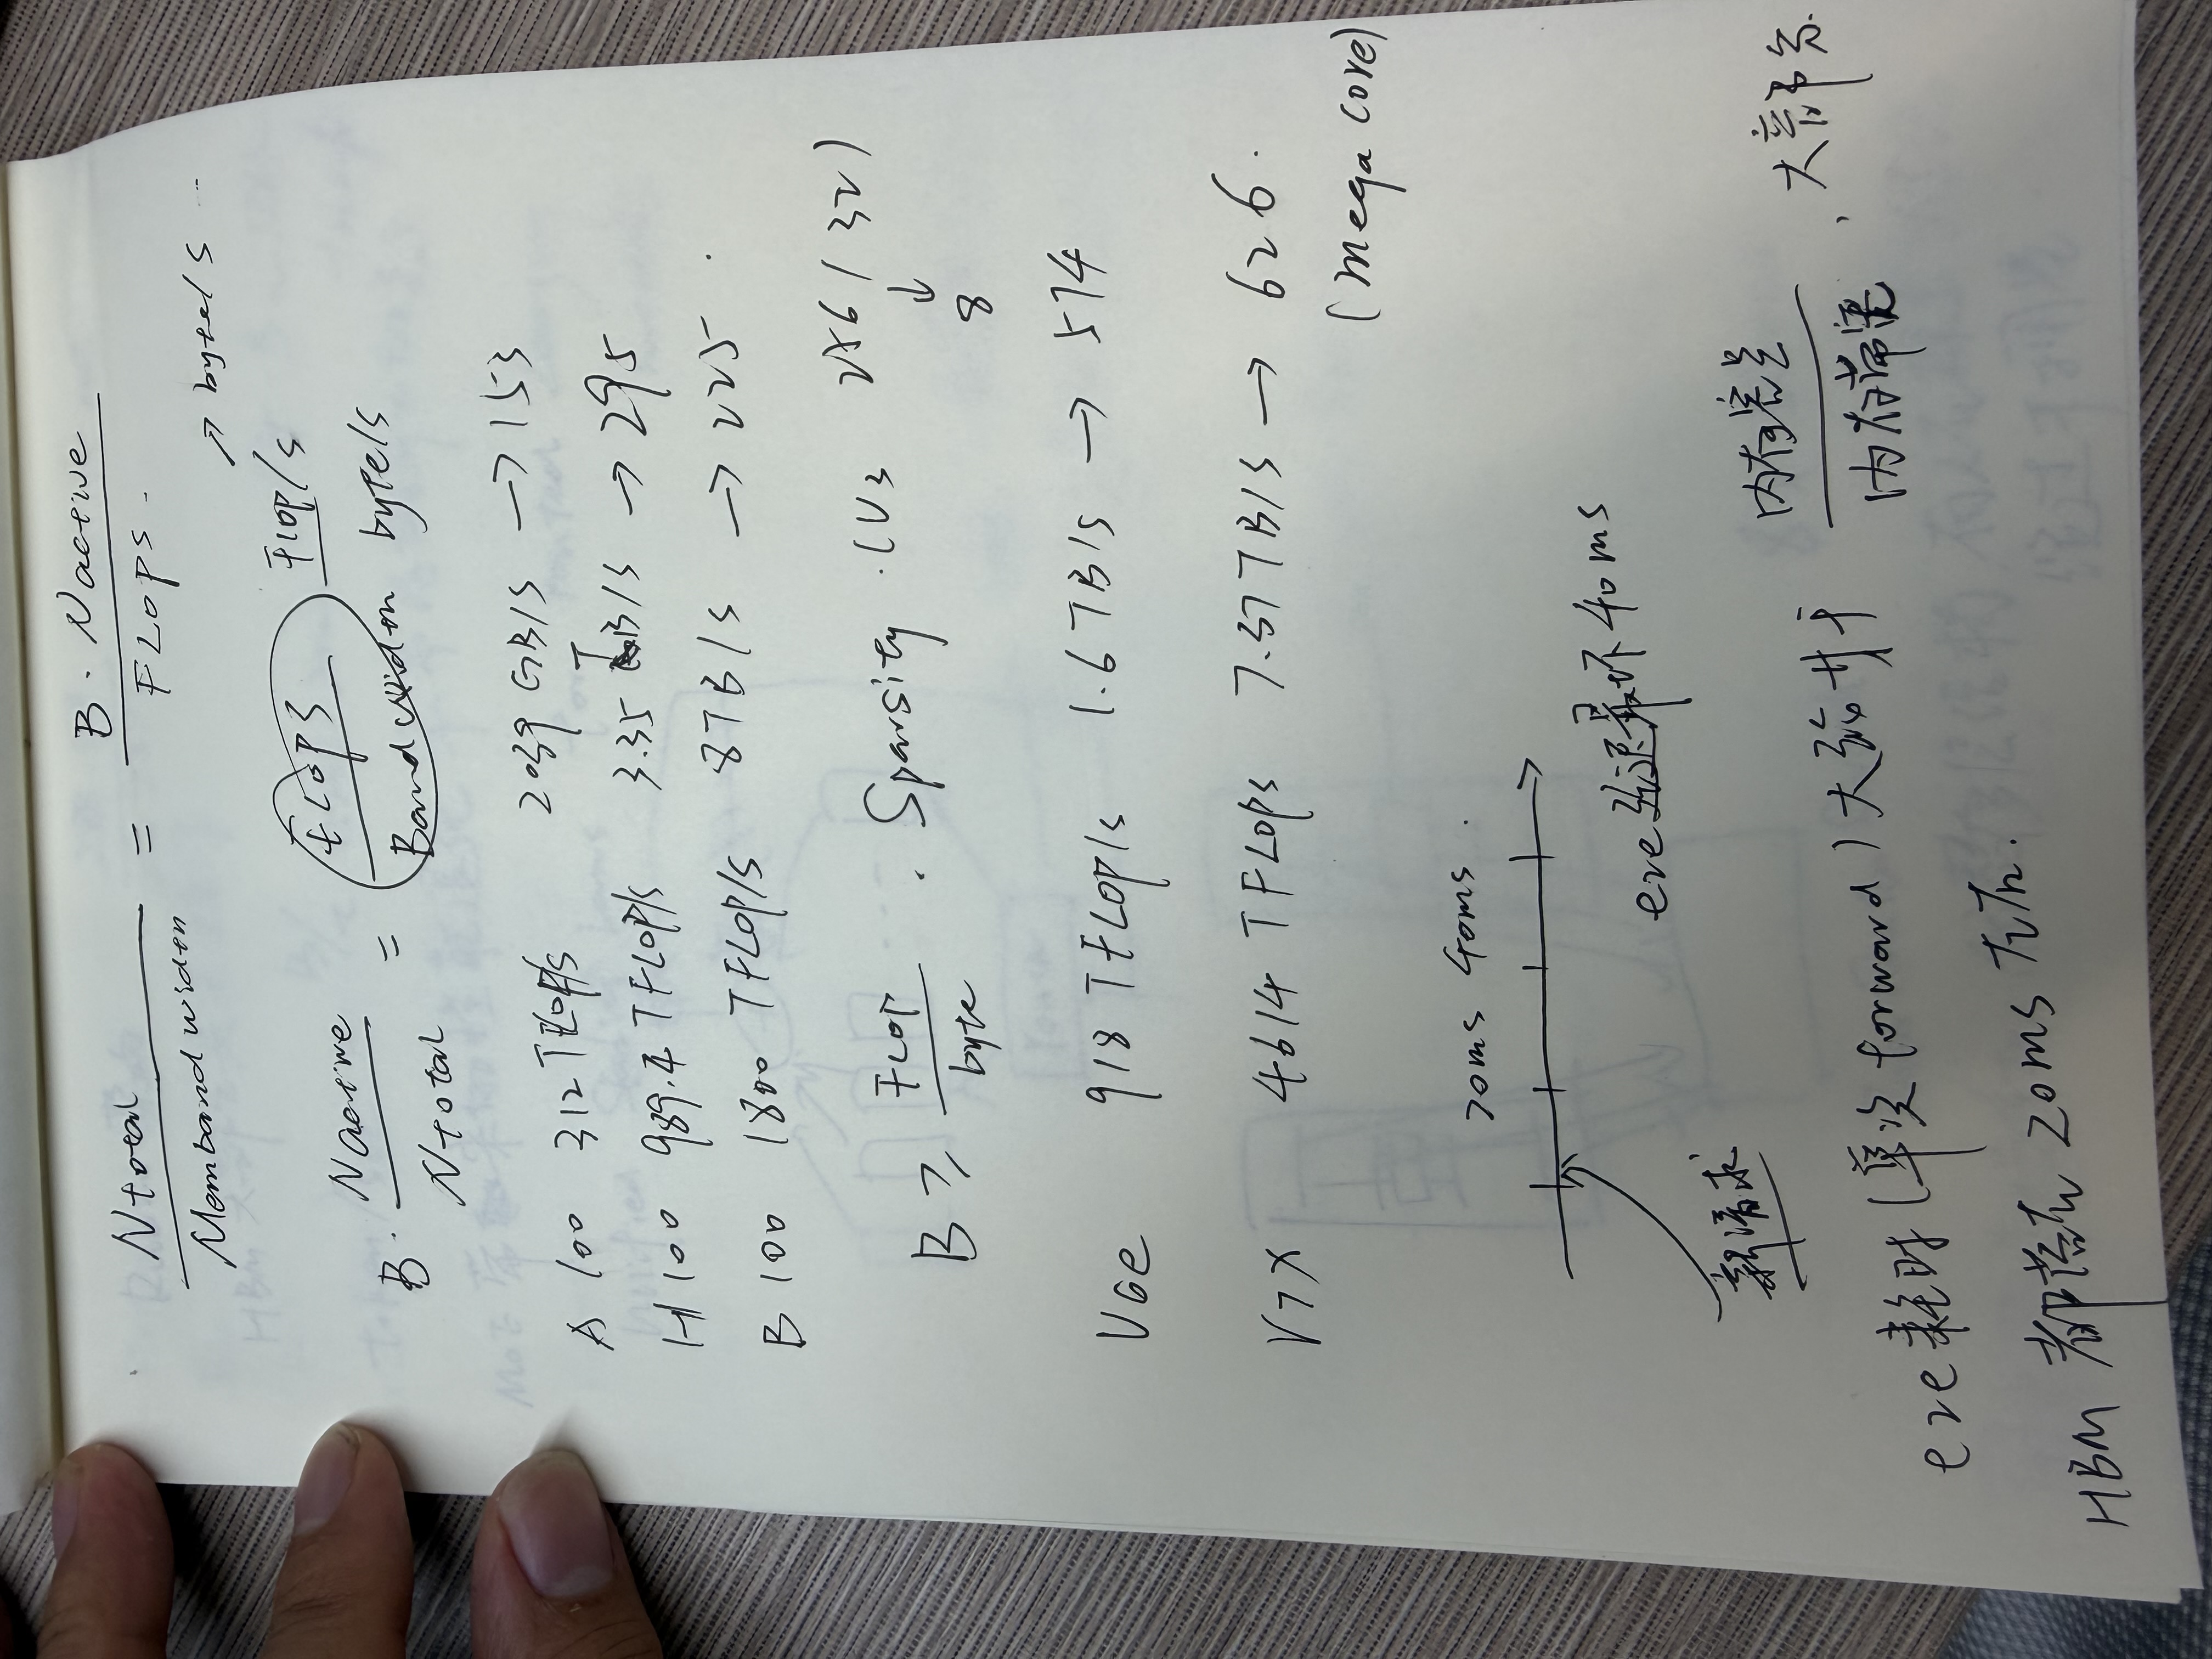
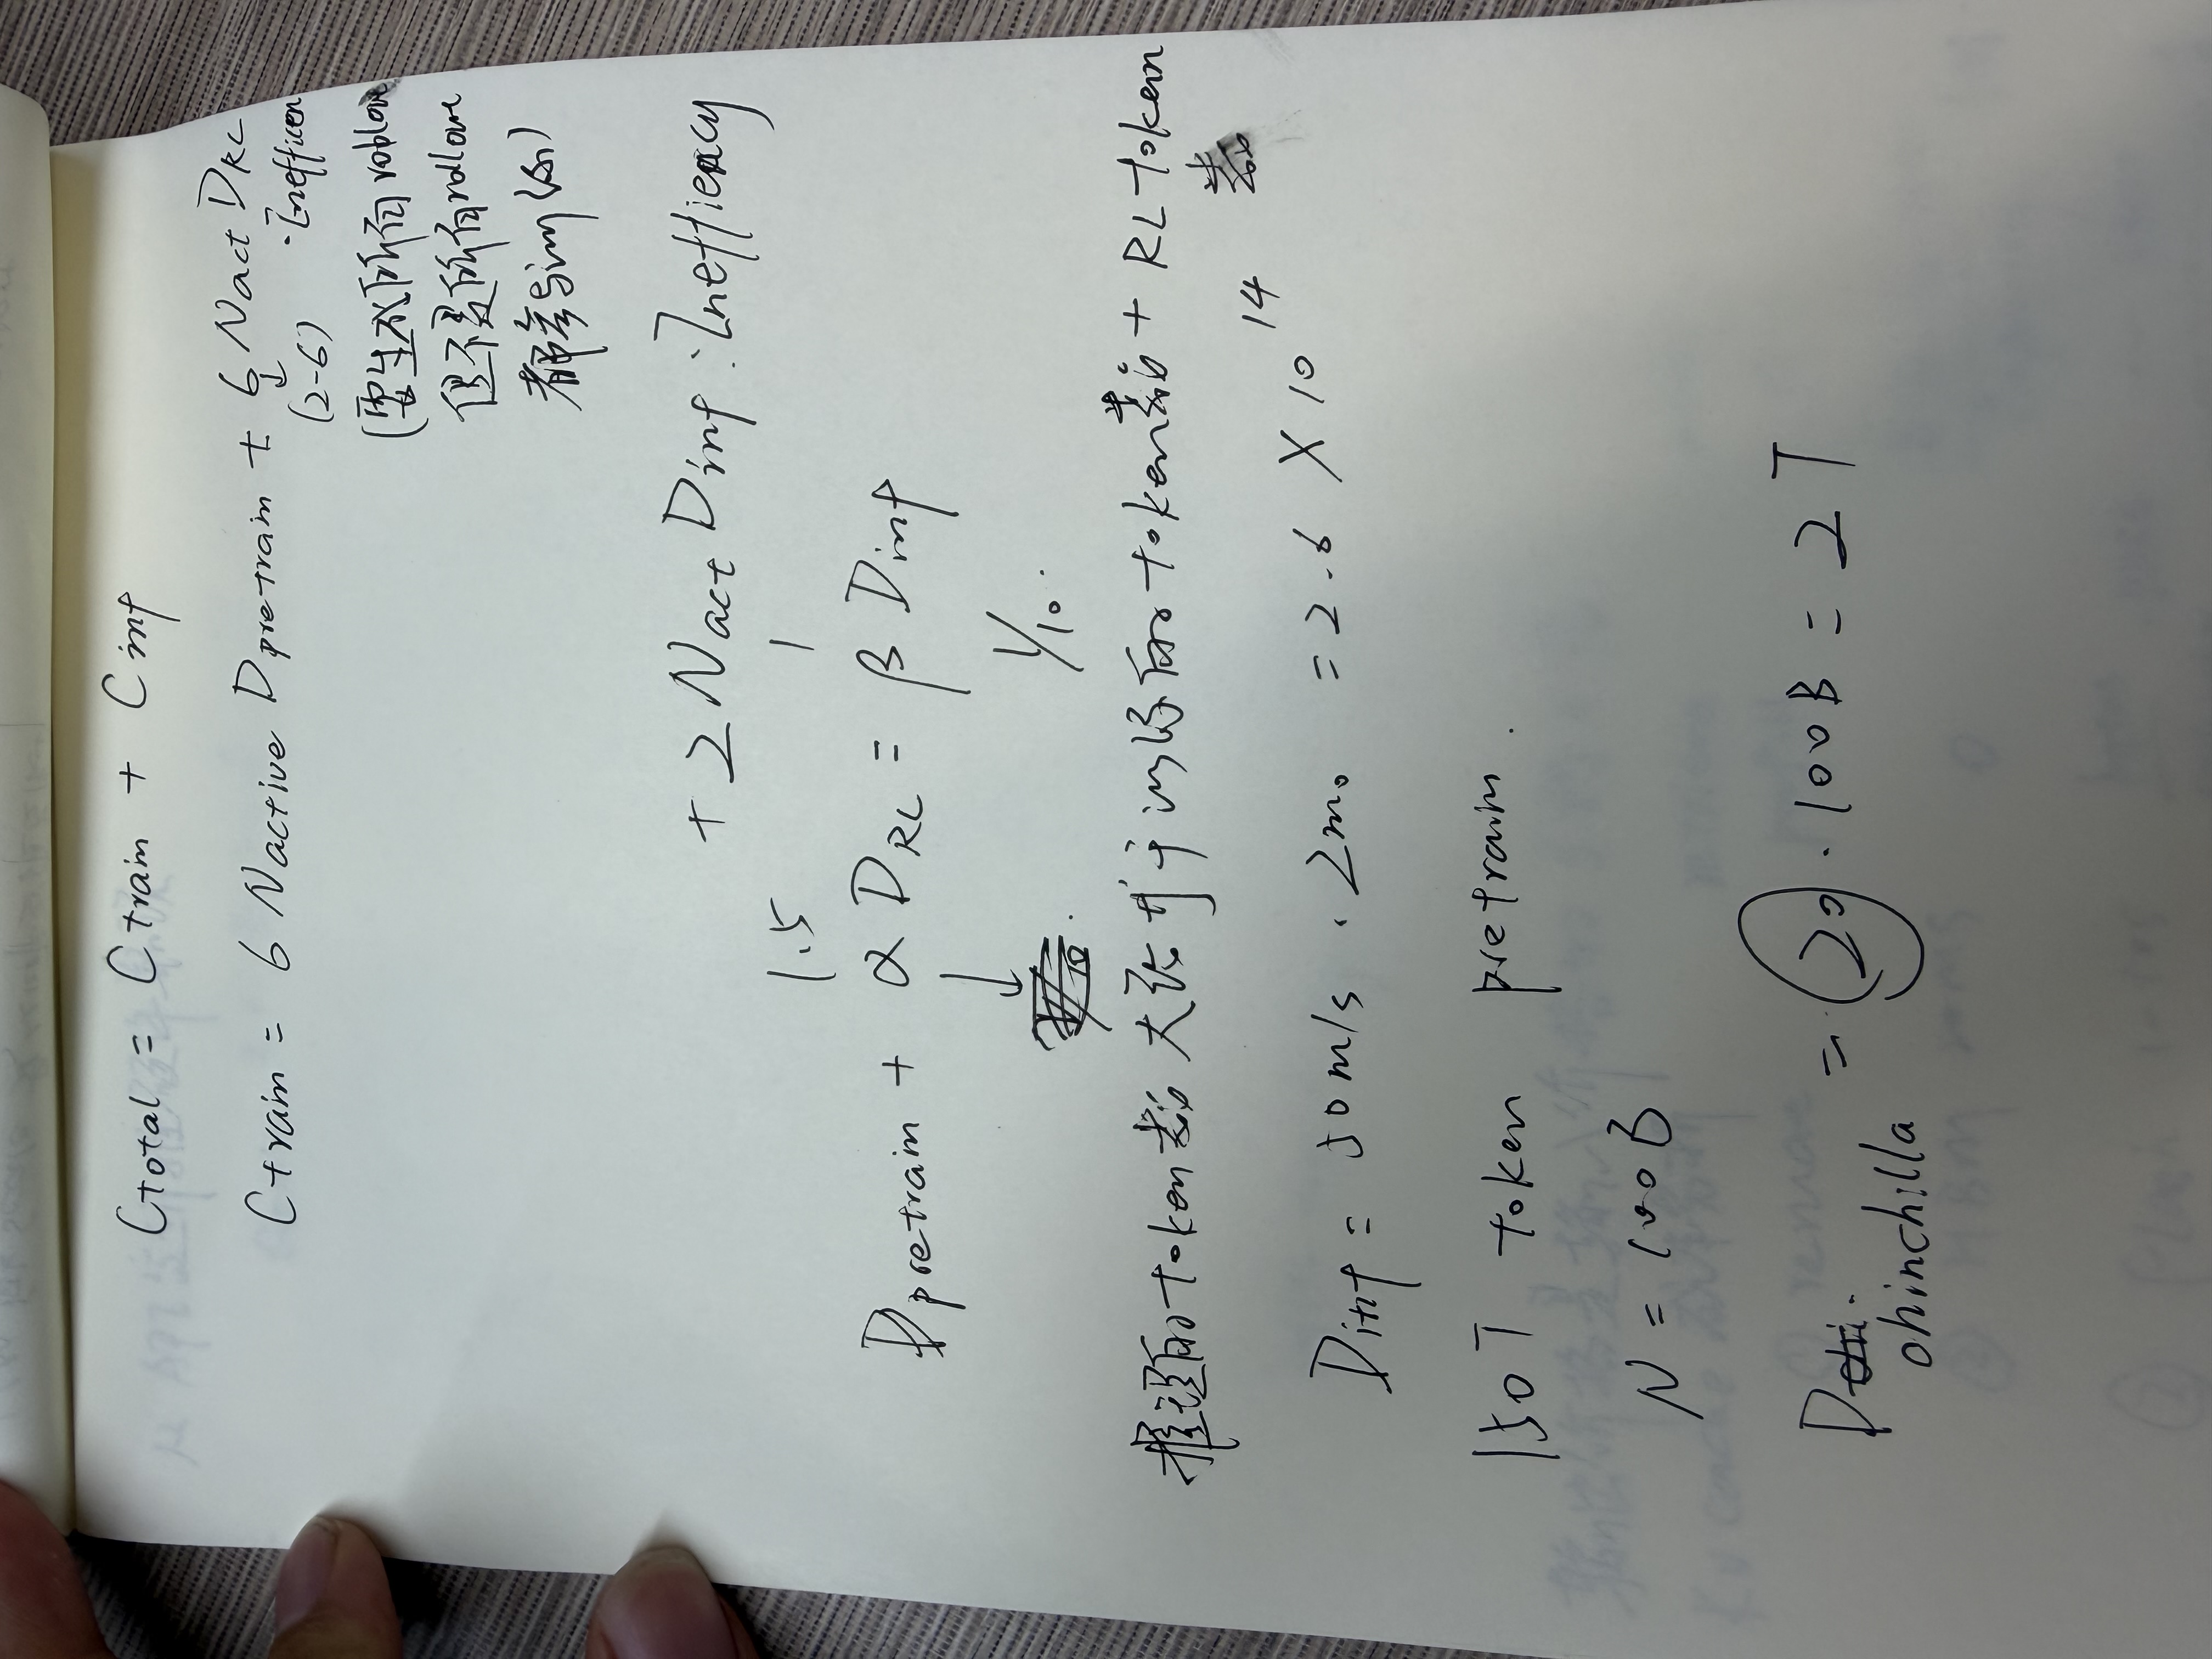
\[ \mathrm{optimal\_batch} \approx 300 \times \mathrm{sparsity} \]这里的 300 来自现代 GPU 上一个相当稳定的硬件比例:
\[ \frac{\mathrm{FLOPs}}{\mathrm{memory\_bandwidth}} \approx 300 \]更准确地说,需要把 FP4/FP8 的字节数也放进去,才能得到一个无量纲的近似常数。直观解释是:芯片每从 HBM 搬来一份权重数据,最好能用它做足够多次乘法,否则矩阵单元就没有被高效喂饱。
对 dense model,sparsity 约为 1,batch 到几百就能接近平衡。对 MoE,情况更微妙。假设总参数很多,但每个 token 只激活一部分专家,那么 active_params / total_params 变小,weight fetch 的摊销压力变大。DeepSeek 这类 “32 of 256 experts active” 的例子,sparsity ratio 约为 8,因此平衡 batch 量级会到几千个并发序列。
这里有一个容易误解的点:这个 batch 不是一次 prompt 里的几千个 token,而是 decode step 中同时为几千个独立序列各生成下一个 token。服务端做 continuous batching,就是把很多用户当前正好需要生成下一个 token 的请求合并成一个大 batch。
这也解释了为什么大模型服务天然偏向规模化。高流量不是只有商业优势,也有物理优势:你有足够多的请求可以填满 batch,就能把 weight fetch 摊薄。低流量服务如果还要低延迟,经济性会很差。
KV cache 是长上下文真正的成本中心#
如果只看权重,batch 可以救很多问题。但长上下文引入了另一个不能轻易摊销的项:KV cache。
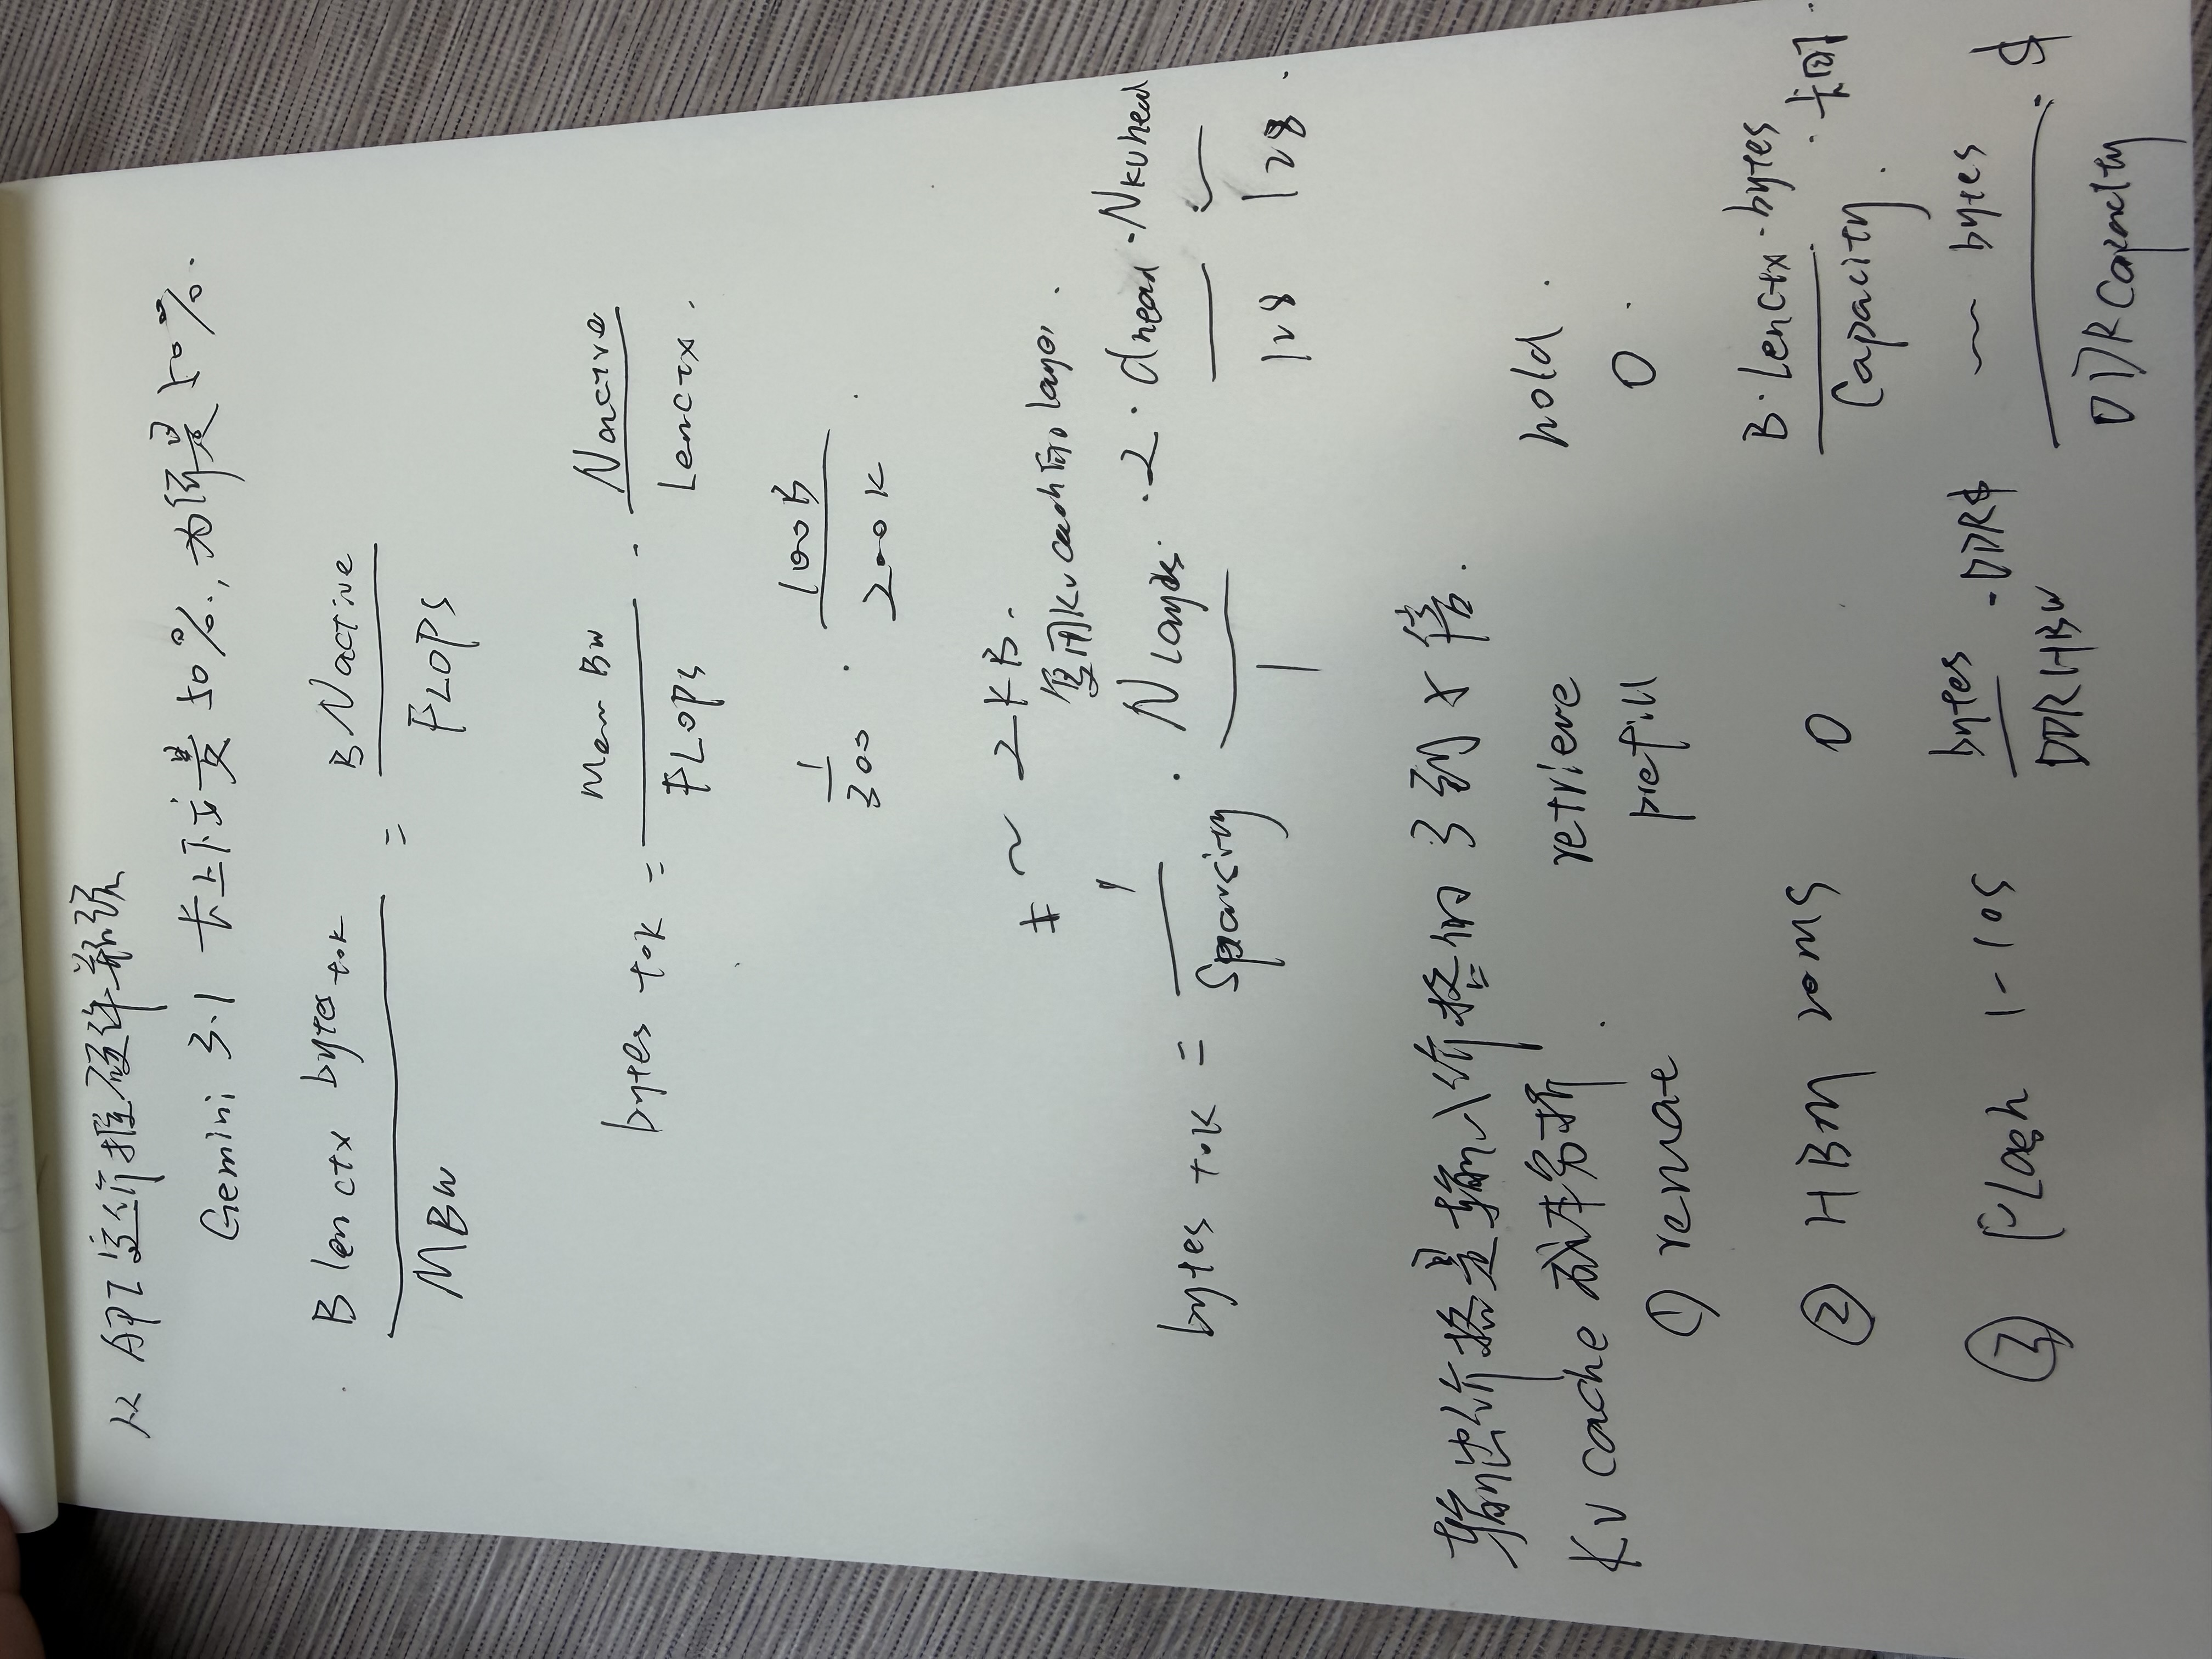
在 autoregressive decode 中,新 token 要 attend 到历史 token。为了避免每一步重算历史 token 的 key/value,系统把每层的 K/V 存起来,这就是 KV cache。它的大小大致由这些因素决定:
\[ \mathrm{KV\ bytes/token} \approx \mathrm{layers} \times 2 \times \mathrm{kv\_heads} \times \mathrm{head\_dim} \times \mathrm{bytes\_per\_element} \]不同模型会通过 MQA/GQA、KV sharing、低精度 KV、稀疏注意力等方式压缩这个量,但只要仍然是 dense attention,decode 阶段访问 KV cache 的成本就会随 context length 增长。
所以长上下文价格不是简单的"输入 token 多一点"。对服务端来说,长上下文意味着:
- HBM 容量压力:KV cache 要放在哪里?
- HBM 带宽压力:每生成一个 token 要读多少历史状态?
- 调度压力:长短请求混 batch 会带来不同的内存访问形状。
- cache tier 选择:热 KV 放 HBM,温 KV 放 DDR/CXL/SSD 时,延迟和价格都会分层。
第一期里很有意思的一点,是用公开 API 定价反推系统约束。例如长上下文在某个阈值后价格上升,可能意味着 KV cache 从一个相对便宜的区间进入了更稀缺的带宽/容量区间。这个反推不等于官方披露,但它说明公开价格本身就是系统设计的影子。
MoE 为什么喜欢一个 rack#
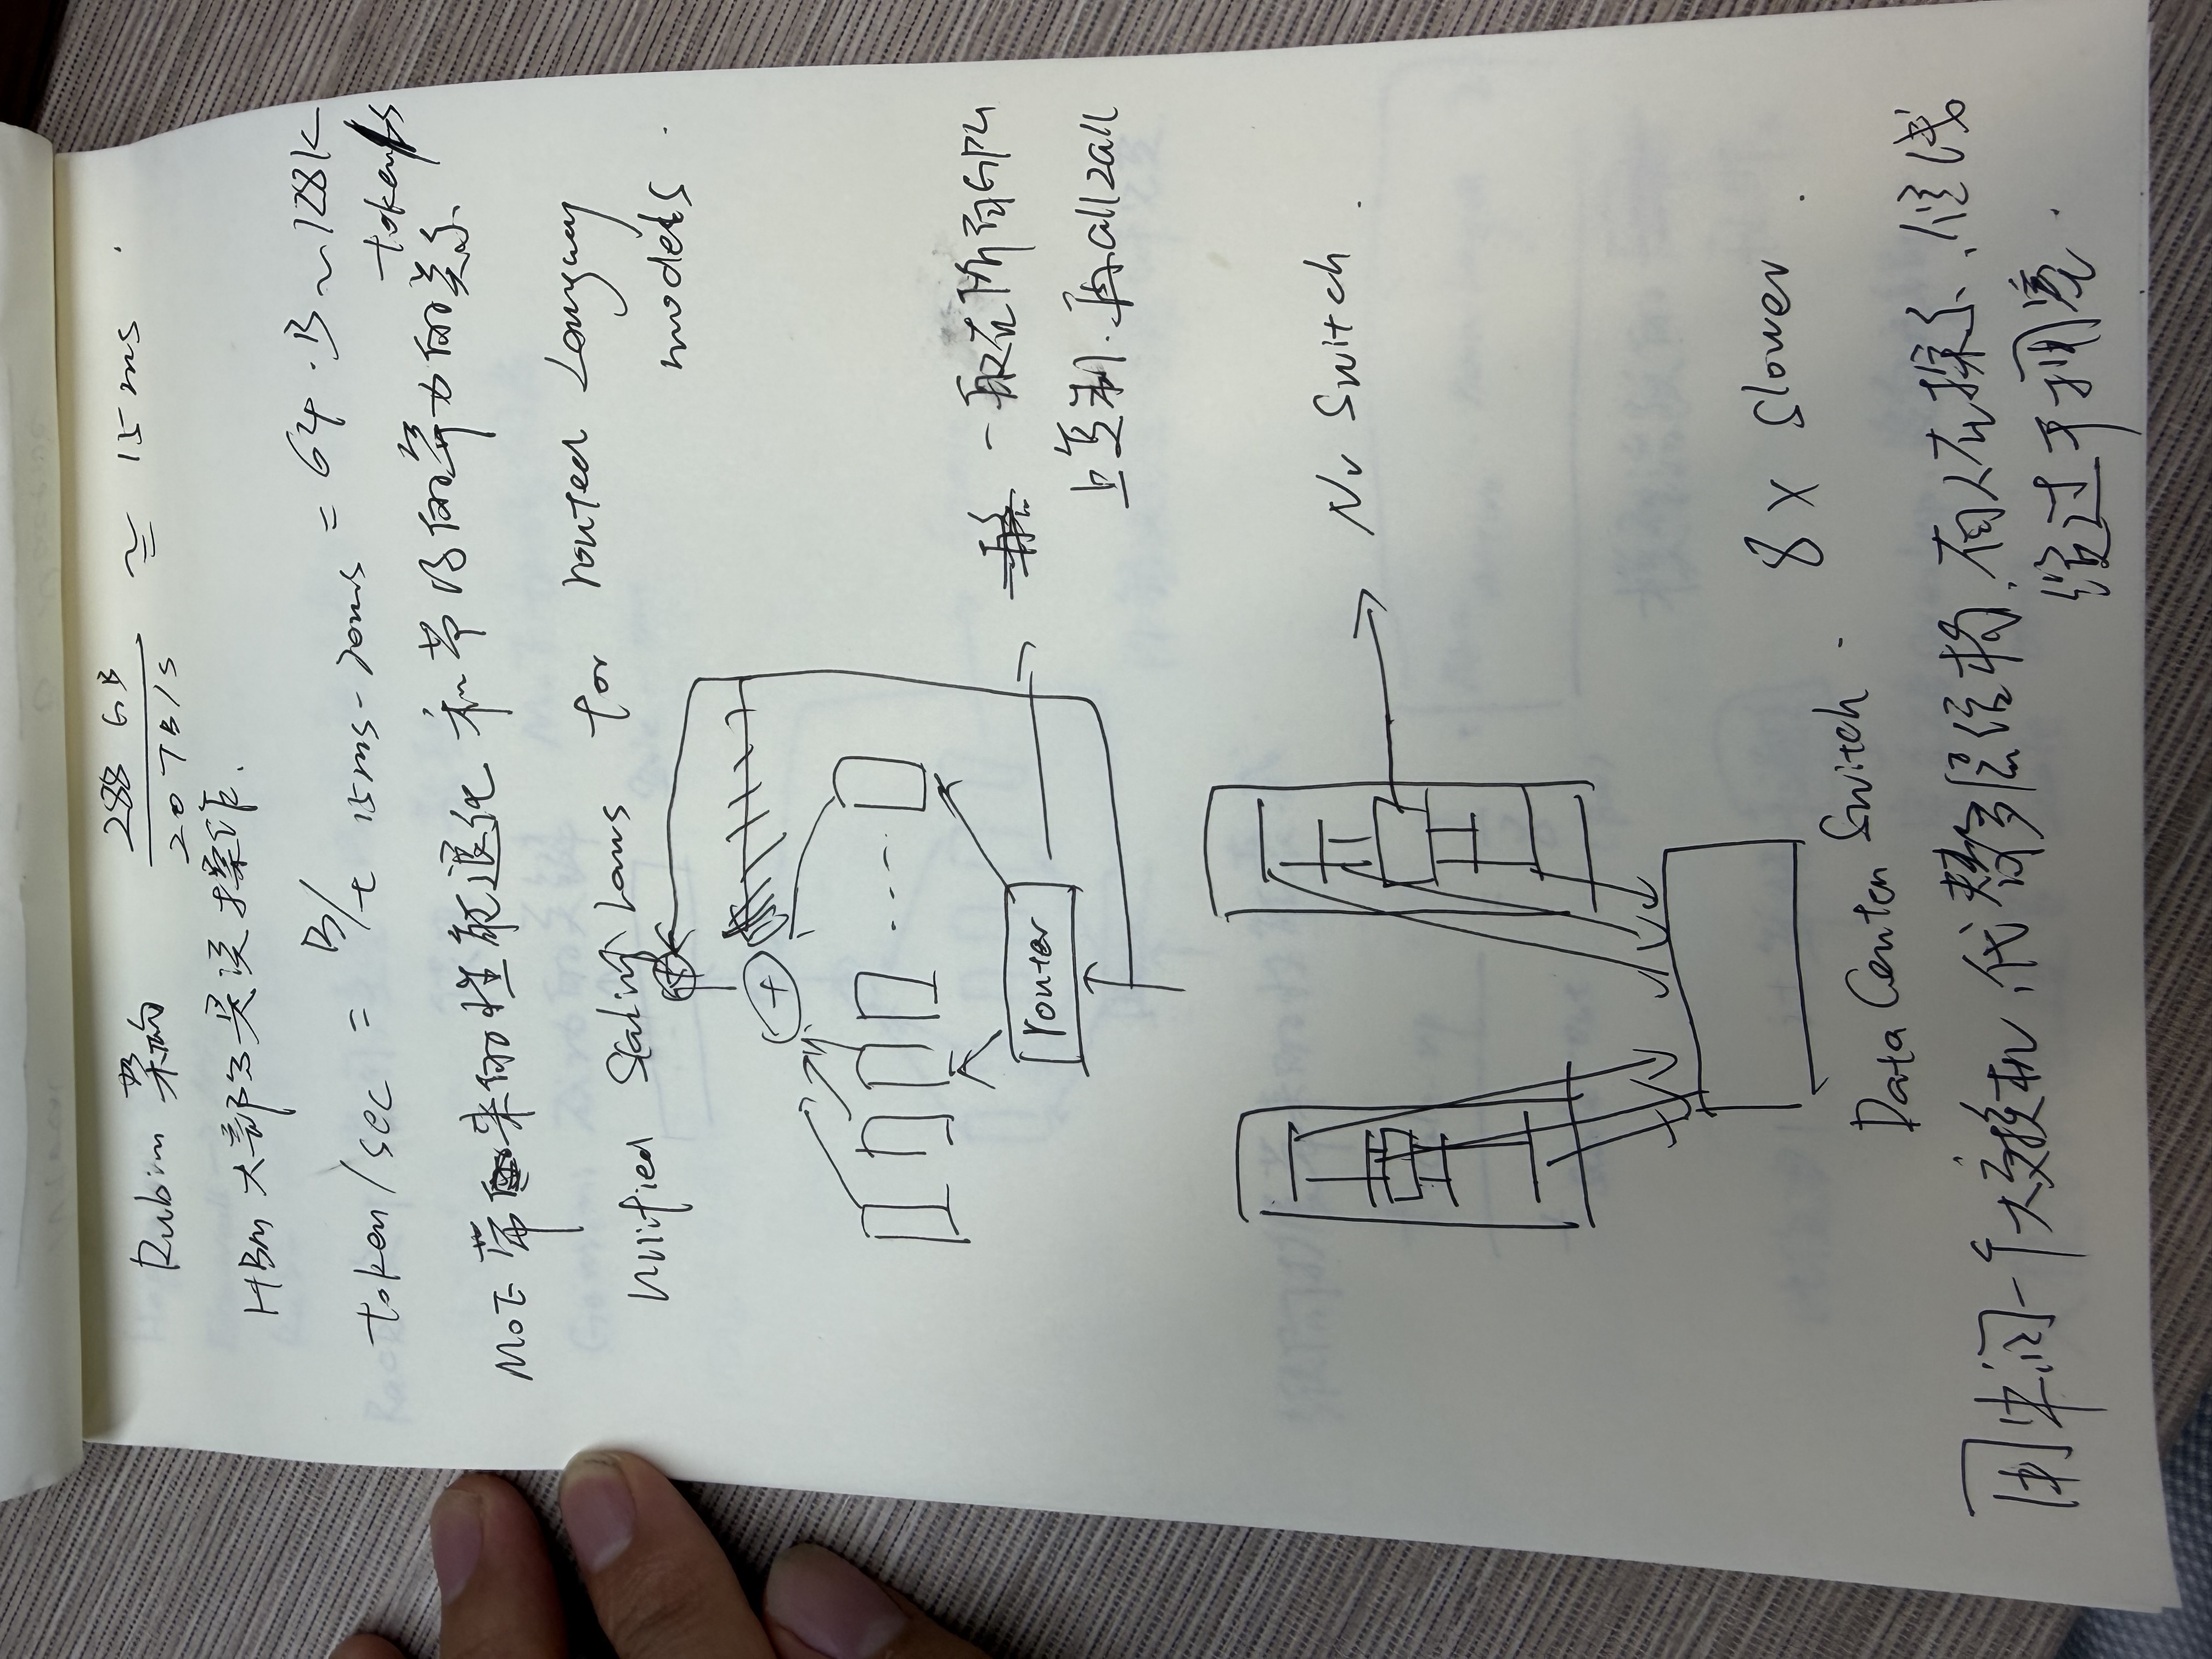
MoE 的好处是降低每个 token 的 active compute:总参数很大,但每个 token 只走少数专家。问题是 expert parallelism 会带来 all-to-all 通信。
如果一个 MoE layer 的专家分布在多张 GPU 上,每个 token 被 router 分配到不同 expert,就需要把 token hidden states 发送到对应专家所在 GPU,算完后再发回来。这是典型 all-to-all。
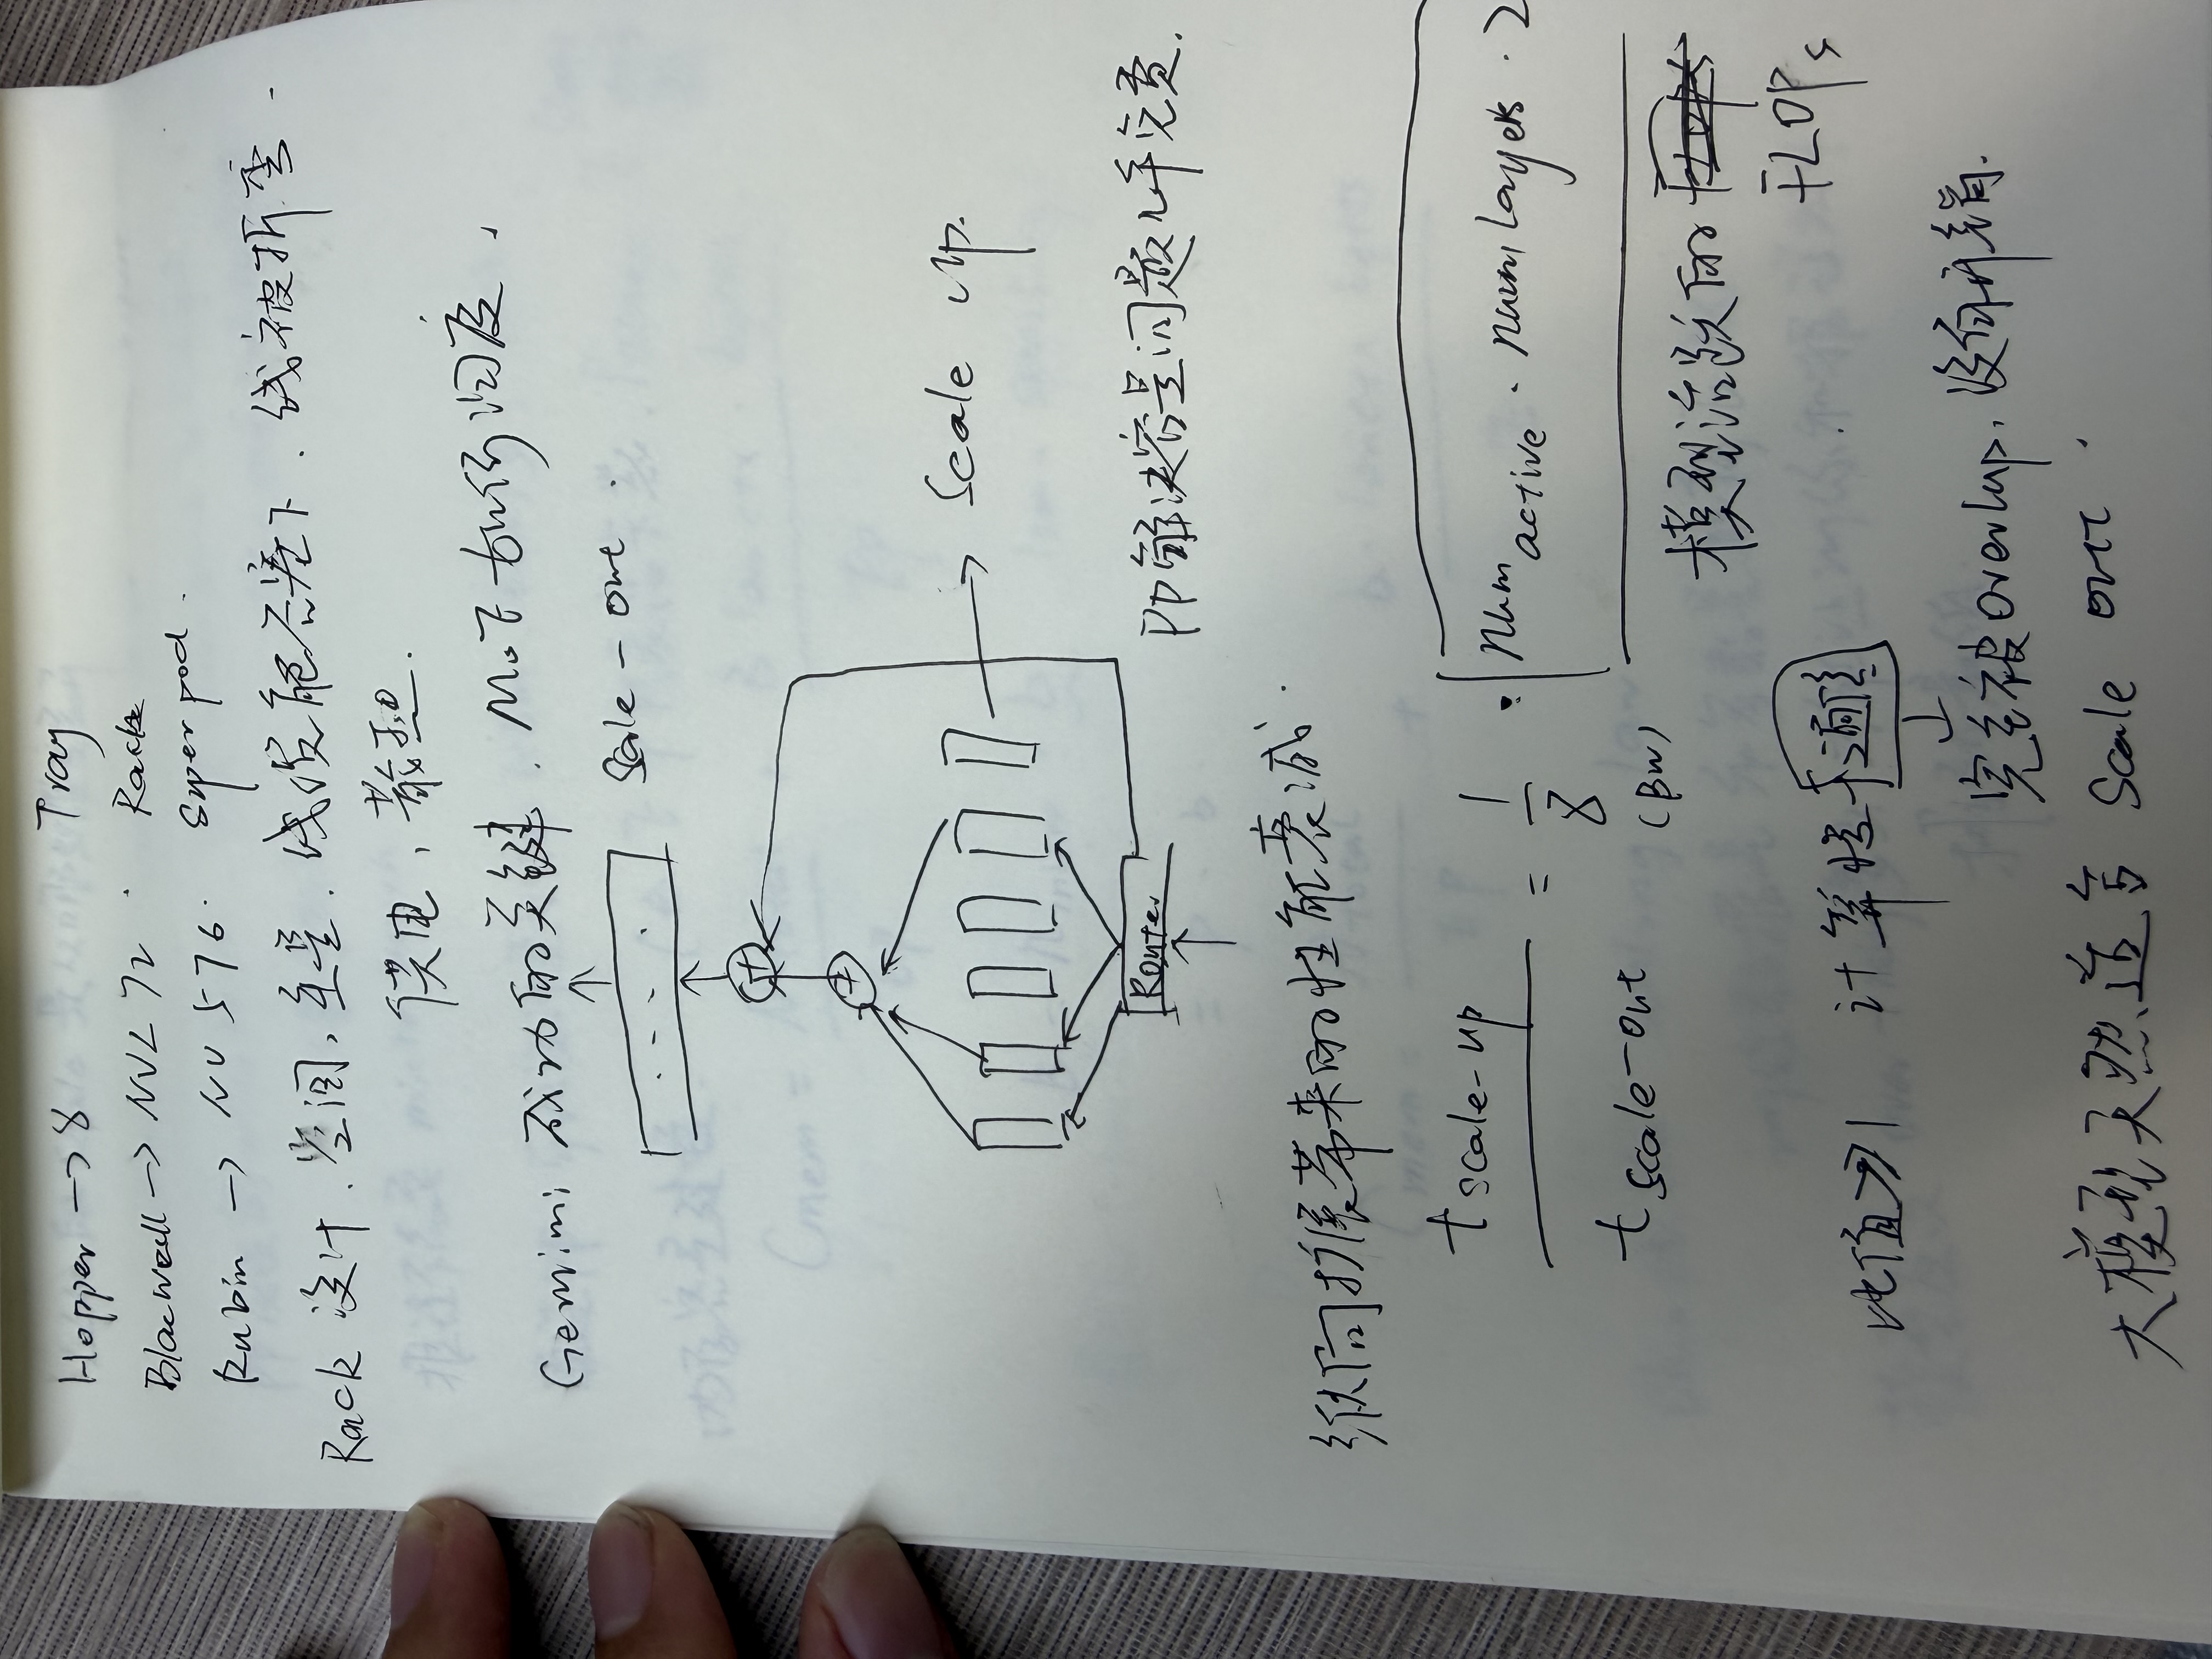
在一个 Blackwell NVL72 rack 里,GPU 之间通过 NVLink/NVSwitch 构成高带宽 scale-up domain,all-to-all 还能跑得动。一旦专家跨 rack,通信就要走 scale-out 网络,带宽、延迟、拥塞模型都会差很多。
所以 MoE 的系统设计不是抽象的"参数分片"问题,而是非常物理的"专家最好塞进一个高速互联域"问题。一个 rack 的大小、rack 内带宽、跨 rack 带宽断崖,会反过来影响模型架构和服务策略。
这也是 GPU 和 TPU 竞争中很关键的地方:不是单 chip FLOPs 谁更大,而是谁能提供更适合模型通信图的 scale-up/scale-out 结构,以及编译器和 runtime 能不能把模型映射上去。
Pipeline parallelism 对训练和推理的意义不同#
Pipeline parallelism 在训练里很有用,因为它能把模型层切到不同设备上,用 microbatch 填流水线,解决单设备放不下模型和激活的问题。
但在 decode 推理里,它没有那么神奇。直觉上,把模型层分到 P 个 stage,每张 GPU 只放 1/P 的权重,似乎能降低内存压力。但为了维持吞吐,流水线中会同时有 P 个 microbatch 在飞。结果对 KV cache 来说,很多节省会被 in-flight batch 数量抵消。
更重要的是,pipeline 会增加 token latency。decode 是逐 token 串行生成,用户看到的是流式延迟,不只是吞吐。训练可以接受更深的流水线,因为目标是全局吞吐;交互式推理则很在乎每个 token 的到达时间。
所以第一期里一个很重要的结论是:训练系统和推理系统不是同一个优化问题。训练偏向高 MFU、高全局吞吐、可接受长 pipeline;推理要同时优化吞吐、成本、首 token 延迟、decode token latency、KV cache 容量和多租户调度。
第二条主线:芯片设计#
第二期从更底层开始:逻辑门如何构成 multiply-accumulate,MAC 如何变成矩阵乘法单元,为什么 systolic array 会成为 AI 芯片的核心。
这里最值得记住的不是某个电路细节,而是一个反直觉事实:
在 AI 芯片里,乘法本身已经便宜到极致,昂贵的是围绕乘法的数据移动和选择逻辑。
Reiner 用 mux 举了一个很好的例子。软件里写"从寄存器文件里选第 3 个值"看起来是 O(1) 的抽象操作,但硬件上要用一堆 AND/OR 门来做选择。register file 越大、端口越多、读写越灵活,选择和布线成本就越高。
这解释了为什么通用 CPU/GPU core 的灵活性并不是免费的。你给程序员更多自由:任意寄存器、任意指令、任意控制流、任意访存模式,硬件就要付出更多面积、功耗和调度复杂度。
AI workload 的核心是大块矩阵乘法。既然计算图这么规则,就应该减少不必要的灵活性,把更多面积用在真正产生 FLOPs 的矩阵单元上。这就是 TPU 类架构的基本哲学。
Systolic array 的意义#
Systolic array 的核心目标是数据复用。矩阵乘法中,一个 weight 或 activation 会被多次使用。如果每次使用都从远处内存读取,带宽和能耗会爆炸。更好的方式是让数据在阵列内部局部移动,在靠近计算单元的地方被重复使用。
这和第一期的 token economics 是同一个问题的不同尺度:
- 第一期开的是集群级账本:HBM 带宽、batch、KV cache、rack 网络。
- 第二期开的是芯片级账本:逻辑门、mux、register file、局部数据复用。
两者的共同目标都是减少昂贵的数据移动,让矩阵单元尽可能忙。
GPU 和 TPU 的差别也可以放在这个框架下理解:
- GPU 有很多相对独立的 SM,更灵活,适合更广的工作负载,也能靠 CUDA 生态承载大量手写优化。
- TPU 的矩阵单元更粗粒度,控制更集中,依赖编译器把大块张量程序映射成高效的数据流。
- GPU 把很多复杂度暴露给程序员和 runtime,TPU 把更多复杂度推给 compiler 和静态调度。
这不是简单的谁先进谁落后,而是不同设计点。GPU 购买的是通用性和生态;TPU 购买的是在目标 workload 上更直接的系统级效率。
Cache vs scratchpad 的取舍#
第二期还讲到 cache 和 scratchpad 的区别。CPU/GPU 传统上大量依赖 cache:程序发出 load/store,硬件猜测哪些数据会复用,自动放进多级 cache。好处是易用,坏处是性能有时不透明。
TPU 更偏向软件管理内存。编译器知道张量形状、分片方式、循环结构,可以提前安排数据搬运和计算。这种方式牺牲了一些动态灵活性,但换来更可预测的数据流。
这和 XLA/JAX 的关系很深。TPU 的硬件哲学假设你能拿到足够高层的计算图,能静态分析,能做 layout、sharding、fusion、collective scheduling。如果 workload 是 PyTorch eager 风格、形状动态、控制流复杂、kernel 很碎,那么 GPU 的灵活性会更舒服。如果 workload 是巨大的规则 transformer block,TPU 的设计就能发挥。
换句话说,TPU 不是一块孤立的芯片,而是一套"模型-编译器-芯片-机群"共同设计的系统。
AI 硬件的设计哲学#
把两期合起来看,AI 硬件的核心不是追求某个孤立指标最大,而是在多个比值之间找平衡:
- FLOPs / HBM bandwidth:决定多大 batch 才能摊销 weight fetch。
- HBM capacity / HBM bandwidth:决定一次完整扫内存的大致时间,也影响 decode 调度节奏。
- compute / communication:决定 tensor parallel、expert parallel、pipeline parallel 哪个可行。
- scale-up bandwidth / scale-out bandwidth:决定一个 rack 能承载多大的 MoE 通信域。
- matrix unit area / data movement area:决定芯片上多少面积真正用于乘法,多少面积用于搬运和选择。
很多产品和架构现象都能从这些比值里长出来:
- fast mode 贵,是因为小 batch 不能充分摊销权重读取。
- 长上下文贵,是因为 KV cache 消耗容量和带宽。
- MoE 喜欢 rack 内 all-to-all,是因为跨 rack 通信断崖太大。
- TPU 依赖编译器,是因为它用较少动态灵活性换取更高的规则矩阵效率。
- GPU 生态强,是因为通用性和可编程性让更多 workload 能先跑起来。
- 推理芯片开始和训练芯片分化,是因为 decode 的瓶颈越来越不像 pretraining。
这也是为什么只比较 “TFLOPS” 很容易误导。真正的 AI 系统性能来自一组协调的资源:FLOPs、HBM、SRAM/cache、互联、调度、编译器、模型架构。任何一个比例失衡,都会让其他资源闲置。
对系统和 kernel 的启发#
这两期对工程实践最有用的地方,是提醒我们不要只在代码层理解性能。
做 kernel 优化时,应该先问:
- 当前 op 是 compute-bound 还是 memory-bound?
- 数据是否被复用,复用发生在 HBM、L2/VMEM、SMEM/SRAM、register,还是根本没复用?
- tile size 是为了提高 arithmetic intensity,还是只是把 occupancy 做高?
- 如果加大 batch,瓶颈会从 weight bandwidth 转到 compute 还是 KV bandwidth?
- collective 的通信图是否符合物理拓扑?
做推理系统时,应该先问:
- decode batch 的填充率如何?
- 长短上下文是否混在一起导致 KV 访问形状变差?
- fast/slow tier 的本质是调度策略、batch 大小、spec decode,还是硬件隔离?
- KV cache 应该放在 HBM、host memory、CXL、SSD,还是做分层?
- MoE expert placement 是否尊重 rack 内外带宽差异?
做模型架构时,也应该意识到硬件会反过来塑造模型:
- GQA/MQA 降低 KV bytes per token,因此直接降低长上下文 decode 成本。
- MoE 降低 active compute,但会增加通信和调度复杂度。
- Sparse attention 能改变 KV cache 随 context length 线性增长的问题,但需要模型质量和 kernel 支持一起成立。
- 低精度不只是算力翻倍,还会改变数据移动、cache 容量和互联压力。
推荐阅读顺序#
如果要系统学习,我建议按这个顺序:
- 先看第一期视频的前 40 分钟,理解 batch size、weight fetch、KV cache 三个项。
- 读 Jianyu Huang 的 token economics 笔记,它把第一期的推导整理得很清楚。
- 回到第一期后半段,看 MoE、pipeline parallelism、长上下文定价。
- 看第二期,从 MAC、mux、systolic array 建立芯片级直觉。
- 补 How To Scale Your Model 里的 Roofline、TPU、GPU、Inference 章节。
这两期不是轻松内容,但非常值得。它们提供的不是某个具体芯片的参数表,而是一套看 AI 系统的坐标系:从一个 token 的价格,一直看到芯片上一个 mux 的成本。
参考链接#
- Dwarkesh Podcast: Reiner Pope - The math behind how LLMs are trained and served
- YouTube: How GPT, Claude, and Gemini are actually trained and served - Reiner Pope
- Dwarkesh Podcast: Reiner Pope - Chip design from the bottom up
- YouTube: Chip design from the bottom up - Reiner Pope
- Flashcards: Dwarkesh Podcast Flashcards
- Jianyu Huang: The Economics of a Token: A Roofline Tour of Frontier Inference
- JAX Scaling Book: How To Scale Your Model