标量预取与块稀疏计算#
目录#
在本教程中,我们将介绍 Pallas 中块稀疏计算的基础知识。稀疏计算是编写自定义 Pallas 内核而非简单使用 JAX/XLA 的一个主要原因,因为由于静态数组形状的限制,在 XLA 中通常很难表达执行动态计算量的程序。在本教程中,我们将学习如何使用 Pallas 的标量预取功能来编写块稀疏内核,这些内核可以动态地跳过计算和内存块。
import functools
import timeit
import numpy as np
import jax
from jax import numpy as jnp
from jax import lax
from jax.experimental import checkify
from jax.experimental import pallas as pl
from jax.experimental.pallas import tpu as pltpu

assert "TPU" in jax.devices()[0].device_kind, "请在 TPU 设备上运行此笔记本。"
print("Running on", jax.devices()[0].device_kind)
Running on TPU v5 lite使用标量预取的动态块索引#
我们将利用 Pallas 的"标量预取"功能来编写稀疏内核。标量预取允许你将少量数据传入 SMEM(“标量内存”),该数据在流水线开始之前加载(“预取”)。因为这些数据在流水线之前加载,所以它可以在每个 BlockSpec 的 index_map 中使用,允许你执行数据依赖的索引计算。本教程的主要目标是介绍利用此功能的常见编程模式。
要使用标量预取,请使用 pltpu.PrefetchScalarGridSpec 代替标准的 pl.GridSpec:
class PrefetchScalarGridSpec:
  def __init__(self,
    num_scalar_prefetch: int,
    grid: tuple[int, ...],
    in_specs: PyTree[BlockSpec],
    out_specs: PyTree[BlockSpec],
    scratch_shapes: tuple[MemorySpace, ...]):
      ...
num_scalar_prefetch 参数指示标量预取值的数量。当设置为非零值时,它会更改内核和索引映射的调用签名以期望额外的预取值。传入 index_map 和内核的预取 Ref 全部分配在 SMEM 中,并且不会被分区为块,因为它们没有定义 BlockSpec。此外,index_map 和内核的参数顺序始终是固定的,如下所述:
- 每个
BlockSpec的index_map现在期望预取Ref在 grid 索引之后:
def index_map(*grid_indices, *prefetch_refs):
...- 用户定义的内核期望预取
Ref在输入Ref之前。此外,scratch ref 在输出Ref之后:
def kernel(*prefetch_refs, *input_refs, *output_refs, *scratch_refs):
...- 使用
pallas_call调用新内核时,pallas_call返回的函数也期望标量预取参数在输入之前,例如:
kernel = pl.pallas_call(...)
result = kernel(*prefetch_args, *input_args)示例:使用标量预取的块动态切片#
让我们从一个展示如何使用标量预取功能的基本示例开始。我们将实现一个块对齐的动态切片内核,它根据用户指定的索引从较大的数组中提取一个块:
在内核外部,我们计算要提取的块索引为:
block_idx = (start[0] // size[0], start[1] // size[1])我们将
block_idx作为标量预取参数传入pallas_call。在我们的索引映射中,我们使用块索引通过返回
(block_idx[0], block_idx[1])来选择对应的块。
当然,这个内核有局限性,我们的切片大小必须适合内核块(受 VMEM 大小限制),并且我们只能从大小对齐的索引开始。更高级的内核会将内核块大小与切片大小解耦,并允许非对齐的起始索引。
def dynamic_slice_kernel(indices, x_ref, o_ref):
  del indices
  o_ref[...] = x_ref[...]

@checkify.checkify
@functools.partial(jax.jit, static_argnums=(2,))
def block_dynamic_slice(x, starts, sizes):
  grid_spec = pltpu.PrefetchScalarGridSpec(
      num_scalar_prefetch=1,
      grid=(1, 1),
      in_specs=[pl.BlockSpec(
          sizes,
          lambda i, j, block_idx: (block_idx[0], block_idx[1]))],
      out_specs=pl.BlockSpec(sizes, lambda *_: (0, 0)),
  )

  kernel = pl.pallas_call(
    dynamic_slice_kernel,
    grid_spec=grid_spec,
    out_shape=jax.ShapeDtypeStruct(shape=sizes, dtype=x.dtype),
  )
  # Checkify 插入运行时断言,检查 starts 是否能被块大小整除。
  checkify.check(starts[0] % sizes[0] == 0, "Starts must be divisible by size.")
  checkify.check(starts[1] % sizes[1] == 0, "Starts must be divisible by size.")
  block_idx = jnp.array([starts[0] // sizes[0], starts[1] // sizes[1]])
  return kernel(block_idx, x)

shape = (512, 512)
x = jnp.reshape(jnp.arange(np.prod(shape), dtype=jnp.int32), shape)
err, result = block_dynamic_slice(x, starts=(128, 256), sizes=(128, 128))
err.throw()
ref = lax.dynamic_slice(x, start_indices=(128, 256), slice_sizes=(128, 128))
diff = jnp.max(jnp.abs(result - ref))
print("Error |result - lax.dynamic_slice| =", diff)
Error |result - lax.dynamic_slice| = 0稀疏内核:表示稀疏数据#
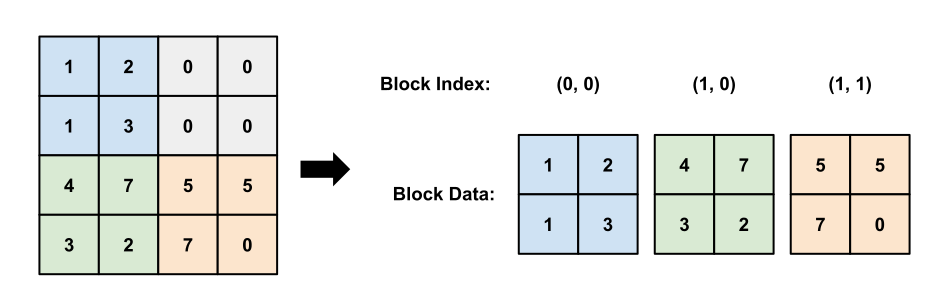
在深入实现稀疏内核之前,让我们先回顾一下稀疏矩阵是如何表示的。虽然存储稀疏矩阵有几种流行的格式,但我们将遵循坐标列表格式(COO)的一个分块变体,其中我们将矩阵存储为 (块索引, 块数据) 对的列表。列表中未显式存储的所有块都假定为零,这意味着如果矩阵中有许多零块,我们可以节省大量内存。
下图演示了如何将一个 4x4 的稠密矩阵(左)转换为块大小为 2x2 的块 COO 格式(右)。注意在稀疏格式中,我们可以避免显式存储全部由零元素组成的右上角块。
我们将使用以下辅助函数来采样一个块稀疏矩阵。它返回一个用于检查结果的稠密矩阵,以及每个轴的块数据和索引列表。
def generate_block_sparse_mat(key, M, N, blk_M, blk_N, p=0.2, dtype=jnp.float32):
  """返回一个采样矩阵及其块稀疏表示。

  Args:
    key: RNG 密钥。
    M: 主数组维度。
    N: 次数组维度。
    blk_M: M 维度上的块大小。
    blk_N: N 维度上的块大小。
    p: 块为非零的概率。
    dtype: 采样矩阵的数据类型。

  Returns:
    dense_mat: 一个 (M, N) 的稠密采样数组。
    block_data: 一个 (num_blocks, blk_M, blk_N) 的数据块数组,表示矩阵的非零块。
    indices_i: 一个 (num_blocks,) 的第一轴块索引数组。
    indices_j: 一个 (num_blocks,) 的第二轴块索引数组。
  """
  mask_key, blocks_key = jax.random.split(key)
  num_blocks = (M // blk_M, N // blk_N)
  # 首先采样一个块掩码,表示哪些块是非零的。
  block_mask = jax.random.bernoulli(mask_key, p=p, shape=num_blocks)
  num_blocks = jnp.sum(block_mask)
  indices = jnp.where(block_mask)
  # 对于每个非零块,采样一个随机值块。
  block_data = jax.random.uniform(blocks_key,
                                  shape=(num_blocks, blk_M, blk_N),
                                  dtype=dtype)
  # 为了检查目的,创建稀疏矩阵的稠密版本。
  dense_mat = jnp.zeros((M, N), dtype=dtype)
  for blk in range(num_blocks):
    idx_i = indices[0][blk]
    idx_j = indices[1][blk]
    slice_i = slice(idx_i * blk_M, (idx_i + 1) * blk_M)
    slice_j = slice(idx_j * blk_N, (idx_j + 1) * blk_N)
    dense_mat = dense_mat.at[slice_i, slice_j].set(block_data[blk])
  return dense_mat, block_data, indices[0], indices[1]
示例:稀疏 @ 稠密矩阵乘法#
在我们的第一个示例中,我们将一个稀疏的左操作数矩阵与一个稠密的右操作数矩阵相乘,产生一个稠密的输出。
我们将用 2 个循环来构建内核 grid——外部循环遍历右操作数/输出的列,内部循环遍历左操作数的稀疏块。在每次内循环迭代中,我们从左操作数加载一个块,并使用收缩维度(K)的块索引在右操作数中查找对应的块。我们将两个块相乘并累加到正确的输出块中。一次外循环迭代将计算整列的结果,如下图所示:
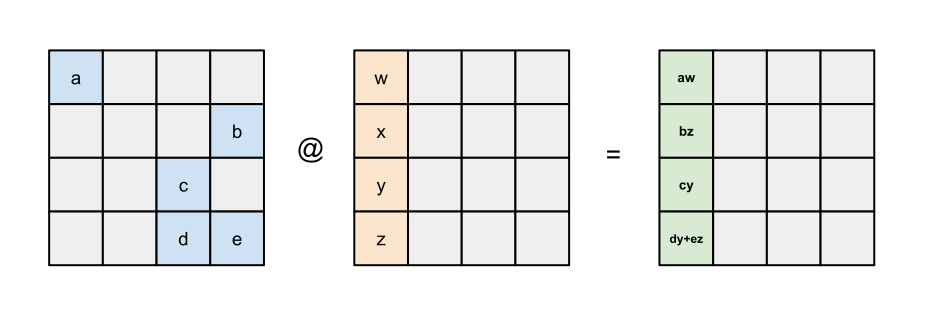
在将块索引传入内核之前,按行分组(例如 [0, 0, 1, 2, 3, 3])是很重要的,原因有两个。首先,在内核中我们需要知道何时初始化输出 ref 中的累加器为零,如果行索引是分组的,这很容易做到。其次,Pallas 的流水线逻辑不允许我们在非连续的迭代中重新访问输出 Ref 中的块,因此我们需要在连续的内核迭代中完成对一个输出块的所有累加。这是因为流水线发射器会意识到我们在连续迭代中加载相同的输出块并将该块保留在 VMEM 中。当我们切换输出块时,Pallas 将最终把输出存储到 HBM 中,并假设我们不再触碰它。未能连续访问输出块将导致不正确的值,即使内核在其他方面是逻辑正确的。
M = N = K = 16384
blk_M = blk_N = blk_K = 512


def dsd_kernel(idxs_i_ref, idxs_k_ref, # 标量预取输入。
               x_ref, y_ref, _, o_ref, # 内核输入。
               accum_scratch,
               ):
  """一个 DSD(稠密 = 稀疏 @ 稠密)矩阵乘法内核。"""
  del idxs_k_ref
  blk_idx = pl.program_id(1)
  is_start = blk_idx == 0
  changed_blocks = (idxs_i_ref[blk_idx] != idxs_i_ref[jnp.maximum(blk_idx-1, 0)])
  @pl.when(is_start | changed_blocks)
  def _():
    accum_scratch[...] = jnp.zeros_like(accum_scratch)
  accum_scratch[...] += jnp.dot(x_ref[0, :, :], y_ref[...], preferred_element_type=jnp.float32)

  next_block_change = (idxs_i_ref[blk_idx] != idxs_i_ref[jnp.minimum(blk_idx+1, num_blocks)])
  is_end = blk_idx == (num_blocks - 1)
  @pl.when(is_end | next_block_change)
  def _():
    o_ref[...] = accum_scratch[...].astype(o_ref.dtype)


def x_map(j, blk_idx, blk_idxs_i, blk_idxs_k):
  del j, blk_idxs_i, blk_idxs_k
  return (blk_idx, 0, 0)
def y_map(j, blk_idx, blk_idxs_i, blk_idxs_k):
  del blk_idxs_i
  return (blk_idxs_k[blk_idx], j)
def o_map(j, blk_idx, blk_idxs_i, blk_idxs_k):
  del blk_idxs_k
  return (blk_idxs_i[blk_idx], j)

(X_dense, X_blocks, indices_i, indices_k) = generate_block_sparse_mat(
    jax.random.key(0), M, K, blk_M, blk_K, p=0.1, dtype=jnp.bfloat16)
num_blocks = X_blocks.shape[0]
Y = jax.random.uniform(jax.random.key(1), shape=(K, N), dtype=jnp.bfloat16)
zeros = jnp.zeros((M, N), dtype=jnp.bfloat16)
out_shape = jax.ShapeDtypeStruct((M, N), dtype=jnp.bfloat16)

grid_spec = pltpu.PrefetchScalarGridSpec(
    num_scalar_prefetch=2,
    # 注意虽然 num_blocks 在这里是静态的,Pallas 确实支持动态 grid 大小。
    grid=(N // blk_N, num_blocks),
    in_specs=[pl.BlockSpec((1, blk_M, blk_K), x_map),
              pl.BlockSpec((blk_K, blk_N), y_map),
              # 用于 input_output_aliases 的零数组占位符。
              pl.BlockSpec((blk_M, blk_N), o_map),
              ],
    out_specs=pl.BlockSpec((blk_M, blk_N), o_map),
    scratch_shapes=[pltpu.VMEM((blk_M, blk_N), dtype=jnp.float32)]
)
kernel = pl.pallas_call(
  dsd_kernel,
  grid_spec=grid_spec,
  out_shape=out_shape,
  # 我们使用输入输出别名来将从未访问的块的 o_ref 清零。
  # 通过传入一个零数组,我们避免 o_ref 以未初始化的值开始。
  input_output_aliases={4: 0},  # 将 zeros 映射到 o_ref。
)
args = (indices_i, indices_k, X_blocks, Y, zeros)
result = kernel(*args)

ref = X_dense @ Y
diff = jnp.abs(ref - result)
print('mean |result - ref|:', jnp.mean(diff))
mean |result - ref|: 0我们可以做一个快速基准测试,将稀疏内核与 JAX 中的稠密矩阵乘法进行性能比较。在 TPU v5e 芯片上,与理论上稀疏因子带来的 10 倍加速相比,该内核实现了大约 ~6 倍的速度提升。
这里有一些提高性能的主要技巧,主要集中在减少 HBM/VMEM 之间的通信开销:
使用
dtype=jnp.bfloat16对性能至关重要,因为它将内存带宽减半。使用更大的块大小也有帮助,因为矩阵乘法是 $O(N^3)$ 计算和 $O(N^2)$ 内存操作。随着 $N$ 增大,内核变为计算受限。然而,实际中一个反面论点是,更小的块大小也使数据能够更稀疏,所以这是一个应该仔细选择的参数。
# 基准测试稀疏 Pallas 内核 vs 参考 JAX 实现

def benchmark(f, ntrials: int = 100):
  def run(*args, **kwargs):
    # 首先编译函数
    jax.block_until_ready(f(*args, **kwargs))
    # 计时函数
    result = timeit.timeit(lambda: jax.block_until_ready(f(*args, **kwargs)),
                           number=ntrials)
    time = result / ntrials
    return time
  return run


n_trials = 100

pallas_impl = lambda *args: kernel(*args)
time = benchmark(pallas_impl, n_trials)(indices_i, indices_k, X_blocks, Y, zeros)
print("Sparse Kernel: %.3f ms (avg over %d trials)" % (time * 1000, n_trials))

ref_impl = jax.jit(lambda x, y: x @ y)
time = benchmark(ref_impl, n_trials)(X_dense, Y)
print("Reference: %.3f ms (avg over %d trials)" % (time * 1000, n_trials))
Sparse Kernel: 8.136 ms (avg over 100 trials)
Reference: 46.953 ms (avg over 100 trials)稠密数据上的稀疏访问模式#
在之前的示例中,我们考虑了数据本身是稀疏的情况。这在内核结构中表现为内核 grid 中的一个维度是动态的,循环遍历非零块的数量(num_blocks)。
当底层数据是稠密的,但我们希望对其执行稀疏计算时,就出现了第二种有用的编程模式。在这种情况下,我们的内核 grid 是稠密的,但我们希望跳过 grid 中由块稀疏掩码指示的某些块。这种编程模式在许多机器学习应用中使用掩码时经常出现,例如自注意力中的因果掩码或局部掩码。在这些情况下,我们可以完全跳过掩码为零的块的计算。此编程模式的示例可以在 jax/experimental/pallas/ops/tpu 中的 Splash Attention 和分组矩阵乘法内核中找到,也可以在 PyTorch 的 FlexAttention 中找到。
处理稠密数据上的稀疏访问模式时,主要的性能考虑是与流水线的交互。在任何给定的内核迭代中,Pallas 流水线发射器将通过在 grid 的下一次迭代上为每个 BlockSpec 调用 index_map 来尝试预取下一个数据块。然而,如果我们的计算是稀疏的,我们可能会跳过 grid 中下一个块的计算,所以我们需要某种方法告诉流水线改为开始取 下一个未被跳过的块。为此,我们需要构建 预取映射,其中包含每个内核输入的下一个未跳过数据块的索引。下图说明了如何为以类似 COO 格式存储的块稀疏掩码构建预取映射。
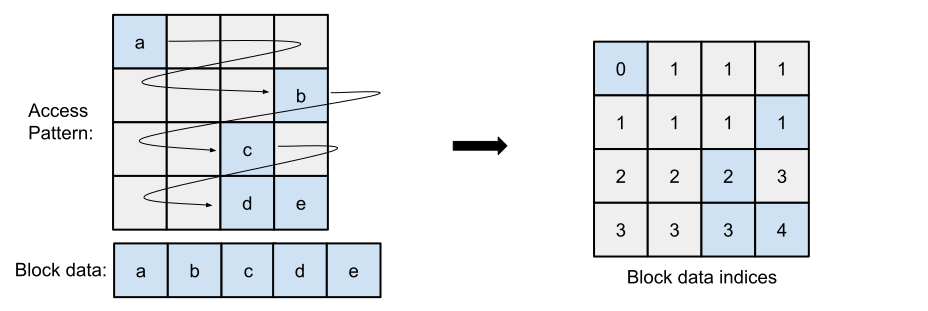
左:稀疏访问模式,蓝色表示我们需要计算的具有非零掩码的块。右:预取映射,数组的每个元素包含下一个非零块数据的索引。
一旦构建了预取映射,我们就可以将该映射作为标量预取参数传递,并在 BlockSpec 的 index_map 函数中查询它。
def mask_index_map(prefetch_map, i, j, ...):
  next_nonzero_block = prefetch_map[i, j]
  return (next_nonzero_block, 0, 0)
我们可以为内核的其他输入构建类似的索引映射。对于稠密输入,你很可能需要构建指向 grid 中下一个非零块索引的预取映射。我们的下一个示例将提供使用这些预取映射的例子。
示例:带块稀疏输出掩码的稠密 @ 稠密矩阵乘法#
在下一个示例中,我们将介绍使用预取映射改善流水线性能的稠密矩阵乘法融合稀疏输出掩码。我们将使用掩码选择性地跳过计算被置零的输出块,从而节省计算成本。
由于我们将使用稀疏掩码,我们将首先实现一个函数,将以稠密格式存储的 N x M 掩码转换为块稀疏格式。我们还需要计算预取映射来帮助流水线发射器知道下一步取哪个块。总的来说,我们的 sparsify_mask 函数计算:
一个形状为
(num_N_blocks, num_M_blocks)的block_mask,指示一个块是全零(值0)还是包含非零元素(值1)。如果block_mask的值为 0,我们可以在内核中跳过计算该块。一个形状为
(num_N_blocks, num_M_blocks)的prefetch_mask数组,由指向mask_data中下一个非零块的索引组成。一个形状为
(num_N_blocks, num_M_blocks)的prefetch_i数组,由掩码的下一个非掩码i索引组成。一个形状为
(num_N_blocks, num_M_blocks)的prefetch_j数组,由掩码的下一个非掩码j索引组成。一个形状为
(num_blocks, blk_N, blk_M)的mask_data数组,包含掩码非零块的数据。
def sparsify_mask(mask: jax.Array,
                  block_shape: tuple[int, int]):
  """将掩码预处理为稀疏表示。

  Args:
    mask: 形状为 [M, N] 的布尔数组
    block_shape: 单个块的大小。

  Returns:
    block_mask: 一个 block_shape 的布尔数组,指示块是全零 (0) 还是包含非零元素 (1)。
    prefetch_mask: 一个 block_shape 的整数数组,指示下一个非零块的索引。
    mask_data: 一个 (num_blocks, block_shape) 数组,包含掩码非零块的数据。
  """
  M, N = mask.shape
  bm, bn = block_shape

  block_mask = jnp.zeros((M // bm, N // bn), dtype=mask.dtype)
  mask_types_finder = []
  mask_data = []

  next_mask_type_idx = 0
  prefetch_mask = jnp.zeros_like(block_mask)
  next_i = (M // bm) - 1
  next_j = (N // bn) - 1
  prefetch_i = jnp.zeros_like(block_mask)
  prefetch_j = jnp.zeros_like(block_mask)
  for i in range(M // bm, -1, -1):
    for j in range(N // bn, -1, -1):
      mask_block = mask[i * bm :(i + 1) * bm,
                        j * bn :(j + 1) * bn]
      is_nonzero = jnp.any(mask_block)
      if is_nonzero:
        try:
          type_index = mask_types_finder.index(str(mask_block))
        except ValueError:
          type_index = len(mask_types_finder)
          mask_types_finder.append(str(mask_block))
          mask_data.append(mask_block)
        next_mask_type_idx = type_index
        next_i = i
        next_j = j
      else:
        type_index = -1
      block_mask = block_mask.at[i, j].set(is_nonzero)
      prefetch_mask = prefetch_mask.at[i, j].set(next_mask_type_idx)
      prefetch_i = prefetch_i.at[i, j].set(next_i)
      prefetch_j = prefetch_j.at[i, j].set(next_j)
  return block_mask, prefetch_mask, prefetch_i, prefetch_j, jnp.stack(mask_data)
在内核结构方面,我们使用与之前教程中介绍的标准矩阵乘法内核相同的 grid 模式,在 N、M 和 K 维度上有 3 个循环。在内核内部,我们首先检查 block_mask 以查看当前输出块的掩码是否全为零。如果掩码全为零,我们可以跳过计算并继续下一个块;否则我们需要计算矩阵乘法然后对结果应用掩码。
M = N = K = 16384
blk_M = blk_N = 512
blk_K = 1024

def sparse_mask_matmul(
    block_mask_ref, prefetch_mask, prefetch_i, prefetch_j, # 标量预取输入。
    x_ref, y_ref, mask_ref, o_ref,  # 内核输入。
    accum_scratch
    ):
  del prefetch_mask, prefetch_i, prefetch_j
  i, j, k = pl.program_id(0), pl.program_id(1), pl.program_id(2)
  should_compute = block_mask_ref[i, j] != 0
  @pl.when(k == 0)
  def _():
    o_ref[...] = jnp.zeros_like(o_ref)
    accum_scratch[...] = jnp.zeros_like(accum_scratch[...])

  # 我们只为具有非零掩码的块计算输出。
  # 否则我们完全跳过计算。
  @pl.when(should_compute)
  def _():
    result = jnp.dot(x_ref[...], y_ref[...], preferred_element_type=jnp.float32)
    accum_scratch[...] += result
    @pl.when(k == pl.num_programs(2) - 1)
    def _():
      o_ref[...] = (mask_ref[0, ...] * accum_scratch[...]).astype(o_ref.dtype)

X = jax.random.normal(jax.random.key(0), shape=(M, K), dtype=jnp.bfloat16)
Y = jax.random.normal(jax.random.key(1), shape=(K, N), dtype=jnp.bfloat16)
mask = jnp.ones((M, N), dtype=jnp.int32)
mask = jnp.tril(mask)
block_mask, prefetch_mask, prefetch_i, prefetch_j, sparse_mask_data = sparsify_mask(mask, (blk_M, blk_N))

def x_map(i, j, k, block_mask, prefetch_mask, prefetch_i, prefetch_j):
  del prefetch_mask, prefetch_j
  # 如果掩码为零,将 k 索引置零,以避免在内循环中
  # 不断为要跳过的块获取新块。
  k_fetch = (block_mask[i, j] != 0) * k
  return (prefetch_i[i, j], k_fetch)

def y_map(i, j, k, block_mask, prefetch_mask, prefetch_i, prefetch_j):
  del prefetch_mask, prefetch_i
  k_fetch = (block_mask[i, j] != 0) * k
  return (k_fetch, prefetch_j[i, j])

def mask_map(i, j, k, block_mask, prefetch_mask, *_):
  del k, block_mask
  return (prefetch_mask[i, j], 0, 0)

def o_map(i, j, k, *_):
  del k
  return (i, j)

grid_spec = pltpu.PrefetchScalarGridSpec(
    num_scalar_prefetch=4,
    grid=(M // blk_M, N // blk_N, K // blk_K),
    in_specs=[pl.BlockSpec((blk_M, blk_K), x_map),
              pl.BlockSpec((blk_K, blk_N), y_map),
              pl.BlockSpec((1, blk_M, blk_N), mask_map)],
    out_specs=pl.BlockSpec((blk_M, blk_N), o_map),
    scratch_shapes=[pltpu.VMEM((blk_M, blk_N), dtype=jnp.float32)]
)
kernel = pl.pallas_call(
  sparse_mask_matmul,
  grid_spec=grid_spec,
  out_shape=jax.ShapeDtypeStruct((M, N), jnp.bfloat16),
)
args = (block_mask, prefetch_mask, prefetch_i, prefetch_j, X, Y, sparse_mask_data)
result = kernel(*args)

ref = mask * (X @ Y)
diff = jnp.abs(ref - result)
print('mean |result - ref|:', jnp.mean(diff))
mean |result - ref|: 1.0252e-05现在让我们将性能与朴素的稠密实现进行比较。在 TPU v5e 上,使用稀疏内核我们实现了大约 ~1.8 倍的速度提升,而使用下三角掩码只访问一半可能输出的理论最佳情况是 2 倍。
我们通常期望随着输入变大,性能更接近理论峰值,因为我们没有完全达到理论性能的几个主要原因是:
我们跳过的计算略少于一半,因为对角线上的块是 0 和 1 的混合,对于混合块我们需要计算整个块。输入越大,混合块的开销相对于整体计算就越小。
流水线气泡在整体运行时间中所占的百分比也随着输入变大而减小。
n_trials = 100

pallas_impl = lambda *args: kernel(*args)
time = benchmark(pallas_impl, n_trials)(block_mask, prefetch_mask, prefetch_i, prefetch_j, X, Y, sparse_mask_data)
print("Sparse Kernel: %.3f ms (avg over %d trials)" % (time * 1000, n_trials))

ref_impl = jax.jit(lambda mask, x, y: mask * (x @ y))
time = benchmark(ref_impl, n_trials)(mask, X, Y)
print("Reference: %.3f ms (avg over %d trials)" % (time * 1000, n_trials))
Sparse Kernel: 28.648 ms (avg over 100 trials)
Reference: 49.988 ms (avg over 100 trials)