TPU 流水线#
本指南作为 TPU 特定流水线问题的参考。我们将回顾 TPU 上的内存层次结构和计算单元,以及流水线 API 的 TPU 特定功能。有关流水线的更通用概述,请参见 软件流水线。
#@title 导入
import jax
from jax.experimental import pallas as pl
from jax.experimental.pallas import tpu as pltpu
import jax.numpy as jnp
import numpy as np
TPU 及其内存空间#
TPU 及其 TensorCore 由内存空间(数组可以驻留的地方)、寄存器(临时存储标量和数组值)和计算单元(使用寄存器中的值进行计算)组成。下图是一个 TPU 的示意图,其中 x 和 y 是驻留在高带宽内存(HBM)中的数组:
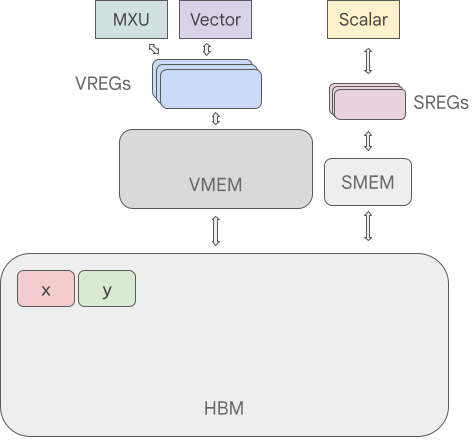
让我们更详细地讨论此图的组成部分:
内存空间:TPU 拥有高带宽内存(HBM),这就是我们通常所说的"设备内存"。还有向量内存(VMEM),一种用于存储向量和数组值的缓存,以及标量内存(SMEM),一种设计用于存储标量值的缓存。
寄存器:TensorCore 有两种主要类型的寄存器:向量寄存器(VREGs)存储数组值,标量寄存器(SREGs)存储标量值。值可以从各自的缓存加载到内存中(VMEM 用于 VREGs,SMEM 用于 SREGs)。
计算单元:TensorCore 有一个标量单元、向量单元(VPU)和矩阵单元(MXU),可以进行数值计算。每个计算单元都可以异步操作,但这由 TPU 编译器管理,因此从程序员的角度来看,TPU 程序是单线程的。计算单元对驻留在 SREGs 和 VREGs 中的值进行操作,并将输出值也存储到这些寄存器中。
TPU 特定的流水线功能#
Pallas TPU 支持以下平台特定功能。
TPU 内存空间#
Pallas 向用户暴露了 TPU 内存层次结构的所有级别。下表将 Pallas TPU 内存空间映射到其标准内存类型(DRAM/SRAM):
| Pallas 枚举 | TPU 内存空间 | 类型(DRAM/SRAM) |
|---|---|---|
pl.ANY | HBM(通常)或 VMEM | DRAM |
pltpu.VMEM | VMEM | SRAM |
pltpu.SMEM | SMEM | SRAM |
pltpu.SEMAPHORE | 信号量 | SRAM |
MemorySpace.VMEM表示向量 SRAM。如果没有指定任何内容,它是默认的内存空间。MemorySpace.SMEM表示标量 SRAM。只能对 SMEM 执行标量加载和存储。MemorySpace.ANY是对编译器的提示,表示内存空间不受约束。在大多数情况下,XLA 会将此缓冲区放置在 HBM 中。分配给ANY内存空间的缓冲区不能使用数组索引语法(例如x[...])正常解引用。相反,我们必须首先使用pltpu.sync_copy或pltpu.async_copy将值复制到 VMEM 或 SMEM 缓冲区中。MemorySpace.SEMAPHORE用于分配信号量,以构建屏障或跟踪异步操作。也可以从内核返回信号量以构建异步内核——这是一个实验性功能;更多详情请参见 Pallas 异步操作。
TPU 上的流水线通常在 HBM(DRAM)和 VMEM(向量 SRAM)之间进行。pallas_call 在 TPU 上的默认行为是假定 pallas_call 的参数驻留在 HBM 中,而用户内核体的输入存储在 VMEM 中。
虽然不是流水线特有的,但可以通过在 BlockSpec 上指定 memory_space 参数来手动控制输入和输出缓冲区的内存空间。注意,除非 memory_space 被标记为 VMEM,否则不允许流水线。内存空间也可以通过 pallas_call 上的 scratch_shapes 参数来指定内核的临时缓冲区参数。临时缓冲区在内核迭代之间是持久的,对于存储中间结果(如部分累加和归约)很有用。临时缓冲区必须驻留在 VMEM、SMEM 或 SEMAPHORE 中。
作为在内核中使用多个手动内存空间分配的示例,以下程序将 HBM 缓冲区 x_hbm_ref 的一个切片复制到临时 VMEM 缓冲区 scratch_vmem_ref 中,然后将其用于算术运算并将结果存储到输出 VMEM 缓冲区中:
def hbm_vmem_kernel(x_hbm_ref, out_vmem_ref, scratch_vmem_ref):
    pltpu.sync_copy(x_hbm_ref.at[0:1], scratch_vmem_ref)
    out_vmem_ref[...] = scratch_vmem_ref[...] + 1

x = jax.random.uniform(jax.random.key(0), (8, 128), jnp.float32)
out = pl.pallas_call(hbm_vmem_kernel,
    in_specs=[pl.BlockSpec(memory_space=pl.ANY)],
    out_shape=jax.ShapeDtypeStruct((1, 128), jnp.float32),
    scratch_shapes=(pltpu.VMEM(shape=(1, 128), dtype=jnp.float32),)
)(x)

np.testing.assert_allclose(out, x[0:1] + 1)多重缓冲#
可以通过 pl.BlockSpec 上的 pipeline_mode 选项,在每个参数的基础上为流水线指定多重缓冲。为此,向 pl.BlockSpec 传递一个 pl.Buffered 对象,指定为此特定参数分配的缓冲区数量:
pl.BlockSpec(
    pipeline_mode=pl.Buffered(buffer_count=buffer_count)
)
所有输入和输出的默认缓冲区数量为 2。
pltpu.emit_pipeline#
pltpu.emit_pipeline 是在 Pallas 中实现的流水线 API,允许你在内核内部构建流水线,而不仅仅是在内核入口处。与使用 pl.pallas_call 相比,它有以下几个用途:
用于构建嵌套流水线。例如,一个在芯片之间通信的外部流水线和一个执行 HBM-VMEM 流水线的内部流水线。
用于使用
emit_pipeline特有的功能,如前瞻预取和动态块形状(下面介绍)。
pltpu.emit_pipeline 遵循与 pl.pallas_call 类似的签名,要求你指定一个 kernel 函数体、一个 grid,以及输入和输出的块规范:
def emit_pipeline(
    kernel: Callable,
    grid: tuple[int],
    in_specs: PyTree[BlockSpec] = None,
    out_specs: PyTree[BlockSpec] = None,
    dimension_semantics: tuple[GridDimensionSemantics] = None,
    core_axis: int | None = None,
) -> Callable:
    ...  # 根据内部内核和 BlockSpec 返回自定义流水线。
dimension_semantics 和 core_axis 参数用于在 Megacore 上对内核 grid 进行分区(见下文)。
前瞻预取#
前瞻预取是一种流水线功能,流水线会在缓冲槽可用时立即尝试预取下一个输入块,而不是在使用前的直接前一个迭代才预取。例如,如果内核的 grid 为 (8,),每次迭代要取的块索引为 0, 0, 0, 0, 1, 1, 1, 1,那么前瞻预取将在迭代 0 时开始取块 0 和 1,而标准流水线调度会在迭代 0 取块 0,但直到迭代 3 才开始取块 1。执行前瞻有少量控制流开销,因此默认情况下是禁用的。
前瞻主要在每个块中有可变数量的计算工作时有用,例如当某些块包含被跳过或减少数量的工作时。在这些情况下,在需要该块的步骤之前的迭代中可能没有足够的计算工作来完全重叠内存传输。因此,我们希望在流水线的更早阶段开始取块。
前瞻预取可以与多重缓冲结合使用,同样可以通过向 pipeline_mode 参数传递 pl.Buffered 来启用:
pl.BlockSpec(
    pipeline_mode=pl.Buffered(buffer_count=buffer_count, use_lookahead=True)
)动态块形状#
pltpu.emit_pipeline 支持对具有动态但有界形状的块进行流水线。为了指定这样的块形状,块中动态大小的维度应该用 pl.BoundedSlice(max_size) 标记,而不是静态整数大小,其中 max_size 是块的最大大小。此外,index_map 返回的相应索引应该是通过 pl.ds(start, size) 构建的动态切片,其中 start 和 size 都是 元素 索引(不是块索引),并且可以是动态的。
以下是一个具有动态第一维的块规范示例:
pl.BlockSpec(
    block_shape=(pl.BoundedSlice(32), 256),
    index_map=lambda *grid_idxs: (pl.ds(start, end), 0),
)
# 以下内核通过 `slices` 传入的动态大小块将 `x` 复制到输出。
def dynamic_block_example_kernel(x_hbm, slices_hbm, o_hbm, slices_smem):
pltpu.sync_copy(slices_hbm, slices_smem) # 将切片复制到 SMEM。
def pipeline_body(x_vmem, o_vmem):
o_vmem[...] = x_vmem[...]
def index_map(i):
start = slices_smem[i, 0]
size = slices_smem[i, 1] - slices_smem[i, 0]
return (pl.ds(start, size), 0)
block_spec = pl.BlockSpec(block_shape=(pl.BoundedSlice(8), 128),
index_map=index_map)
pltpu.emit_pipeline(
pipeline_body,
grid=(slices.shape[0],),
in_specs=[block_spec],
out_specs=block_spec
)(x_hbm, o_hbm)
x = jax.random.uniform(jax.random.key(0), (8, 128), jnp.float32)
slices = jnp.array([[0, 2], [2, 3], [3, 5], [5, 8]], dtype=jnp.int32)
hbm_block_spec = pl.BlockSpec(memory_space=pl.ANY)
out = pl.pallas_call(dynamic_block_example_kernel,
in_specs=[hbm_block_spec, hbm_block_spec],
out_specs=hbm_block_spec,
out_shape=jax.ShapeDtypeStruct((8, 128), jnp.float32),
scratch_shapes=(pltpu.SMEM(slices.shape, jnp.int32),)
)(x, slices)
np.testing.assert_allclose(x, out)Megacore 配置下的 TPU#
某些 TPU 芯片有两个 TensorCore,但对 JAX 用户来说表现为一个设备。这被称为"megacore"。独立的 TensorCore 拥有各自独立的 VMEM、VREGs、SMEM、SREGs 和计算单元,但 共享 HBM。
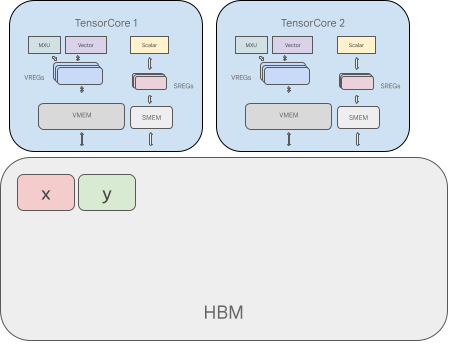
从概念上讲,Megacore 中的 TPU 表现得像非常简单的 GPU,即它们只有两个线程。我们如何修改内核以同时利用两个 TensorCore?
基本思路是,如果我们的计算中有令人尴尬地并行(embarrassingly parallel)的维度,我们可以将这些维度分配到各个 TensorCore 上。我们可以通过向 pallas_call 提供一个名为 dimension_semantics 的标注来指示哪些维度是可并行化的。
def add_matrices_kernel(x_vmem_ref, y_vmem_ref, z_vmem_ref):
    # 从 VMEM 将 x 和 y 加载到 VREGs
    x_vregs = x_vmem_ref[:, :]
    y_vregs = y_vmem_ref[:, :]
    # 执行向量化加法
    z_vregs = x_vregs + y_vregs
    # 将 VREGs 中的输出值存储回 VMEM
    z_vmem_ref[:, :] = z_vregs

def add_matrices_pipelined_megacore(x: jax.Array, y: jax.Array) -> jax.Array:
    block_spec = pl.BlockSpec((256, 512), lambda i: (i, 0))
    return pl.pallas_call(
        add_matrices_kernel,
        out_shape=jax.ShapeDtypeStruct(x.shape, x.dtype),
        in_specs=[block_spec, block_spec],
        out_specs=block_spec,
        grid=(2,),
        compiler_params=pltpu.CompilerParams(
            dimension_semantics=("parallel",))
    )(x, y)

x, y = jnp.ones((512, 512)), jnp.ones((512, 512))
add_matrices_pipelined_megacore(x, y)
Array([[2., 2., 2., ..., 2., 2., 2.],
[2., 2., 2., ..., 2., 2., 2.],
[2., 2., 2., ..., 2., 2., 2.],
...,
[2., 2., 2., ..., 2., 2., 2.],
[2., 2., 2., ..., 2., 2., 2.],
[2., 2., 2., ..., 2., 2., 2.]], dtype=float32)dimension_semantics 应该是一个与 grid 长度相同的元组,其中每个条目是 "parallel" 或 "arbitrary"。"parallel" 向 Pallas 表示该维度对应的 for 循环的迭代可以独立执行而不影响程序的正确性。"arbitrary" 向 Pallas 表示对该 grid 维度不能做任何假设,因此不能并行化。
通过指定 dimension_semantics,我们现在可以在每个 TensorCore 上同时执行内核。Pallas 将自动处理 grid 的分割。
注意,Megacore 目前仅在 TPU
v4和 TPUv5p上可用。在其他平台上提供dimension_semantics标注是空操作,但 不 指定它将导致只使用一个 TensorCore(即使有多个可用)。
使用 pltpu.emit_pipeline 时,应将 core_axis 传递给 emit_pipeline。core_axis 应该是一个并行 grid 轴的索引,用于在该轴上分区 grid。例如,以下模板可用于在前导并行 grid 维度上分区内核:
def kernel_body(...):
    def inner_pipeline_body(...):
        ...
    pltpu.emit_pipeline(inner_pipeline_body,
                        grid=(4, 4),
                        core_axis=0,
                        dimension_semantics=("parallel", "sequential"))

pl.pallas_call(
    kernel_body,
    grid=(num_cores,),
    compiler_params=pltpu.CompilerParams(
        dimension_semantics=("parallel",))
)