Pallas 设计#
本文档阐述了 Pallas 的初始设计。这是早期设计决策的一个快照,Pallas 的具体 API 可能已在此后发生变化。
引言#
JAX 被广泛用于多种工作负载,从大规模机器学习到科学计算。JAX 的成功同时也是 XLA 的成功——XLA 是 JAX 的主要编译器后端,它将 JAX 程序编译到加速器上运行,使 JAX 能够扩展到最大规模的 ML 模型。JAX 使用 XLA 的表示格式 HLO 来描述逻辑计算。HLO 描述的是计算在逻辑层面上如何进行,而非物理层面。给定一个逻辑 HLO 计算,XLA 决定该计算在物理层面如何执行。对于大多数 ML 应用,XLA 在编译用户程序方面做得很好,但不可避免地有些用户会遇到 XLA 的局限性。在这些情况下,我们需要提供一个"逃生舱口"(escape hatch),让专家能够编写在当前时间点上超越 XLA 性能的手工调优 kernel。此外,ML 系统研究的进展需要一定时间才能被纳入 XLA,用户往往希望提前使用这些新技术。随着时间推移,编译器可以吸收那些通过手工调优 kernel 实验验证过的优化方案。
XLA 确实提供了 CustomCall 机制作为逃生舱口,但它要求用户编写 C++,在 GPU 上还需要用户学习 CUDA 编程模型。对于许多机器学习 GPU kernel(如矩阵乘法),CUDA 编程模型可以说过于底层,即使是专家用户也难以用 CUDA 实现高效的矩阵乘法或多头注意力。不仅如此,JAX 用户通常熟悉 Python 和 NumPy 风格的数组编程,无需编写任何 C++ 或考虑 GPU 并行性。所有主流机器学习框架都秉持这一理念:用 matmul 或 convolution 等高级操作来处理(通常是)数组。不幸的是,这意味着通过 CustomCall 实现自定义操作是一项很大的投入,可能需要学习 C++ 和/或 GPU 编程。
Triton 是由 OpenAI 构建和维护的 GPU 编译器,已在 ML 编译器领域引起轰动。Triton 提供了两全其美的方案:一种面向 GPU kernel 的基于数组的编程模型。Triton 是 PyTorch 2.0 中 torch.compile 的主要代码生成路径,通过 Torch Inductor 库实现。Triton 刻意隐藏了 GPU 编程的某些方面,以提供一种更易用的编程模型,用户可以在 Python 中使用,并从更高层的表示生成优化代码。虽然 GPU 比 Triton 所能表达的更为灵活,但在 ML 领域,Triton 对于大多数应用来说已经足够有表达力。
本文档描述了 Pallas——JAX 的一个扩展,使用类 Triton 模型为 GPU 和 TPU 提供 kernel 编程能力。基于 JAX 的 kernel 语言有以下几个优势:
虽然 Triton 向用户暴露了类似 TPU 的编程模型(即针对 L1-cache 中的数组 tile 编写程序),但它在 GPU 上足够特化,使得我们无法直接将 Triton 编译到 TPU。例如,Triton 提供了专门处理并行写入的原子操作,这在 TPU 上不一定有意义。一个更高层的前端可以抽象掉平台的细节,只暴露基于 tile 的编程模型。因此 kernel 可以在不同硬件平台之间移植。
JAX 作为基于 tracing 的数值计算前端,既成熟又广泛使用。通过将 kernel 编程语言嵌入 JAX 本身,我们可以复用 JAX 的 tracing 基础设施,并提供用户已经熟悉的类 NumPy 前端。
JAX 变换是其成功的关键,允许用户编写简单程序并通过变换实现复杂功能。我们可以利用相同的变换(vmap、jvp 等)来变换用户编写的 kernel。
一个开放问题是:JAX 是否适合作为 kernel 语言?我们认为是的。Triton 已经证明了数组编程语言可以实际用于编写 GPU kernel,而 JAX 正是这样一种语言。JAX 也已被证明是编译器和程序变换的灵活前端。
我们按以下方式描述 Pallas:首先描述我们扩展 JAX 以支持自定义 kernel 编写的方式,然后展示如何将 Pallas 降低(lower)到 Triton 和 Mosaic,最后描述通过 JAX 变换来变换 Pallas kernel 的现有方式和潜在方式。
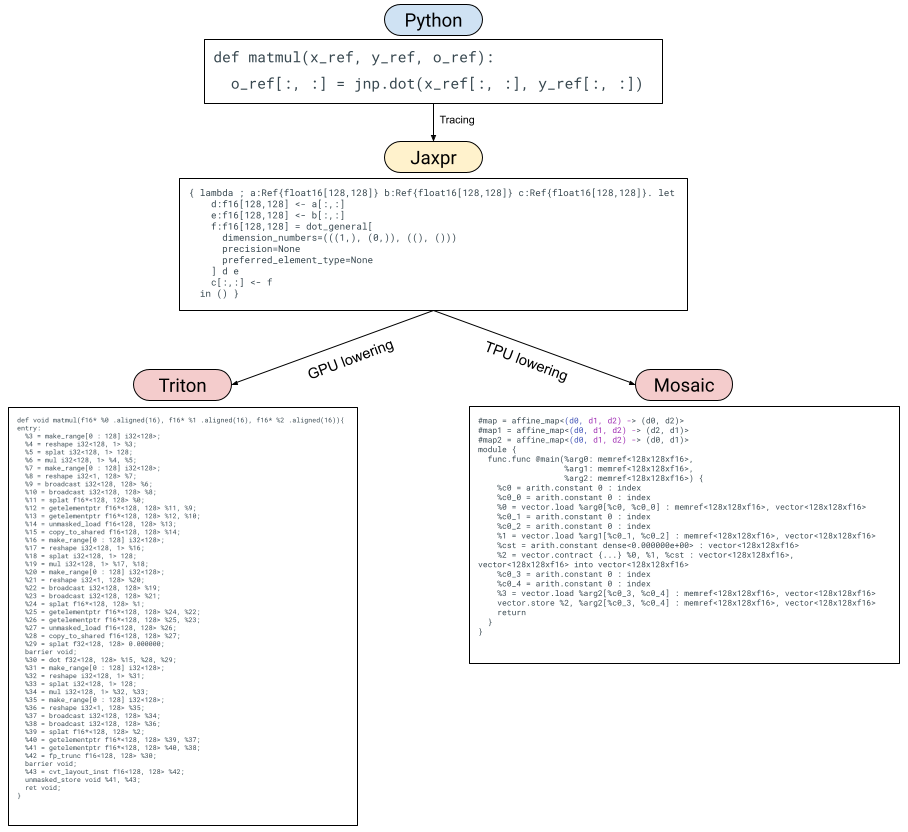
Pallas: 为 kernel 扩展 JAX#
我们要强调的关键点是:Pallas 就是 JAX,只是增加了一些扩展:
用户现在可以在 JAX 代码中使用名为
Ref的引用类型。这使用户能更精确地控制内存访问,JAX 中的 layout 将更接近物理 layout。用户使用 JAX 原语的一个子集以及一组 Pallas 专有原语来编写 JAX 程序。
用户通过一个特殊的
pallas_call高阶函数将 Pallas kernel 嵌入到外层 JAX 程序中,该函数在一个 map 中执行 kernel。它类似于pmap或shard_map,但使用的是共享内存的引用。
我们将逐一通过示例介绍这三个扩展。
注意这些 API 仍处于实验阶段,可能会发生变化。
引用类型#
让我们看一个 Pallas 程序示例——两个向量相加:
import jax
import jax.numpy as jnp
from jax.experimental import pallas as pl

def add_kernel(x_ref, y_ref, o_ref):
  # 在此代码中,`x_ref`、`y_ref` 和 `o_ref` 是 (8,) 形状的 `Ref`
  x = x_ref[:]
  y = y_ref[:]
  o_ref[:] = x + y
x, y = jnp.arange(8), jnp.arange(8, 16)
add = pl.pallas_call(add_kernel, out_shape=jax.ShapeDtypeStruct((8,), jnp.int32))
add(x, y)
与常规 JAX 程序不同,add_kernel 接收的不是不可变的数组参数,而是可以使用类 NumPy 语法进行读取和就地更新的引用。Ref 不是 Pallas 专有的概念——它们被引入 JAX 是为了表示有状态的计算。不过,我们也可以在编写操作可变内存的 kernel 时利用它们。
Pallas kernel 不仅接收对应于 kernel 输入的 Ref,还接收对应于输出的 Ref(在 pallas_call 中通过 out_shape 指定)。Ref 是特殊类型,不能在未先读取的情况下传递给常规的 JAX 原语。当你从 Ref 读取时,会得到一个 JAX Array 类型;你必须将一个 Array 写入 Ref。
读取/写入 Ref#
从 Ref 读取对应于将数组加载到内存层次结构的最低层(GPU 上是 L1-cache,TPU 上是向量寄存器)。写入 Ref 类似。
def f(x_ref, o_ref):
  # 使用原生 Python 索引
  x = x_ref[0, 2:5, :]
  # 或者通过 NumPy 高级整数索引
  o_ref[jnp.arange(3), :] = x

# 注意要使用 NumPy 高级整数索引时,需要将索引互相广播到所需的多维形状:
def f(x_ref):
  # 假设 x_ref 形状为 (8, 4),我们想读取一个 (2, 3) 的切片
  x = x_ref[jnp.arange(2)[..., None], jnp.arange(3)[None, ...]]
写入 Ref 可以通过类似的 __setitem__ 风格的索引完成。
其他形式的索引(例如动态切片)可以通过 pallas.load 和 pallas.store 完成,这是为了简化内存读写而设计的新 JAX 原语。我们将在后面讨论这些新原语。
用新的 Pallas 原语扩展 JAX#
由于 JAX 在设计时以 HLO 为目标,JAX 原语集合与 HLO 操作集合紧密对应。面向新的编译器(如 Triton 或 Mosaic)意味着我们可能需要用新编译器特有的原语来补充 JAX 原语。同时,我们可能无法降低所有 JAX 原语,因此需要限制在一个子集内。
因为 Pallas 最初是以 Triton 为目标设计的,我们提供了一组面向 Triton 编程模型的新原语。如后文所示,我们也可以将这些原语降低到 Mosaic。
pallas.load 和 pallas.store#
pallas.load 和 pallas.store 是允许从内存加载和向内存存储的原语。与 __getitem__ 和 __setitem__ 不同,它们更灵活但也更冗长。具体来说,你可以使用 pallas.dynamic_slice(简写为 pallas.ds)构造(它或许应该被上游合入 JAX,用于 Ref 的 __getitem__ 和 __setitem__)。
def f(x_ref, o_ref):
  # 通过 pallas.load 从内存读取
  x = pl.load(x_ref, (0, slice(2, 5), slice(None)))
  # 使用整数索引会自动广播
  x = pl.load(x_ref, (0, 2 + jnp.arange(3), slice(None)))
  # 也可以使用 `pl.dynamic_slice`(简写为 `pl.ds`)对象
  pl.store(o_ref, (0, pl.ds(start=2, size=3), slice(None)), x)
pallas.load 和 pallas.store 还通过 mask 参数支持掩码。
def f(x_ref, o_ref):
  # 通过 pallas.load 从内存读取
  idx = jnp.arange(8)
  mask = idx < 5
  x = pl.load(x_ref, (idx,), mask=mask, other=float('-inf'))
掩码在进行越界加载/存储时非常重要。掩码的操作语义可以由编译器确定(据我们对文档的理解,Triton 在被掩码时会避免内存读/写)。
pallas.program_id 和 pallas.num_programs#
我们很快会看到,同一个 Pallas kernel 会被执行多次(根据后端不同,可以是并行执行或以流水线方式执行)。这些新原语告诉我们在 kernel 执行中当前处于"什么位置"。
pallas.program_id 接受一个 axis 参数,告诉我们当前 kernel 在多维 grid 的某个轴上执行的索引(类似于 CUDA 编程中的 threadId 或 jax.pmap 中的 lax.axis_index)。注意我们目前借用了 Triton 的"program"术语,将来可能会改为 JAX 用户更熟悉的名称。
def f(x_ref, o_ref):
  i = pl.program_id(axis=0)  # grid 第一个轴上的执行索引
  o_ref[i] = jnp.exp(x_ref[i])
pallas.num_programs 同样接受一个 axis 参数,返回该轴上的 grid 大小。
注意虽然 program_id 和 num_programs 是 Triton 特有的术语,但它们很容易泛化以在 TPU 上同样适用。
在 Pallas 中使用 JAX 原语子集#
因为我们编写的是 kernel 而非高级 HLO 程序,某些 JAX 原语可能无法在底层基础设施中高效表示。不过,我们知道可以支持大多数逐元素操作、简单点积和 JAX 控制流。
虽然我们尚未完全列出 Pallas kernel 中可以支持的所有 JAX 原语,但可以明确一些难以降低或不太有用的原语:
conv_general—— 卷积通常不作为底层硬件中的原语提供。gather/scatter—— 底层编译器可能不支持非连续的内存读写。
使用 pallas_call 执行 Pallas kernel#
现在我们已经编写了 Pallas kernel(即带有 Ref 和额外 Pallas 原语的 JAX 程序),如何在 GPU 或 TPU 上执行它们呢?我们使用 pallas_call,一个高阶函数(类似于 jax.jit 和 jax.pmap),用于执行 kernel。
pallas_call 的签名如下:
def pallas_call(
    kernel: Callable,
    out_shape: Sequence[jax.ShapeDtypeStruct],
    *,
    in_specs: Sequence[Spec],
    out_specs: Sequence[Spec],
    grid: Optional[Tuple[int, ...]] = None) -> Callable:
  ...
当我们向 pallas_call 提供 kernel 时,还需要提供额外信息。首先是 out_shape,它告诉 kernel 输出的形状(pallas_call 会传入一个对应的 Ref 供 kernel 写入)。其余信息(in_specs、out_specs 和 grid)是关于 kernel 将如何在加速器上被调度的信息。
pallas_call 的(粗略)语义如下:
def pallas_call(kernel, out_shape, *, in_specs, out_specs, grid):
  def execute(*args):
    outputs = map(empty_ref, out_shape)
    grid_indices = map(range, grid)
    for indices in itertools.product(*grid_indices): # 可以并行运行!
      local_inputs = [in_spec.transform(arg, indices) for arg, in_spec in
                      zip(args, in_specs)]
      local_outputs = [out_spec.transform(arg, indices) for arg, out_spec  in
                       zip(outputs, out_specs)]
      kernel(*local_inputs, *local_outputs) # 写入 outputs
return execute具体来说,pallas_call 会"循环"遍历 grid 迭代空间,根据 in_specs 和 out_specs 对输入和输出施加变换。在每次迭代中,kernel 会在变换后的输入和输出上被调用。注意对迭代空间的"循环"可以并行执行(例如在 GPU 上)。pallas_call 不保证循环迭代的顺序,只保证迭代空间中的每个成员都会被遍历。Triton 和 Mosaic 等编译器会有与 grid 关联的更具体的操作语义。
变换函数#
pallas_call 的 in_specs 和 out_specs 参数允许以某种方式变换输入和输出。Pallas 目前提供两种选择:恒等变换(输入输出保持不变)和 BlockSpec(根据循环索引取 Ref 的固定大小切片)。
BlockSpec 接受一个 index_map 函数和一个 block_shape。从逻辑上讲,它将数组沿每个轴切分为 block_shape 大小的块。index_map 函数接受循环索引(来自 grid 索引集)并将其映射为块索引。变换函数将 Ref 转换为对应块位置处 Ref 的逻辑视图。当我们在 block_shape 的某个条目中指定 None 时,对应于在该维度上"映射"(mapping),在 kernel 内部移除该维度。
class BlockSpec:
  index_map: Callable[[Tuple[Int, ...]], Tuple[Int, ...]]
  block_shape: Tuple[Optional[int], ...]

  def transform(self, ref, *loop_indices):
    block_indices = self.transform_function(loop_indices)
    # 返回从 `block_indices` 开始、形状为 self.block_shape 的 `ref` 视图
    ...
我们还可以想象与 pallas_call 一起使用的其他 Spec,例如一个对应于重叠窗口的 Spec,用来实现卷积。
Pallas 作为前端的直接收益#
通过提供基于 JAX 的 kernel 编写前端,我们可以立即获得一些收益。
更灵活的前端#
首先,JAX 用户已经习惯了使用 JAX 及其基于 tracing 的变换进行编程的优势(和局限性)。这意味着用户在编写 Pallas kernel 时可以使用闭包和其他熟悉的 Python 结构。这不同于现有的基于 AST 解析的 Triton 前端或 Mosaic 的 MLIR builder。例如,这使得 Pallas 比 Triton 更适合模板化。
下面是使用 Python 高阶函数对 kernel 进行模板化的示例:
def make_kernel(eltwise_kernel):
  def add(x_ref, y_ref, o_ref):
    x = pl.load(x_ref, ())
    y = pl.load(y_ref, ())
    pl.store(o_ref, (), eltwise_kernel(x + y))
  return add

kernel1 = make_kernel(lambda x: x * 2)
kernel2 = make_kernel(jnp.exp)

pl.pallas_call(kernel1, out_shape=x, grid=1)(1., 1.)
pl.pallas_call(kernel2, out_shape=x, grid=1)(1., 1.)仿真模式#
通过将 kernel 表示为带有 JAX 原语和一些新 Pallas 原语的程序,我们还可以将 Pallas 程序直接降低到 StableHLO 并用 XLA 编译/执行。具体来说,pallas_call 可以实现为对 grid 的 lax.scan。这使我们能够在任何 XLA 支持的平台上(甚至 CPU!)开发 GPU 或 TPU kernel,并使用 JAX/XLA 调试工具(如 jax.debug.print)进行调试。我们还可以使用更可靠、经过更充分测试的 XLA 数值精度来验证 Triton 和 Mosaic 编译器的正确性。还可以想象通过扰动 scan 顺序来模拟 GPU 上发生的并行读写。
GPU 示例#
注意以下所有示例仅适用于 GPU。它们需要调整 block 大小才能在 TPU 上工作。
add#
我们修改 add_kernel 示例,使用 BlockSpec 在 (2,) 大小的块上操作。
def add_kernel(x_ref, y_ref, o_ref):
  # 在此代码中,`x_ref`、`y_ref` 和 `o_ref` 是 (2,) 形状的 `Ref`
  x = x_ref[:]
  y = y_ref[:]
  o_ref[:] = x + y
x, y = jnp.arange(8), jnp.arange(8, 16)
add = pl.pallas_call(
    add_kernel,
    out_shape=jax.ShapeDtypeStruct((8,), jnp.int32),
    in_specs=[
        pl.BlockSpec((2,), lambda i: i),
        pl.BlockSpec((2,), lambda i: i)
    ],
    out_specs=pl.BlockSpec((2,), lambda i: i),
    grid=(4,))
add(x, y)
模板化 matmul#
在此示例中,我们通过对输入数组的行块和列块进行展开累加来计算输出的 tile。我们使用高阶函数将激活函数内联到 kernel 主体中,从而生成一个融合 kernel。
def matmul_kernel(x_ref, y_ref, o_ref, *, activation, block_k):
  acc = jnp.zeros((x_ref.shape[0], y_ref.shape[1]), jnp.float32)
  for k in range(x_ref.shape[1] // block_k):
    x = x_ref[:, k*block_k:(k+1)*block_k]
    y = y_ref[k*block_k:(k+1)*block_k, :]
    acc += x @ y
  o_ref[:, :] = activation(acc).astype(o_ref.dtype)

x, y = jnp.ones((512, 256)), jnp.ones((256, 1024))
block_shape = 128, 256, 128

@partial(jax.jit, static_argnames=["block_shape", "activation"])
def matmul(x, y, *, block_shape, activation):
  block_m, block_n, block_k = block_shape
  fused_matmul = pl.pallas_call(
      partial(matmul_kernel, block_k=block_k, activation=activation),
      out_shape=jax.ShapeDtypeStruct((x.shape[0], y.shape[1],), jnp.float32),
      in_specs=[
          pl.BlockSpec((block_m, x.shape[1]), lambda i, j: (i, 0)),
          pl.BlockSpec((y.shape[0], block_n), lambda i, j: (0, j))
      ],
      out_specs=pl.BlockSpec((block_m, block_n), lambda i, j: (i, j)),
      grid=(4, 4),
  )
  return fused_matmul(x, y)

z = matmul(x, y, block_shape=block_shape, activation=jax.nn.gelu)
Lowering Pallas#
用户编写完 Pallas kernel 后,我们将其降低到不同的表示形式,具体取决于目标后端。在 GPU 上,我们将 Pallas 降低到 Triton IR;在 TPU 上,我们将 Pallas 降低到 Mosaic。
将 Pallas 降低到 Triton(GPU)#
将 Pallas 降低到 Triton 比较容易,因为 Pallas 在设计时就以 Triton 为目标语言。Pallas 和 Triton 的主要区别在于:Triton 没有 BlockSpec 的概念,并且在内存加载和存储时使用指针而非索引。
Triton 支持指针作为其语言中的数组元素类型,在 Triton 中你可以从指针数组加载或向指针数组存储。在 Pallas 中,给定一个 (4, 5) 形状的 Ref x_ref,当执行 x_ref[3, 2] 时,我们需要将其降低为计算指向 x_ref 中对应 row-major 位置的 Triton 指针(即计算 5 * 3 + 2 * 1)。类似地,当将切片降低到 Triton 时,例如 x_ref[4, :],我们需要生成一个指针数组 5 * 4 + jnp.arange(3)。
除此之外,降低到 Triton 相当直接。JAX 点积可以降低为 Triton 点积,JAX 一元原语降低为对应的 Triton 等价物。Triton 的原子操作通过新的 Pallas 原子原语来降低。
将 Pallas 降低到 Mosaic(TPU)#
Mosaic 使用(大部分是)标准方言的 MLIR,并生成 LLO 供 TPU 编译。Pallas 可以通过将 JAX 原语翻译为 MLIR(主要是 vector 和 arith 方言)来降低到 Mosaic。BlockSpec 可以转换为流水线调度(即 Mosaic 中的 transform_func)。
变换 Pallas#
一个自然的问题是:JAX 变换如何与 Pallas kernel 交互?主要有两种方式:Pallas kernel 内部的变换和 Pallas kernel 外部的变换。
Pallas kernel 内部的变换实际上应该"直接可用",前提是我们能够降低变换后的代码。例如,我们可以在 JAX kernel 内部使用 jax.grad(jnp.sin)(...),因为我们可以将 cos 降低到 Triton 和 Mosaic。然而,我们可能无法降低 jax.vmap(lax.dynamic_slice),因为它可能转变为一个我们无法降低的 gather 操作。
从外层 JAX 程序对 Pallas kernel 进行变换是更有趣的情况。我们如何处理 vmap(pallas_call) 和 grad(pallas_call) 之类的操作?
vmap-of-pallas_call#
vmap 自动向量化 JAX 程序。虽然 kernel 编写者可能希望精确控制批处理 kernel 与非批处理版本的行为差异,但我们可以为 pallas_call 提供合理的默认 vmap 规则,同时提供 jax.custom_vmap 自定义机制。当 pallas_call 被 vmap 时,我们为 pallas_call 增加一个额外的 grid 维度对应新的 batch 维度,并变换 BlockSpec 以处理沿该维度的索引。
grad-of-pallas_call#
pallas_call 的 grad 实现了 kernel 的自动微分。jax.grad 可以分解为三个不同变换的应用:jvp、partial_eval 和 transpose。原则上,我们可以复用 JAX 的大部分基础设施来为 pallas_call 实现这些规则(因为它的行为很像现有的 JAX 高阶原语)。
然而,kernel 的自动微分可能会因内存访问的转置方式导致性能损失。如果我们编写了一个具有重叠并行读取和不相交并行写入的 GPU kernel,自动转置会将其变为具有重叠并行写入(原子操作时很慢)和不相交并行读取的 kernel。为了生成更好利用共享内存并行性的 kernel,我们需要重排循环并改变 kernel 的向量化方式。不幸的是,Pallas 中没有适合这种操作的程序表示。一个可能的方向是探索不同的表示,也许类似 Dex 中的表示。我们也可以研究 Enzyme 如何解决这个问题。不过,Pallas kernel 的自动微分对于一类能高效转置的 kernel(例如逐元素 kernel)仍然有用。
总的来说,jax.custom_vjp 是一种可行的逃生舱口,用于表达与 jax.grad 配合使用的 Pallas kernel。
其他变换#
我们可以想象其他 JAX 变换应用于 Pallas kernel,虽然我们还没有明确探索。例如,checkify 是一种进行函数式错误处理的 JAX 变换。我们可以想象将 checkify 与 pallas_call 结合使用,从 GPU kernel 中传出指示是否发生越界访问或产生 NaN 的错误码。
另一个有潜力整合的变换是 custom_partitioning,使得可自动分区的 kernel 能与 pjit 一起使用。