在 2018 计算机体系结构国际研讨会上, John Hennessy 和 David Patterson 发表了他们的 Turing 讲座: “计算机架构的新黄金时代”。
在 20 世纪 80 年代, Hennessy 和 Patterson 进行了他们的图灵奖获奖研究,
单线程 CPU 性能每年增长 52%。到 2018 年,随着 摩尔定律 和 登纳德缩放的结束,该比率为 3%。
于是,Domain-Specific Architecture(DSA)成为重要方向。Hennessy 和 Patterson 以 Google 已投入生产的 TPU v1 为例:它的神经网络推理吞吐量是 CPU 的 29 倍,能效则高出 80 倍。最后,他们预测:“未来十年将迎来计算机架构的寒武纪大爆发。”
这一预测成真了。如今,已有数十种架构进入严肃开发阶段: GPU、 TPU、 LPU、 NPU、 DPU、 ASIC、 晶圆级引擎、 可重构数据流、 神经形态、 光子计算与 模拟计算。其中相当一部分聚焦于 AI 计算。
迄今为止已获得实际部署的架构: GPU (NVIDIA、AMD)、 脉动阵列加速器 (TPU、Trainium)、 Cerebras 晶圆级引擎和 Groq LPU。
NVIDIA 是明确的领先者; AMD 紧随其后,并分别获得 OpenAI 和 Meta 各 6 GW 的部署承诺。 TPU 用于训练 Gemini,并将 以多达 100 万颗芯片为 Anthropic 提供服务;Anthropic 还在 超过一百万颗 Trainium 芯片上运行 Claude。 Cerebras 现已承载 OpenAI 推理服务; Groq LPU 则通过一笔 价值 200 亿美元的 acquihire 交易并入 NVIDIA。
本文将系统梳理这些不同路线的 设计理念、 芯片架构、 扩展方式(纵向扩展与横向扩展)以及 软件栈(如何对芯片编程)。
问题
AI 计算以 矩阵乘法为主。 Transformer 是一系列 matmuls: Q/K/V 投影, attention, 输出投影, FFN - 与 element-wise ops 交错:归一化、激活、残差添加。 训练 前沿模型执行 乘法累加运算(matmuls 是一系列乘法累加)。
matmul shape 取决于 workload。训练阶段会让一批 sequence 依次通过所有 layer,再做 backpropagation 和 optimizer update;同一块 weight matrix 往往同时处理数千个 token。Prefill 是 inference 中处理完整 prompt 的阶段:模型在生成第一个 output token 之前,一次性计算整段输入。training 和 prefill 都能把大量 token 堆叠在同一块 weight matrix 上,因此主要计算是 arithmetic intensity 很高、通常 compute-bound 的 GEMM。Decode 则是 autoregressive 的:必须生成 token N 后才能开始 token N+1,每一步的 matmul 因而更接近 GEMV。生成一个 token 需要读取整套 model weight,并在 attention 中读取 KV Cache,所以 decode 的 arithmetic intensity 比 prefill 低几个数量级。
推理系统通过 batching 把这些 GEMV 重新组织成 GEMM 来提高 arithmetic intensity: continuous batching 堆叠许多用户的 decode 步骤, speculative decoding 为每个请求生成 K 个 draft token,再一次性完成验证,并且 multi-token prediction 把同一思路直接内置到模型中。这实现了 matmul 单元的更高利用率,并提高了 Ops/B。对于 continuous batching,每个用户的请求仍然读取自己的 KV Cache,因此长上下文 decode 从 weight-bandwidth-bound 转变为 KV-bandwidth-bound。
这里的架构问题是 足够快地把数据 送到 matmul 单元。这被称为 内存墙:计算量呈指数级增长,但内存带宽却没有。
每种架构都提出了不同的策略来赢得 data movement 竞争。理解一颗 AI chip 可以归结为四个问题: 数据 在哪里,它如何 移动 到计算单元, 计算单元 的外观,以及芯片如何在 规模上相互通信。
NVIDIA GPU
NVIDIA GPU 的核心定位是 massively parallel processor:一颗可编程芯片提供数千个 thread,由 host CPU 负责 orchestration,并通过 CUDA 暴露给 developer。每一代都会在 Streaming Multiprocessor 上加入新的 acceleration primitive,但保留相同的 programming model。正因如此,同一颗 GPU 既能训练 Transformer、执行 inference,也能用于 graphics rendering 和 scientific computing。
演进路线
架构
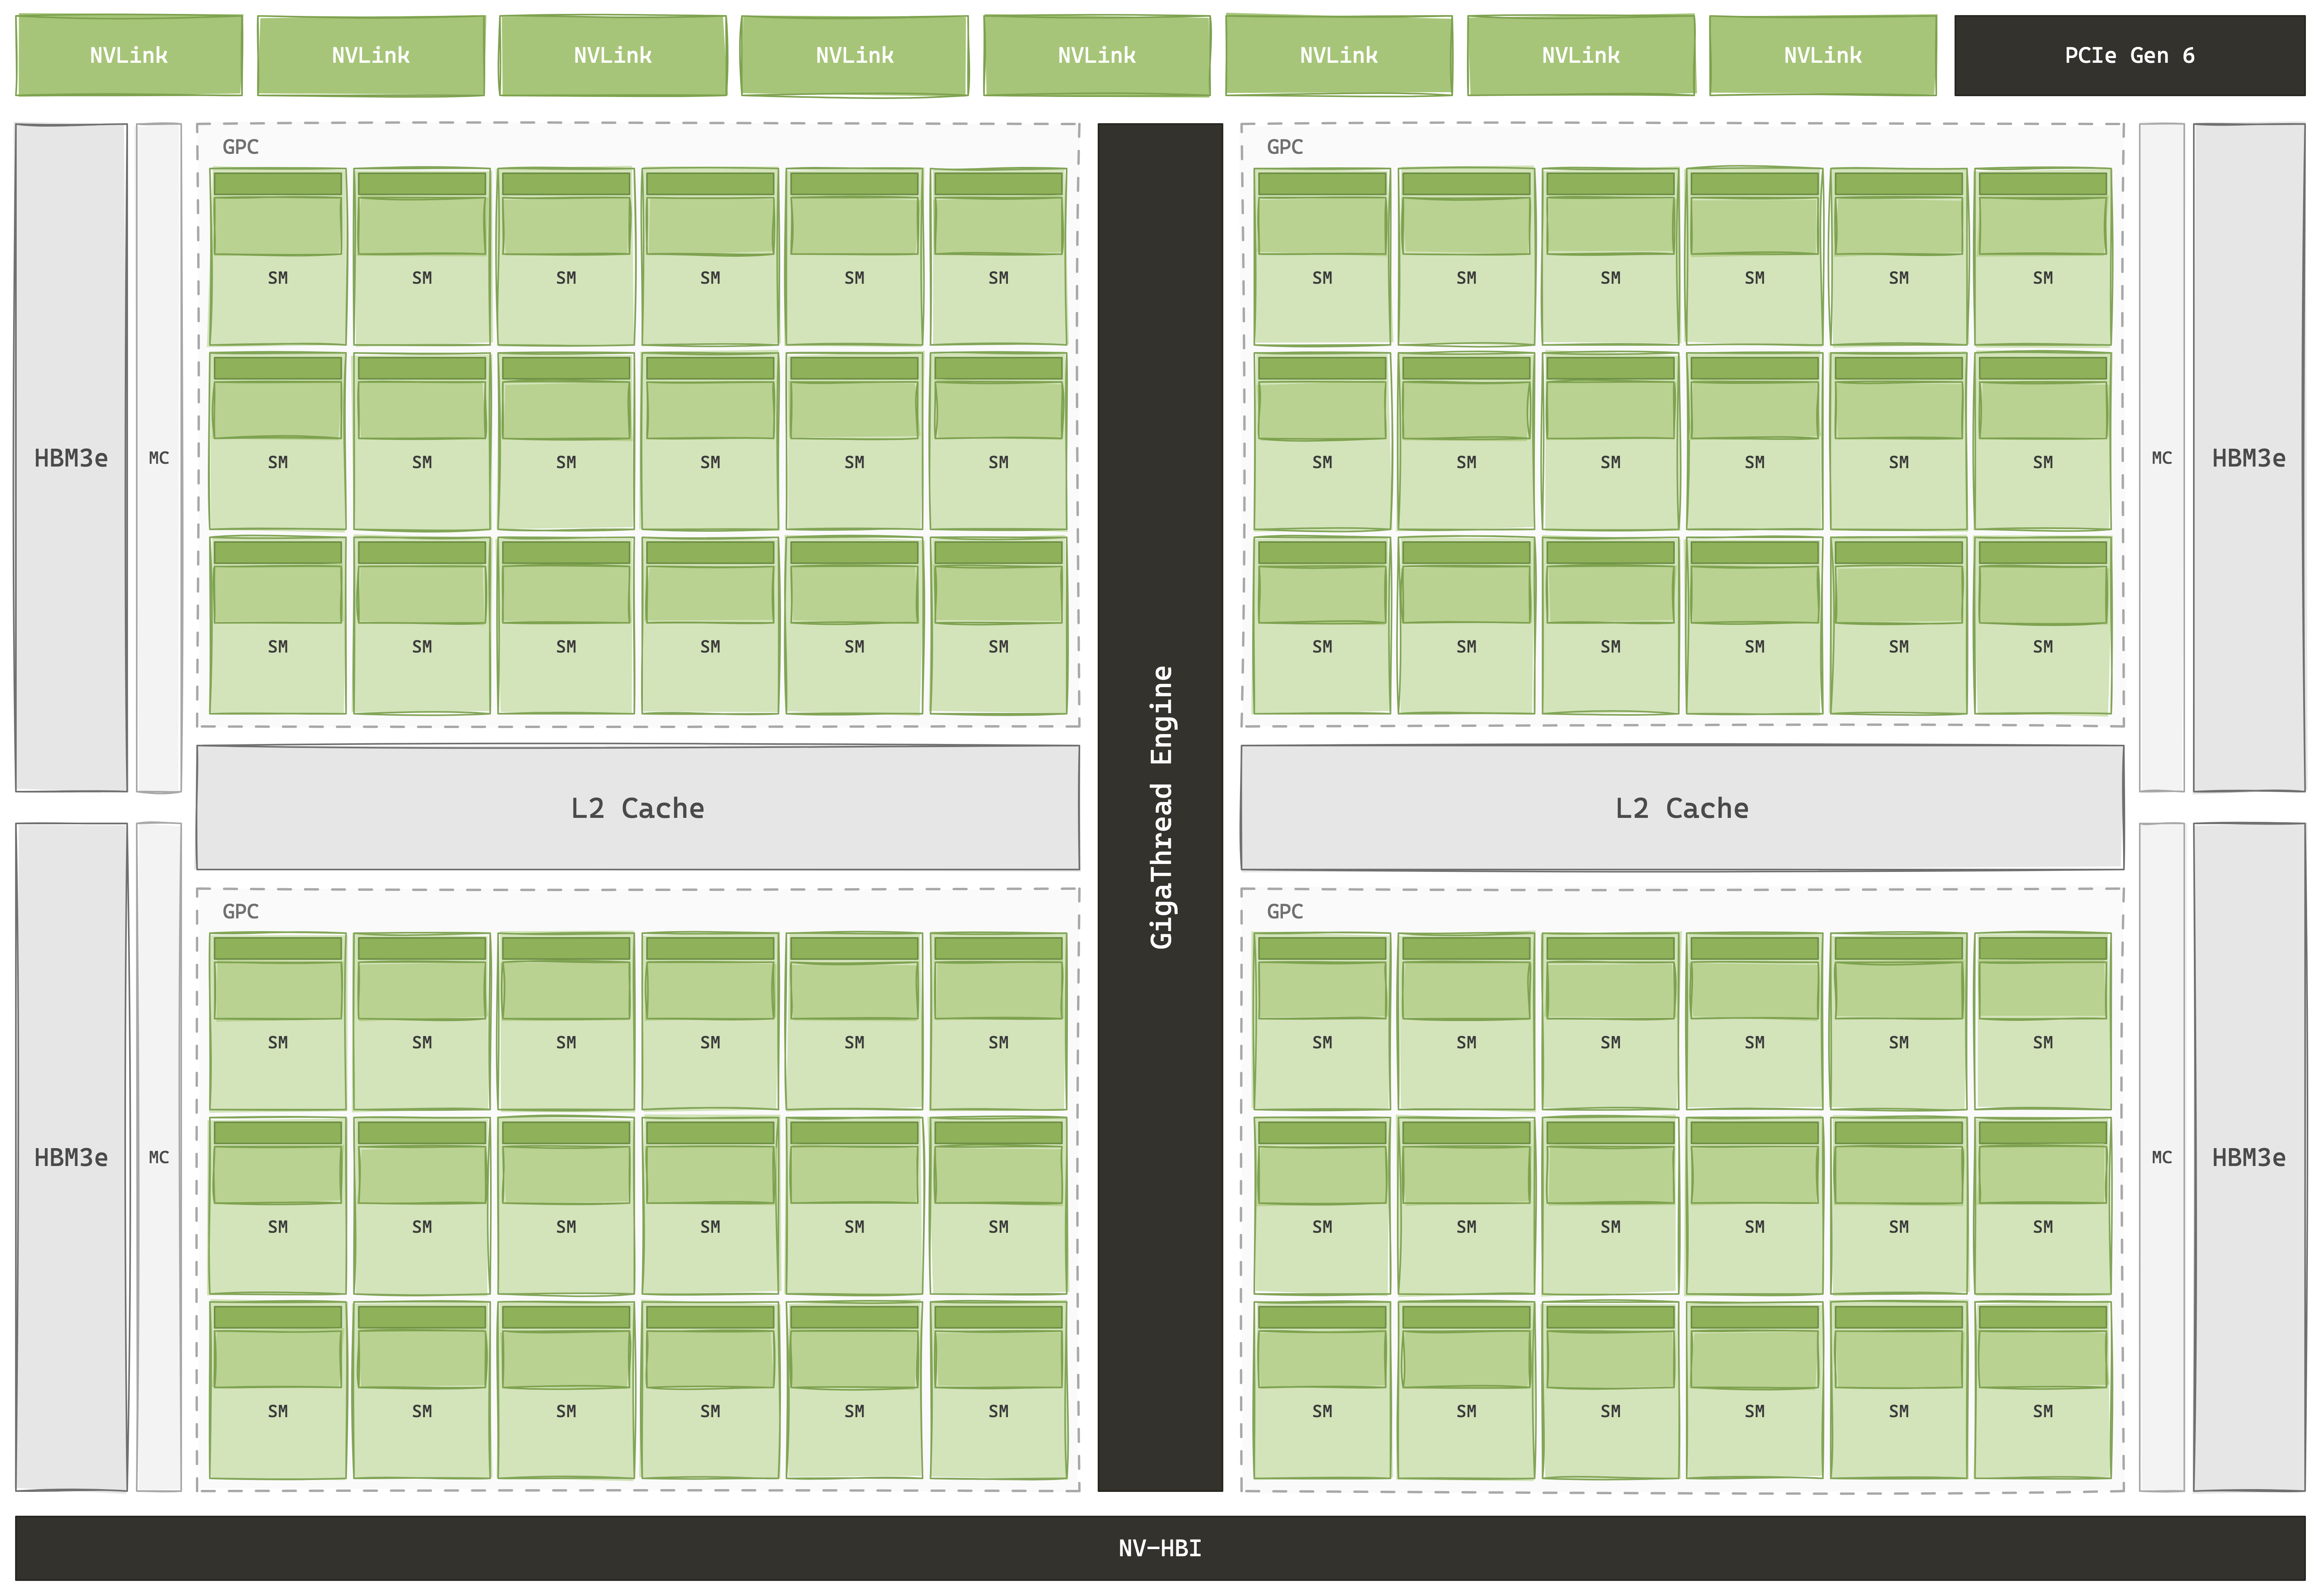
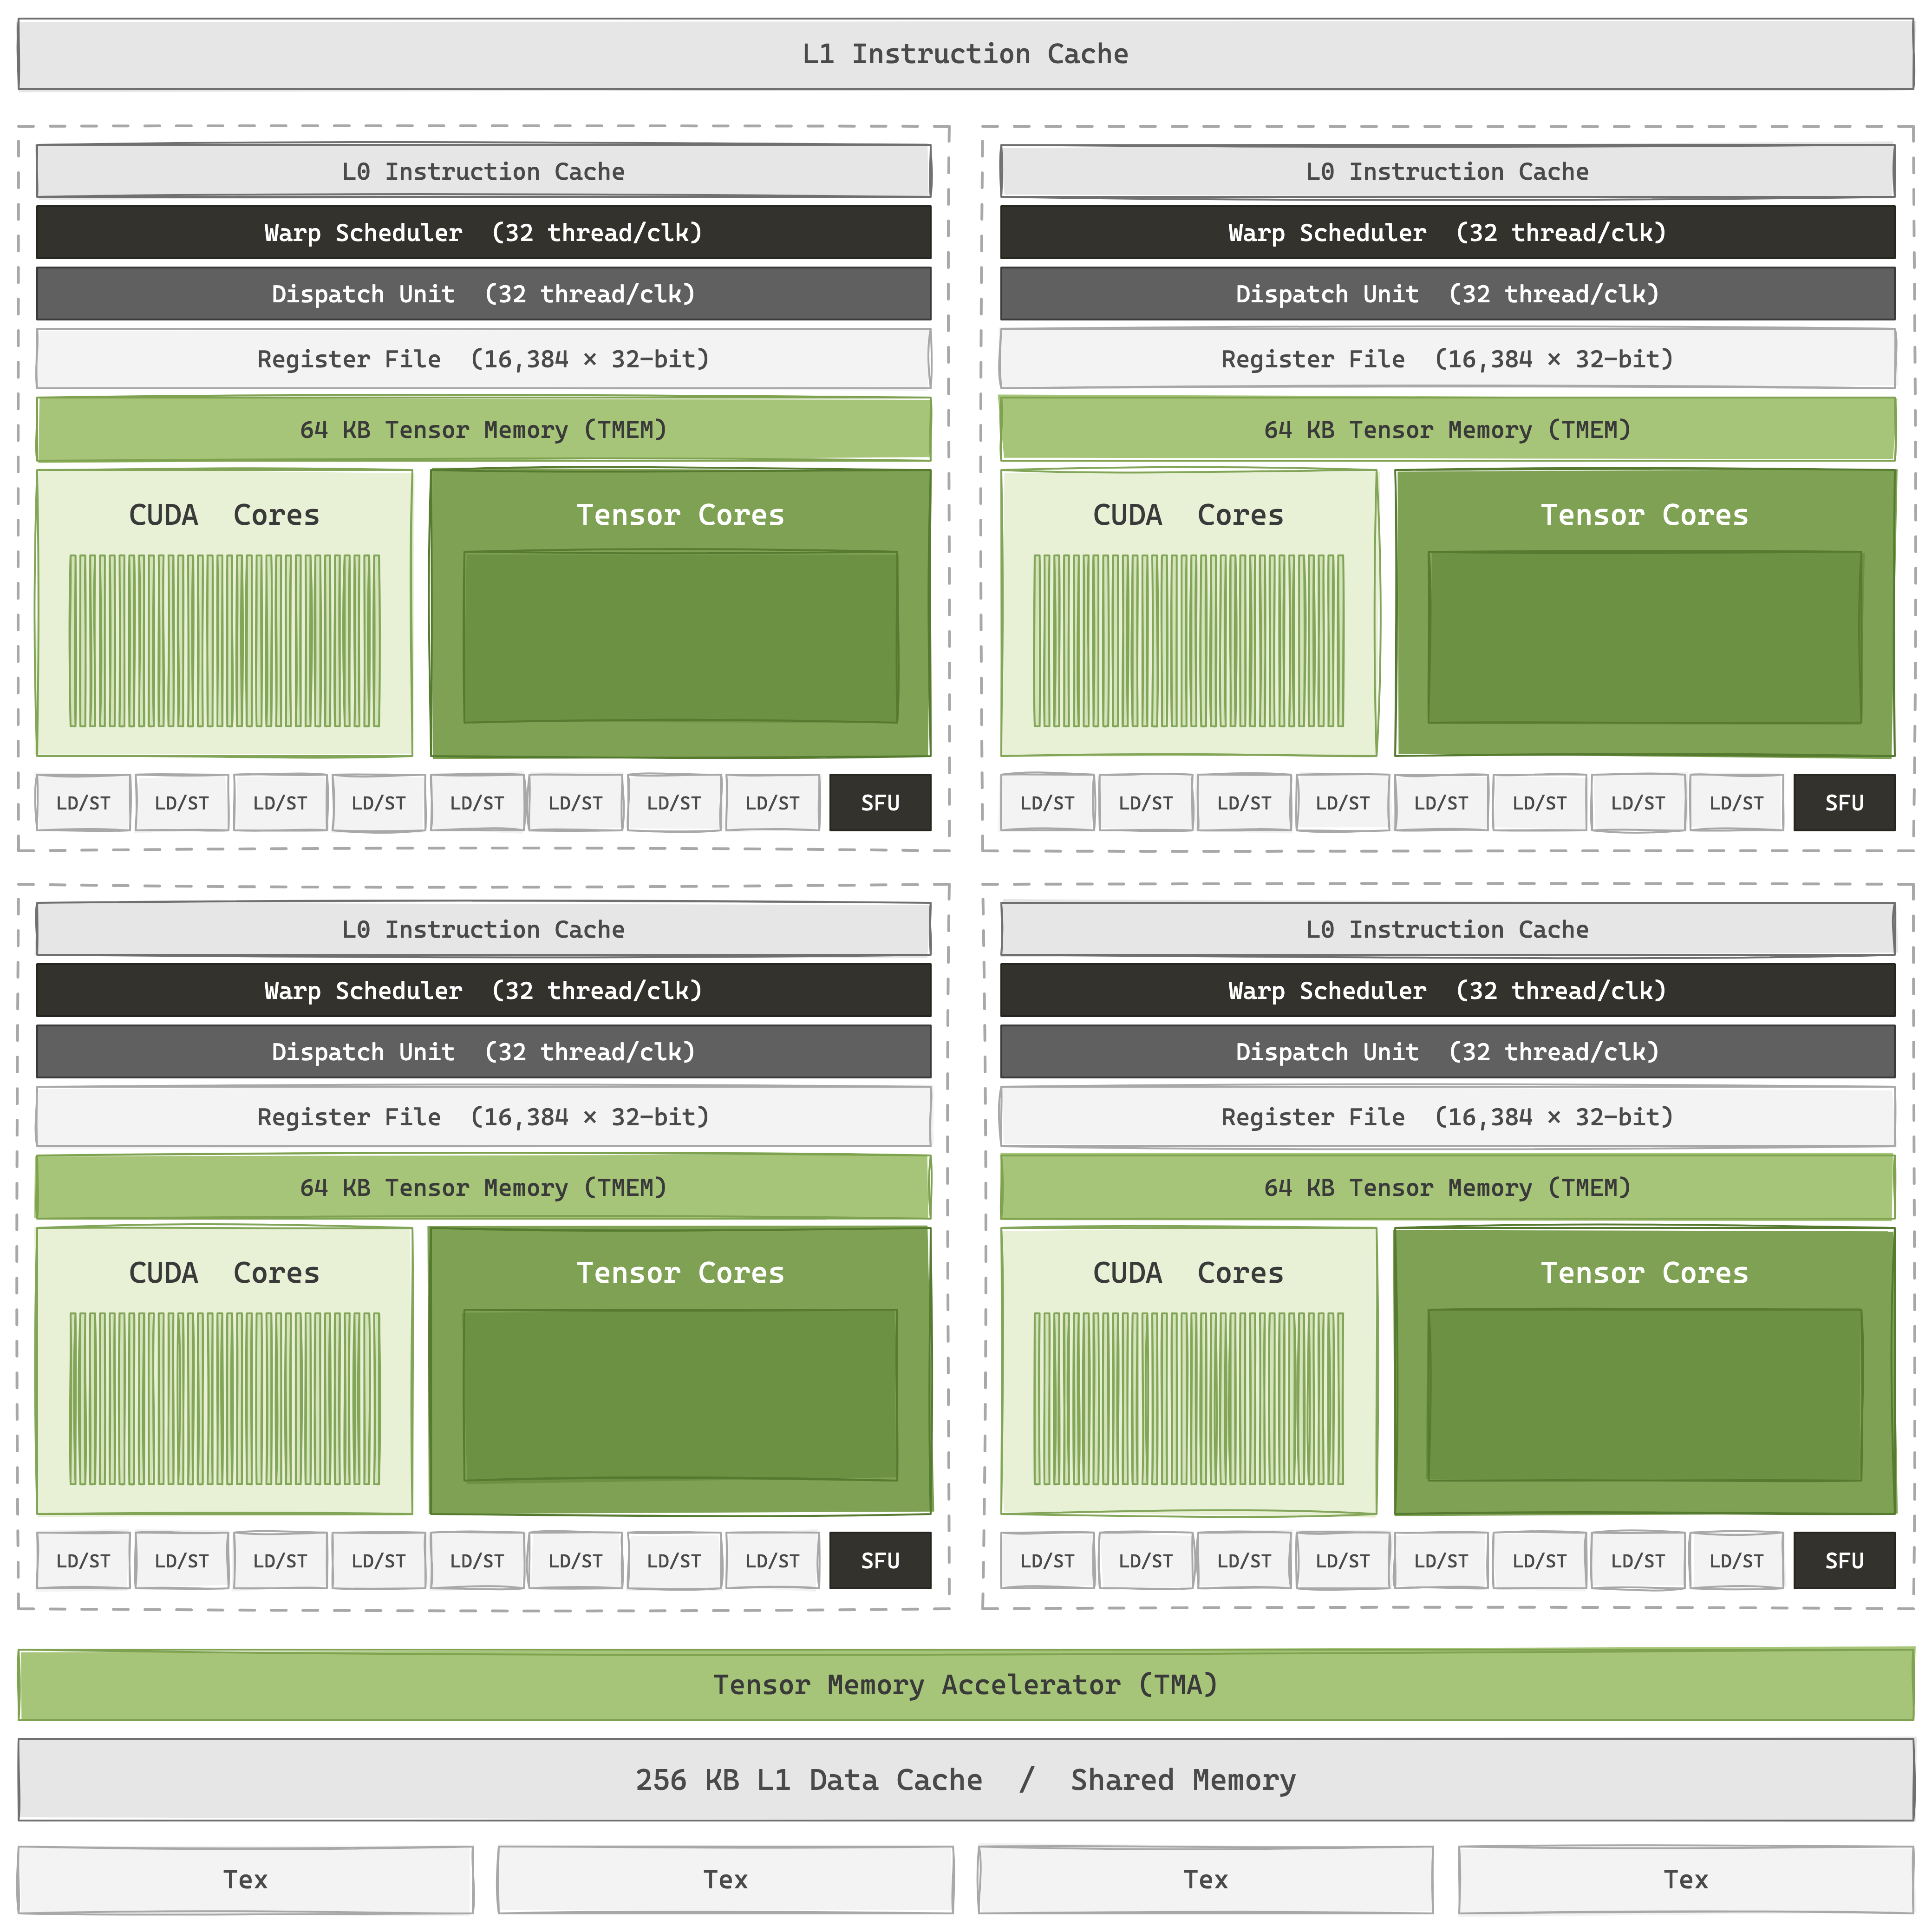
NVIDIA GPU 由大量面向吞吐的 Streaming Multiprocessor(SM) 组成,并配套多级内存层次和硬件调度器,让数千个 thread 保持 in flight。SM 的数量从 V100 的 80 个、A100 的 108 个、H100 的 132 个,增长到 B200 的 148 个、B300 的 160 个和 Rubin 的 224 个。每个 SM 包含四个 SM sub-partition;每个 sub-partition 都有独立的 warp scheduler、dispatch unit、16K×32-bit register file、CUDA Core lanes、SFU,以及访问 Tensor Core 的端口。四个 sub-partition 共享 L1/SMEM 和 TMA。thread 以 32 个为一组组成 warp,并按 SIMT 模式锁步执行;调度器在多个 resident warp 之间切换,以隐藏 memory stall 和 arithmetic stall。
计算
CUDA Core 是原始的计算吞吐量,对于人工智能来说,它们仍然拥有除 matmul 以外的所有内容:激活、残差加法、归一化、地址算术。但是,Transformer 块的 matmul FLOP 数约为 99%,因此压倒性的计算吞吐量来自 Tensor Core。
这些核心执行 融合矩阵乘法累加 在小型 matrix tile 上, 完整的 matmul 被分解为输出 tile:为了生成一个输出 tile,内核遍历共享的内部维度 ,读取左矩阵 A 的行块 ,并读取右矩阵 B 的列块 ,并将每个部分乘积累加到当前 accumulator 中。 保存到目前为止的部分和, 是带入下一步的更新值。内循环完成后, 就是完整输出矩阵中的一个最终 tile;整个 matmul 由许多这样的 tile MMA构建而成。
tile shape 记为 M × N × K, 是输出 tile 大小, 表示单条指令沿 reduction dimension 处理的长度; matmul 的 轴的其余部分由内核的内部循环遍历。accumulator 会在整个 K-loop 中持续复用:每个 MMA 的输出 成为下一个 MMA 的输入 ,因此实际执行的是原地累加 就位:连续的指令将其部分乘积折叠到同一存储中,直到 K 轴遍历完成。
V100 的第一代 Tensor Core 每个 SM 有 8 个,执行 warp-level 16×16×16 FP16 MMA。A100 的第三代 Tensor Core 加入 TF32、BF16、FP64 matmul 和 2:4 structured sparsity。H100 的第四代 Tensor Core 支持原生 FP8,并把 MMA 的协作范围从单个 warp 扩展到 128-thread warp group:wgmma 以 64×256×16 tile shape 异步执行,发射它的 warp group 可以同时加载下一块 tile。B200 的第五代 Tensor Core 进一步支持 256×256×16 two-SM MMA、原生 FP4,并为每个 SM 增加 256 KB Tensor Memory(TMEM)来保存 accumulator tile,减轻 register pressure。Rubin 的第六代 Tensor Core 增加原生 FP6,并配合第三代 Transformer Engine 在硬件中完成自适应 NVFP4 micro-block scaling,使 quantization metadata 留在 Tensor Core datapath 上。
在所有六代中保持不变的是,matmul 位于 thread/warp 层次结构中,但是 issue 的 thread 数量已经减少,并且 issue 过程也逐渐与执行解耦。 Volta的 mma.sync 是 warp-collective 和同步: warp 中的所有 32 个 thread 一起执行,每个 lane 保存 A、B、 和 accumulator D的 register fragment,并且整个 warp 会阻塞到指令完成。 Hopper的 wgmma.mma_async 把 issuer 扩展为 warp-group 128 个 thread,将 B 移动到 shared-memory descriptor (A 变为可选:register 或 descriptor,内核选择),以及 立即返回:matmul 在后台运行,同时 warp-group 对下一个 tile 进行排队,并通过 wgmma.commit_group / wgmma.wait_group跟踪完成情况。
Blackwell 的 tcgen05.mma 完成了这一迁移:A、B 都可以由 shared-memory descriptor 提供,accumulator D 则写入 TMEM,不再占用 per-thread register fragment。由于 operand 和 accumulator 都脱离了 lane,一条 MMA 可以由单个 thread 发射并立即返回;consumer warp 通过 mbarrier 等待完成。CTA-pair 版本把同样的机制扩展到两个 SM:每个 SM 各有一个 thread 协同 issue MMA,共享 operand,并通过 cluster-level barrier 保持同步。
同时发出 thread 上的 matmul 变得更大、更轻:开始为 32 lanes 锁步运行的指令现在更接近于单个 描述符驱动命令,仍从 warp model 内 issue,但不再由其执行。
这种解耦使得 Transformer attention kernel 在 GPU 上高效运行。在 matmul 运行时,warp 可以运行 softmax、应用掩模或预加载下一个 tile; matmul 和周围的 element-wise 工作的重叠是每个现代 attention kernel 的结构(FlashAttention-3,FA4),并且它取决于不阻塞 warp 的矩阵指令。
内存
片上层次结构是 各个级别的硬件管理缓存,软件提示位于顶层。片外为 HBM:32 GB HBM2 V100,80 GB HBM3 在 H100 上,192 GB HBM3e 在 B200 上,288 GB B300,288 GB HBM4 ,Rubin。芯片级 L2 缓存 位于 HBM 和 SM 之间:V100 上为 6 MB,A100 上为 40 MB,H100 上为 50 MB,B200 上为 60 MB(分为两个 30 MB 存储体) 双芯片封装,具有位置感知 驻留控制 ,以便热块可以固定到附近的芯片上)。在每个 SM 内部,256 KB 的统一 L1/SMEM 在 kernel launch 时在硬件管理的 L1 和程序员控制的 scratchpad 之间进行分区。每个 SM 的 register file 大约为 256 KB,在分区上分为四个方向。
Blackwell 添加了第五层: TMEM,每个 SM 256 KB 专用于 MMA accumulator,仅由 Tensor Core 寻址,将 operand 驻留压力从通用 register file 中拉出。
memory movement 也在逐代摆脱 warp。Ampere 之前,global memory 到 shared memory 的 tile load 需要 thread 先把数据读入 register,再写入 SMEM,整个 warp 在 load 完成前都会阻塞。Ampere 的 cp.async 允许每个 thread 发起 HBM→SMEM async copy,并绕过 register。Hopper 又把这件事交给 TMA:单个 thread 提交包含 base address、stride 和 swizzle 的 multidimensional tile descriptor,DMA engine 自动完成 address generation,把数据写入 SMEM,再通过 mbarrier 通知 consumer。TMA 还支持 cluster multicast,让一次 HBM read 同时送达 thread-block cluster 中的多个 SM。Blackwell 进一步支持直接向 TMEM 搬运数据。整体趋势很清楚:每一代都让 warp 少参与一些 data movement 和 address calculation。
Warp 专用化
Hopper 之后常见的编程方式是 Warp Specialization:同一个 thread block 内,一组 warp 作为 producer,连续发出 TMA load;另一组 warp 作为 consumer,在 tile 到达后执行 wgmma。二者不再依赖整个 block 的 __syncthreads(),而是通过 mbarrier 和 TMA completion barrier 做细粒度握手。FlashAttention-3、CUTLASS ping-pong GEMM 和 Blackwell FA4 都采用类似结构:TMA producer pipeline 经 SMEM/TMEM 向 wgmma consumer pipeline 供数,thread-block cluster 再把多个 SM 组织成一个协作单元。
数值格式
FP32 是历史默认值; Volta 带来了 FP16 FP32 累积和 loss scaling 使其可训练的技巧;添加了 Ampere TF32 (FP32 范围、FP16 尾数、FP32 matmul 的插入)、 BF16和 2:4 structured sparsity ,使修剪权重的有效吞吐量加倍。 Hopper 引入原生 FP8 在 E4M3 和 E5M2 中,与 Transformer Engine 配对,可逐层自动缩放激活以将其保持在 FP8 动态范围内。 Blackwell 通过 FP4 再次将精度减半,并推出了 microscaling MX 格式 (恢复最多的块级共享指数) FP4 的准确性损失),以及将自动缩放管道重新定位到 FP4 的第二代 Transformer 引擎。 Rubin 的第三代 Transformer 引擎添加了 NVFP4 (NVIDIA 的强化 FP4 变体)和原生 FP6 具有更激进的稀疏性。芯片布局本身现在已成为数字故事的一部分:B100/B200/B300 是 两个十字线限制芯片 以约 10 TB/s 的速度缝合 NV-HBI 链接并作为一个逻辑 GPU 呈现给软件,封装上有 8 个 HBM 堆栈; Rubin 将小芯片配方扩展到具有 8 个 HBM4 堆栈的约 336 B 晶体管的双芯片。每一代通过将位数减少一半并通过更细粒度的缩放方案恢复精度,以及越来越多地通过将更多的硅粘合到封装中来购买大约 2 倍的每瓦吞吐量。
设计取舍
- 可编程性。 工作负载是一个移动目标(注意力变体、新颖的模型架构),因此请保持每个模块的可编程性并让开发人员编写 CUDA。连专业单位都暴露了 通过 该模型而不是固定功能块。
- 通过大规模多 thread 隐藏延迟。 延迟是不可预测的且依赖于数据,因此不要使用静态计划而是使用大量 thread 来隐藏它过度使用,每个 SM 最多 64 个常驻 warp,硬件 warp 调度程序 每个周期都会选择一个就绪的 warp。
- warp 包裹的 Matmul。 矩阵单元具有压倒性的计算吞吐量,但它必须存在于其他所有东西使用的相同 warp/thread 抽象后面,因此将其包裹在
mma.sync→wgmma→tcgen05.mma- 而不是将其公开为固定功能管道。这使得单个 core 能够一次性融合 matmul、softmax 和 element-wise 运算。 - 异步内存层次结构。 使内存层次结构 显式 和 程序员管理 而不是 隐式 和 编译器调度。保留 二级缓存,但公开 SMEM 和 TMEM 作为命名 scratchpad,并在顶部分层异步机制: TMA 用于批量复制, TMEM 用于 matmul accumulator,
mbarrier用于生产者/消费者握手。层次结构位于可编程内核内 软件流水线 ,而不是由编译器针对已知延迟 scratchpad 进行静态调度。 - 摊销 SIMT 税。 用于 warp 调度程序、register file 或一致性缓存的每个晶体管都是未用于 MAC的晶体管;接受税收,并以两种方式支付:Tensor Core 现在足够大,SIMT 机器可以在更大的 MAC 数量上摊销,像 TMEM 这样的单元会牺牲一些通用灵活性来换取 MAC 密度。
扩展
人工智能基础设施同时使用:带宽需求 collective (tensor parallel、 MoE 专家路由)留在扩展域内; 数据并行 和 管道并行 跨横向扩展结构。
纵向扩展
扩展堆栈为 NVLink 加上 NVSwitch。 NVLink 实现 缓存一致性结构 GPU 之间,因此一个 GPU 上的加载或存储可以通过硬件处理地址转换和一致性来针对另一个 GPU 的 HBM 。但 NVLink 本身是点对点的:一条链路恰好连接两个芯片。 NVSwitch 是专用的 crossbar 每个 GPU 连接的芯片,路由流量,以便每个 GPU 可以同时以完整 NVLink 带宽进行通信, 非阻塞 和 all-to-all。
他们共同定义了 HGX 8-GPU 基板,配对八个 H100 SXM 模块,带有 x86 主机(AMD EPYC 或 Intel Xeon)超过 PCIe Gen5。 Hopper 还提供了 Grace配对形式: GH200 Grace Hopper Superchip 通过 Grace ARM CPU 到一个 H100 超过 NVLink-C2C ,速度为 900 GB/s,消除了 PCIe 主机设备跃点。模块可扩展为 GH200 NVL2 对和机架级 GH200 NVL32。 Blackwell 将配对设置为默认值。 GB200 模块将一台 Grace 与两台 B200 融合在一起 NVLink-C2C和 NVL72 将其中的 36 个连接成单个液冷扩展域中: 72 个 GPU、36 个 Grace CPU、13.5 TB HBM 和 17 TB LPDDR5X 作为一个平坦、一致的地址空间。 Rubin 将其分为两部分。 NVL144 将于 2026 年作为 Rubin 一代的更新产品在同一个 Oberon 中发货级机架:72 个 Rubin 封装,根据 NVIDIA 新的芯片计数约定标记为 144 个 GPU,具有 HBM4 和 NVLink 6 将每个封装带宽加倍。实际的机架规模跳跃是 2027 年的 Rubin Ultra: NVL576 将 144 个四芯片 Rubin Ultra 封装装入新的 Kyber 用于 576 GPU 芯片的机箱位于一个相干域中。
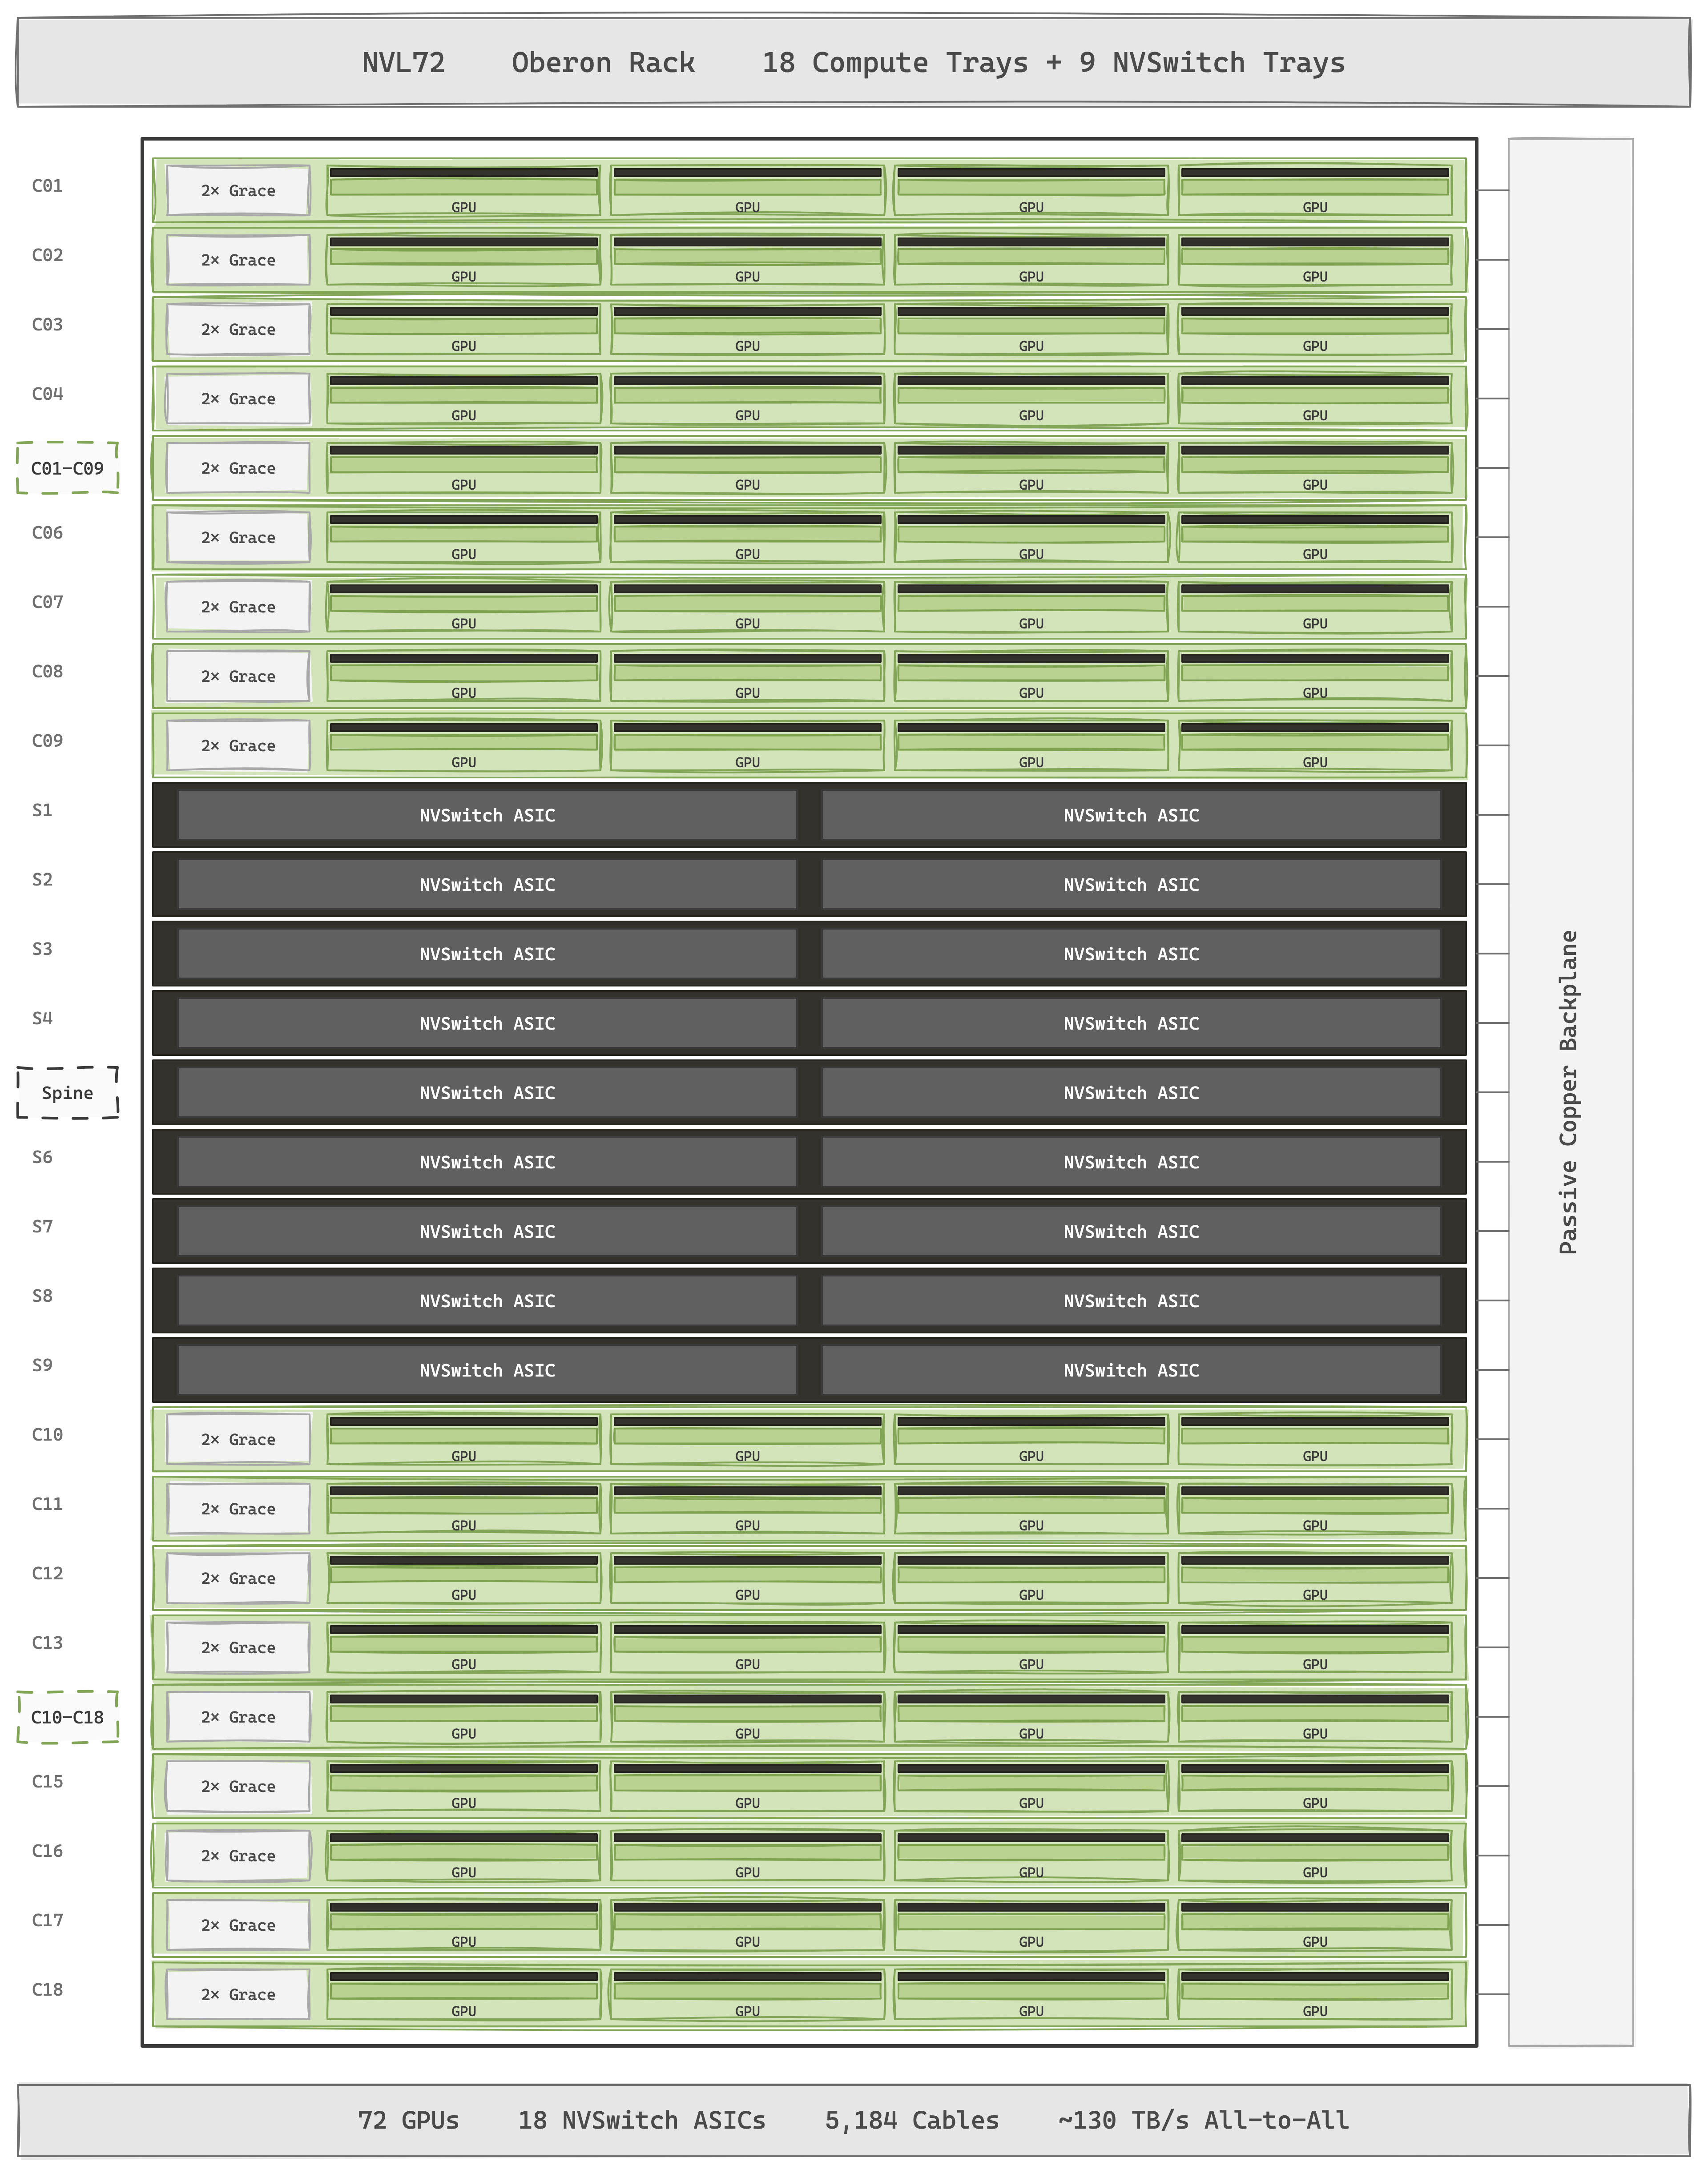
该密度由 无源铜保持在一起。 NVL72 的 NVLink 结构通过背板盲插运行超过 5,184 条电缆(每个机架约 2 英里的布线,没有 in-cable retimer, SerDes 运行在 GPU 和 交换机 ASIC 上),承载约 130 TB/s 的 所有 跨 72 个 GPU 的带宽。 NVIDIA 估计,与每个链路上都需要 可插拔收发器 的光学等效方案相比,选择铜缆可以为每个机架节省大约 20 kW 的电量。铜使得 机架作为一个 GPU 经济实用:在低于 2 米的运行中,它仍然在功耗、成本和信号完整性方面胜出。除此之外,这些位必须安装在玻璃上。
NVL144 留在 Oberon 内部,铜继续工作,因为封装数量 (72) 与 NVL72 相同;布线不必加长,只需在第 6 代 SerDes 上传输速度更快即可。 Rubin Ultra的 NVL576 通过重塑机架来保持相同的铜线:新的 Kyber 外形尺寸大约是 Oberon 高度的两倍,并将所有 576 个 GPU 芯片封装到一个外壳中,其尺寸经过专门设计,因此即使在 144 个四芯片封装和数万根电缆的情况下,每个 NVLink 路径也能保持在无源铜缆范围内。
横向扩展
横向扩展堆栈来自他们对 Mellanox的收购。与 NVLink不同,横向扩展结构 不连贯:节点保留单独的地址空间,数据仅通过显式交叉 RDMA 由软件发起,通常封装在 NCCL 集合中,例如 all-reduce 或 all-to-all。参考 集群 是 DGX SuperPOD:八个 NVL72 机架缝合在一起 Quantum-X800 InfiniBand 在单个调度程序下产生 576 个 Blackwell GPU,训练集群通过平铺 SuperPOD 进一步扩展。 2026 年的 Rubin SuperPOD 与 NVL144 保持相同的 8 机架模式(每个 SuperPOD 产生 1,152 个 GPU,而不是 576 个)。 Rubin Ultra 将于 2027 年将这一方案扩大一个数量级:Kyber 机架每个包含 576 个 GPU 芯片,通过 Quantum-X Photonics CPO缝合在一起,将数千个一个调度程序下的 GPU。
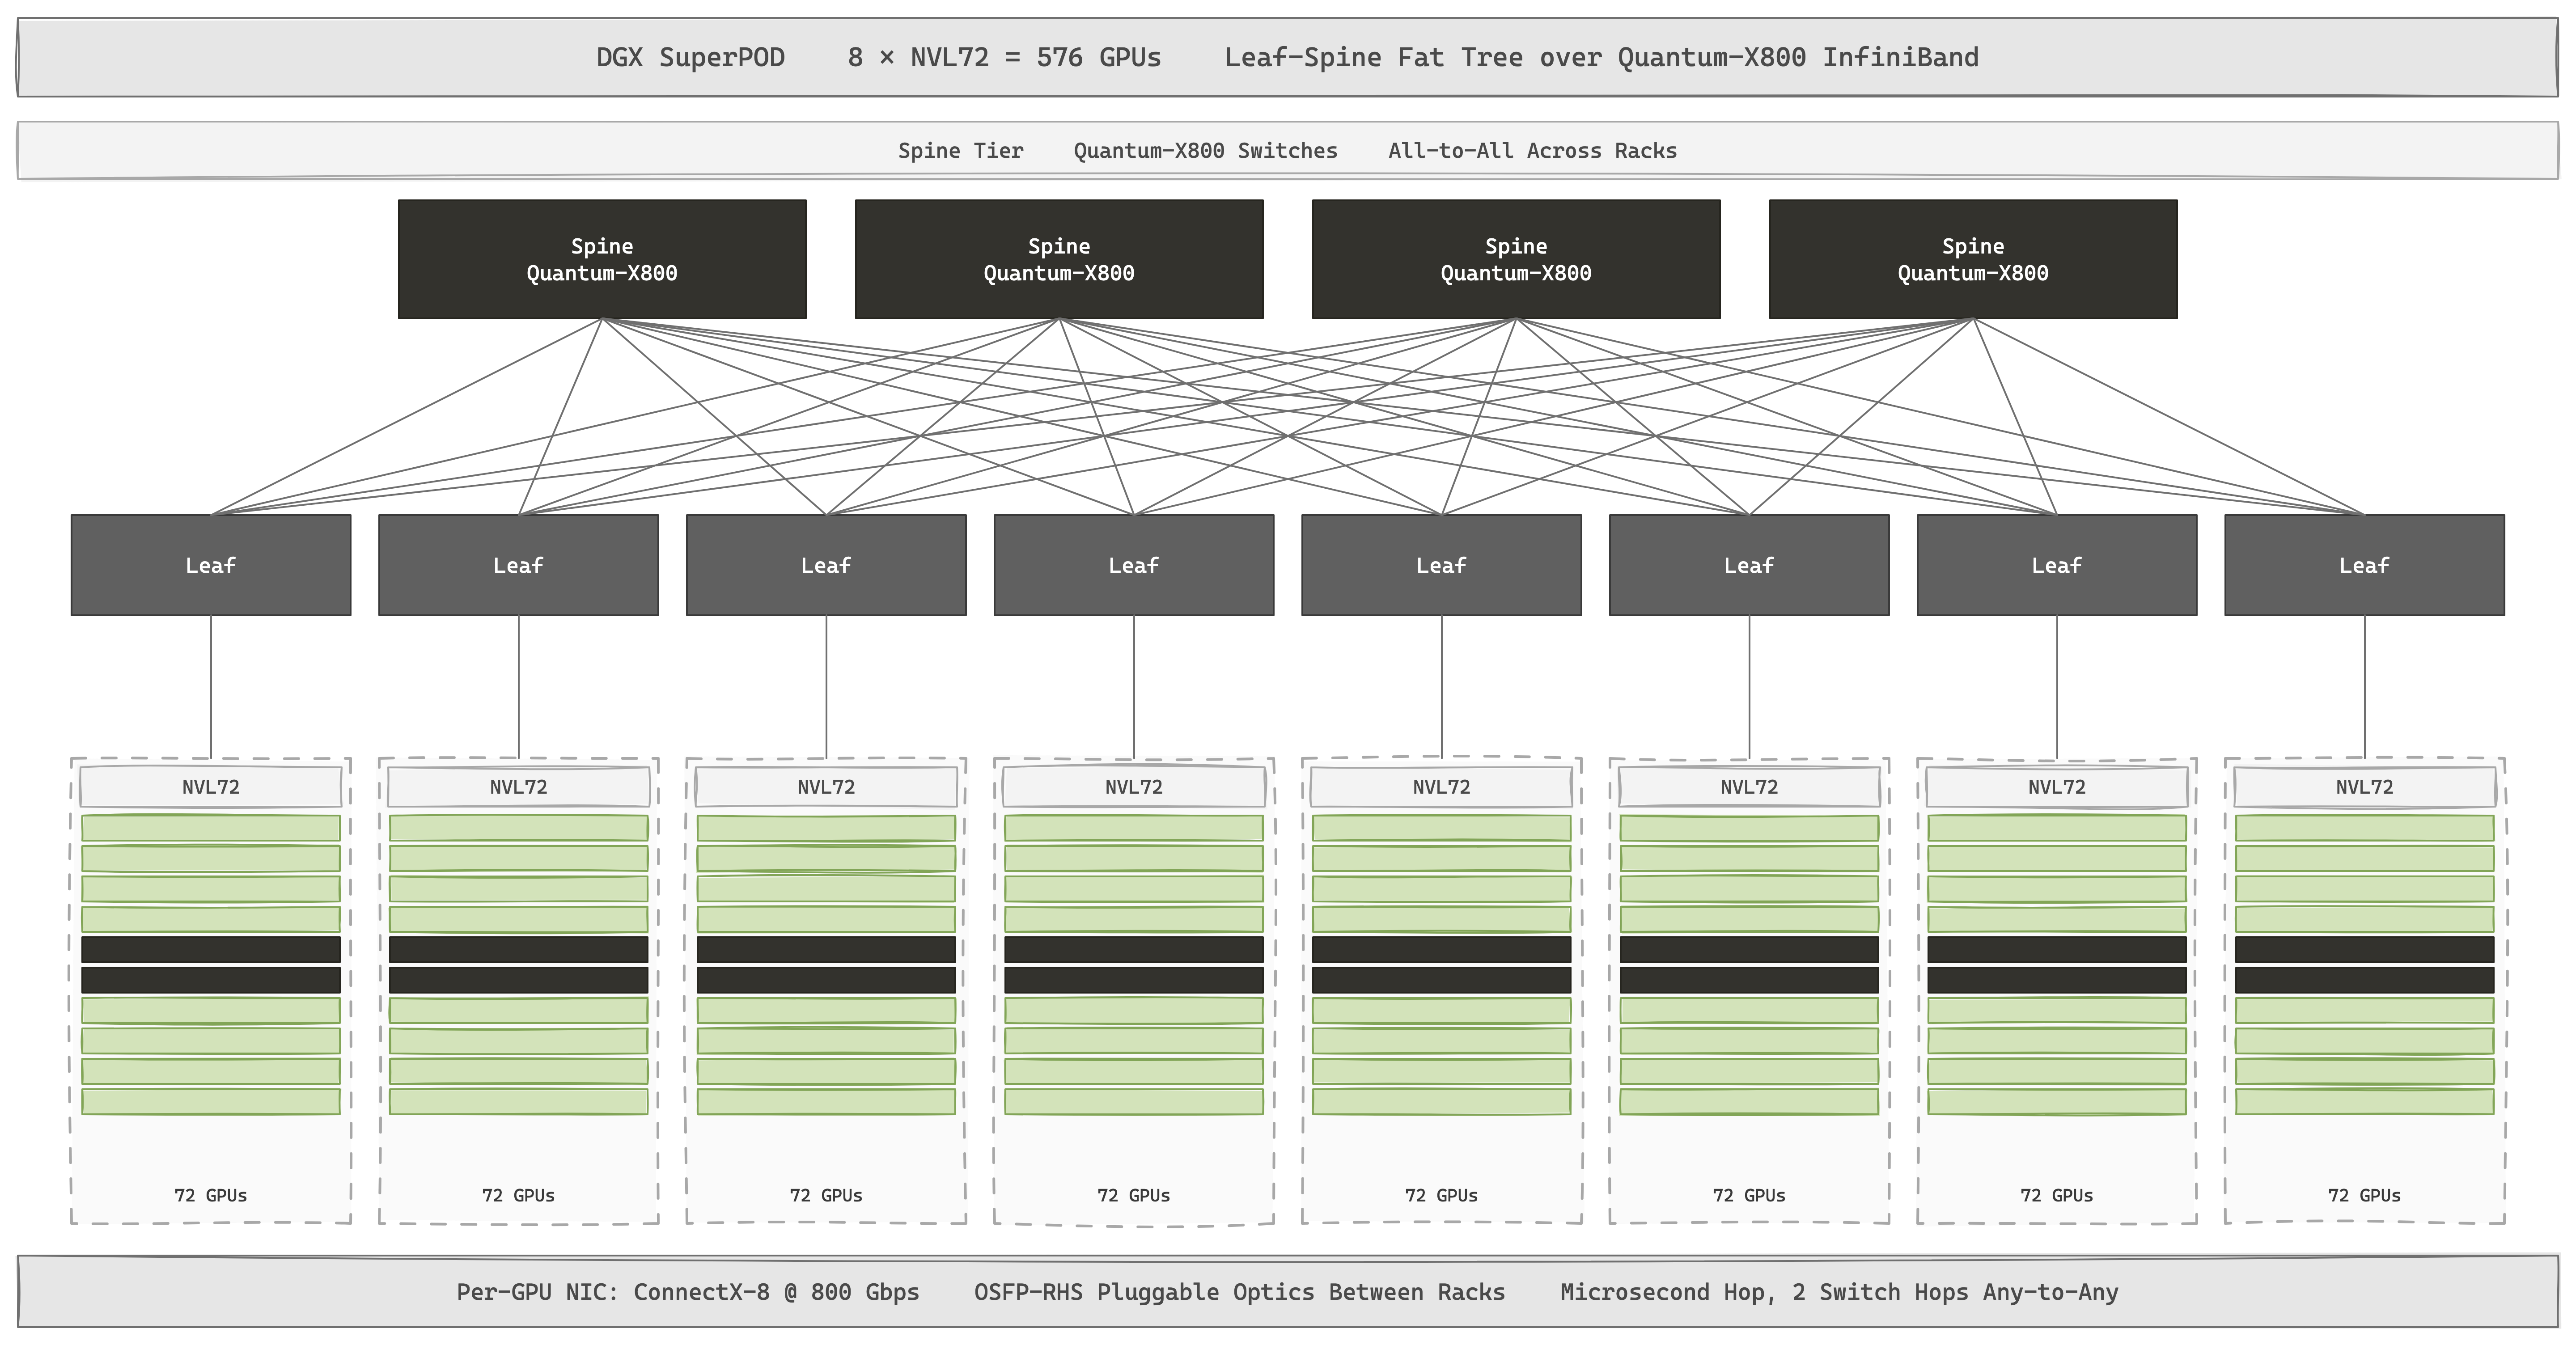
每个 GPU 在该结构中都有自己的 ConnectX NIC 。 Blackwell 节点以每个 GPU 800 Gbps 的速度运行 ConnectX-8,比每个 GPU NVLink的带宽低一个数量级,并且延迟从纳秒攀升至微秒。 Rubin 迁移到 ConnectX-9,每 GPU 速度为 1.6 Tbps,随着每机架纵向扩展域从 72 个 GPU 增长到 576 个 GPU,每 GPU 横向扩展带宽加倍。每个 NIC 旁边都有一个 BlueField DPU,添加 ARM 内核和加速器以减轻主机 CPU 的存储、网络和安全负担。对于更喜欢以太网而不是 InfiniBand的客户, Spectrum-X 是专为人工智能而优化的无损以太网替代方案流量。
从铜缆到玻璃的交叉发生在机架边界。 NVL72 内部的脊柱是铜的;一旦链路必须以 800 Gbps 的速度跨机架,它就是 光纤。无源铜质 DAC 在 200 G/lane 时的最高长度约为 1.5–2 米,远低于跨机架范围,因此今天的 SuperPOD 主干采用 OSFP-RHS 可插拔收发器,每个模块都带有自己的激光器、调制器、光电探测器和 DSP。从光学角度来看,分散到数千个 GPU 的 SuperPOD 主干相当于数万个 可插拔 仅在收发器激光器上就消耗了数十千瓦的功率。
到了 Rubin,光学器件被直接集成进 交换机 ASIC。Quantum-X Photonics(InfiniBand)和 Spectrum-X Photonics(以太网)不再使用可插拔光模块,而是采用 共封装光学(CPO):通过 TSMC COUPE 工艺,把激光器、调制器和光电探测器与交换芯片封装在一起。NVIDIA 表示,与功能相当的 OSFP 可插拔方案相比,这种设计可将激光器数量减少约 4 倍,并将链路功耗降低约 3.5 倍。此前,NVIDIA 已通过 Chiplet 封装把多个 GPU 裸片和 HBM 集成在同一封装内;如今,相同的集成思路进一步延伸到网络层,把计算、内存和光子器件集成到同一系统中。
NVLink Fusion 最近开放了扩展结构本身:第三方 CPU 和 XPU 现在可以加入 NVLink 域,让超大规模厂商可以围绕 NVIDIA 互连构建半定制机架,而无需从头开始设计自己的相干结构。
软件栈
CUDA 是 GPU 的 natural programming model:开发者编写 kernel,由大量 thread 以 block 和 warp 的层次执行,并显式决定 data sharing、synchronization 和 work partition。这个 abstraction 十八年来基本稳定,所以从 2007 年开始编写的 CUDA kernel,今天仍能在 Blackwell 上编译运行。
这种连续性既是护城河也是约束。每一代都会引入新硬件(Tensor Core, TMA, TMEM)到相同的 kernel-and-warps 模型上,在 PTX 和 SASS中作为内在函数公开: mma.sync、 wgmma.mma_async等。 NVIDIA 无法从根本上重新考虑 SM,因为太多代码依赖于它;作为回报,对 CUDA 软件的每一项投资都会在几代人之间复合。
PTX 之上是一个经过二十年构建的堆栈。 cuBLAS 和 cuDNN 用于数学和 DNN 基元; CUTLASS,编码了数十年 GEMM 在模板化 C++ 方面的专业知识; TensorRT-LLM 用于分页注意力、运行中批处理和 speculative decoding;通过 PyTorch进行框架绑定, Triton和 JAX。
FlashAttention是现代人工智能中最重要的算法重写之一,它会集中注意力以避免实现 矩阵。它的四代产品(FA1 到 FA4)均针对最新的 NVIDIA 芯片进行了手工优化(FA3 适用于 Hopper 的异步管道,FA4 适用于 Blackwell),与其他硬件的端口相隔数月或数年。
CUDA 的 moat 不只是 API 本身,更是二十多年积累的 third-party kernel、library、tooling,以及已经掌握这套 programming model 的大量 developer。很多关键 software 并非 NVIDIA 内部完成,但它们共同放大了 CUDA ecosystem 的价值。
NVIDIA 同时提供大量 engineering support。它会把 engineer 直接嵌入 frontier lab 和 hyperscaler 团队,为新 model architecture 编写 kernel,并针对最新 silicon 调优。因此,切换离开 NVIDIA 不只是重写 library 和 kernel,还意味着重新建立团队的 performance mental model,并失去这部分现场 engineering support。
Google TPU
TPU 是一台以 matrix multiplication 为中心的 domain-specific machine。它不追求像 GPU 那样覆盖所有 massively parallel workload,而是把主要 silicon 投入大型 systolic array,再让 XLA 在编译期安排每个 cycle 和每一块 memory。系统没有 hardware thread scheduler 或 cache hierarchy;多个 TPU 通过 ICI 组成 pod,由 compiler 统一生成 SPMD program 和 collective。TPU 的目标很明确:以更高 performance-per-watt 运行 Google 自身的 search、recommendation、translation 和 Gemini workload。
演进路线
架构
TPU 的核心是一台 matmul engine,外围逻辑的主要任务就是持续为它搬运数据。基本计算单元是 TensorCore:v2 之后的旗舰型号每个封装包含两个 TensorCore,v4i、v5e、v6e 等面向能效优化的型号则包含一个。TensorCore 内部由五类单元组成:负责矩阵运算的 MXU、负责 element-wise ops 的 VPU、控制执行流程的 Scalar Unit、执行 cross-lane reduction 的 XLU,以及 Transpose/Permute Unit;accumulator queue 负责向 MXU 输入和排出数据。从 v4 开始,芯片还增加了独立的 SparseCore,专门处理 embedding lookup 这类不适合 systolic array 的 workload。所有单元连接在同一个 VLIW issue plane 上,由 Core Sequencer 每周期发出一个 322-bit bundle。这里没有 I-cache miss、warp scheduler、out-of-order engine 或 branch predictor:compiler 本身就是 scheduler,省下的硅面积用于放置更多 MAC。
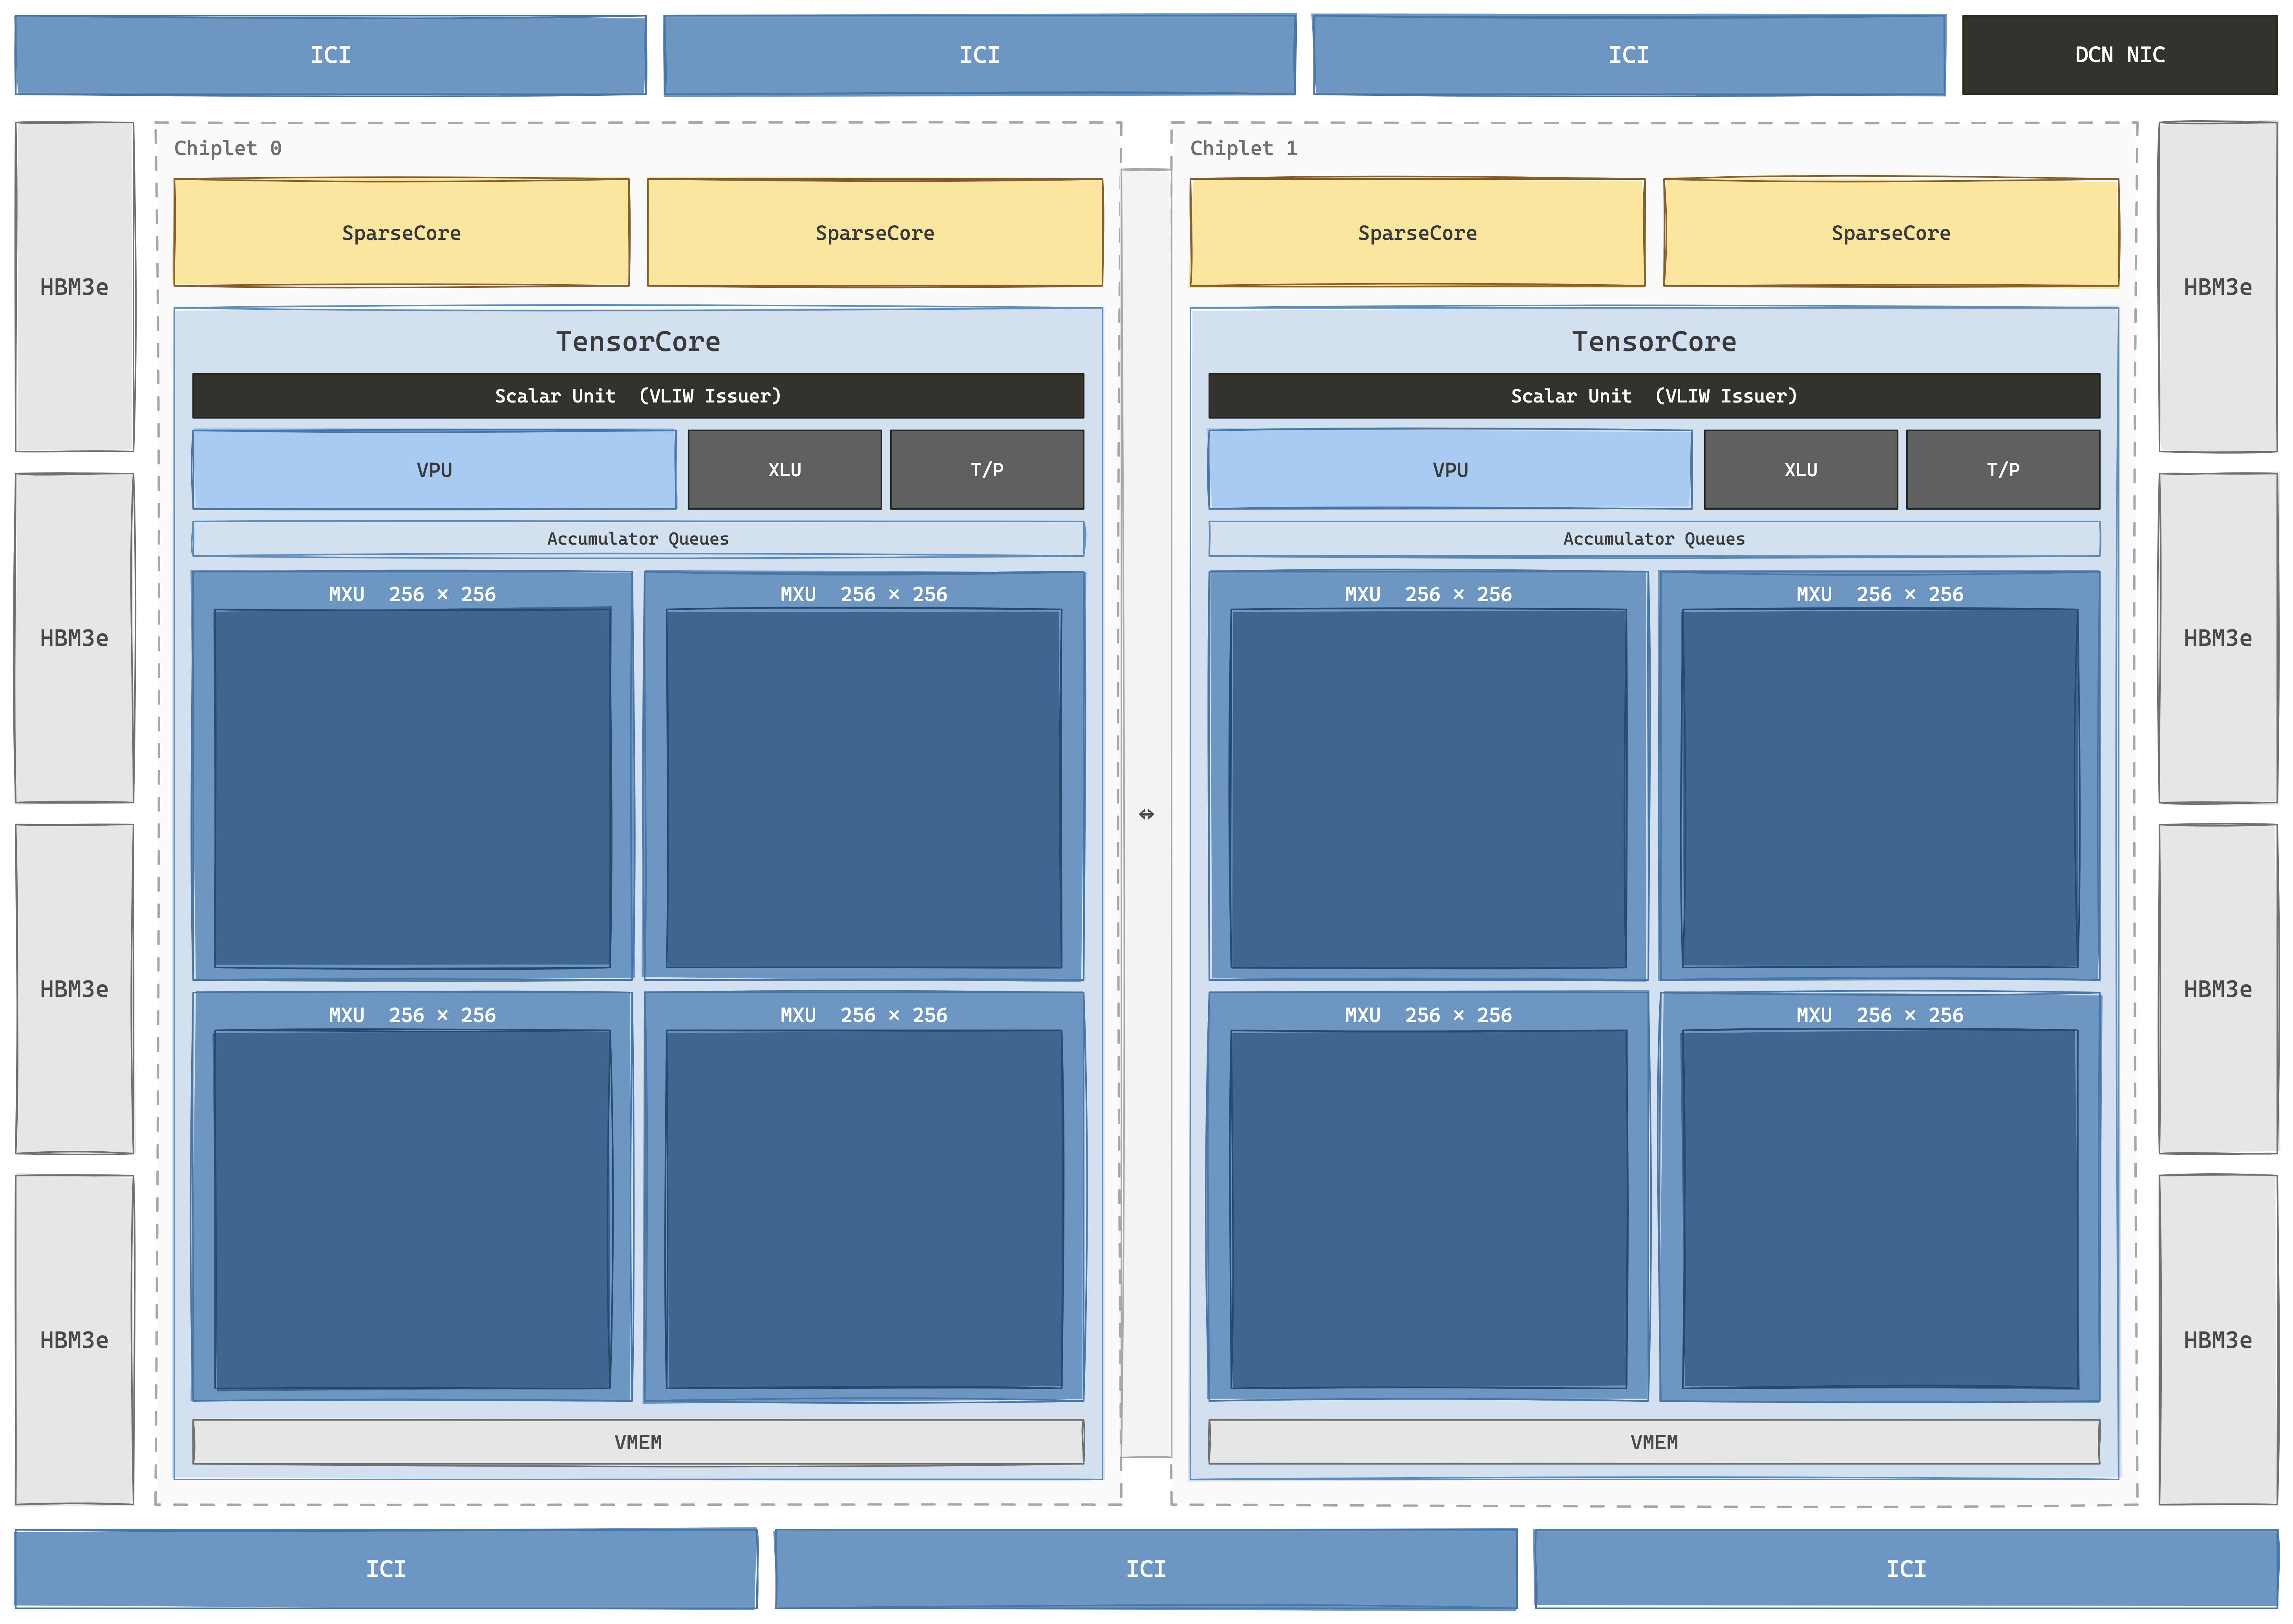
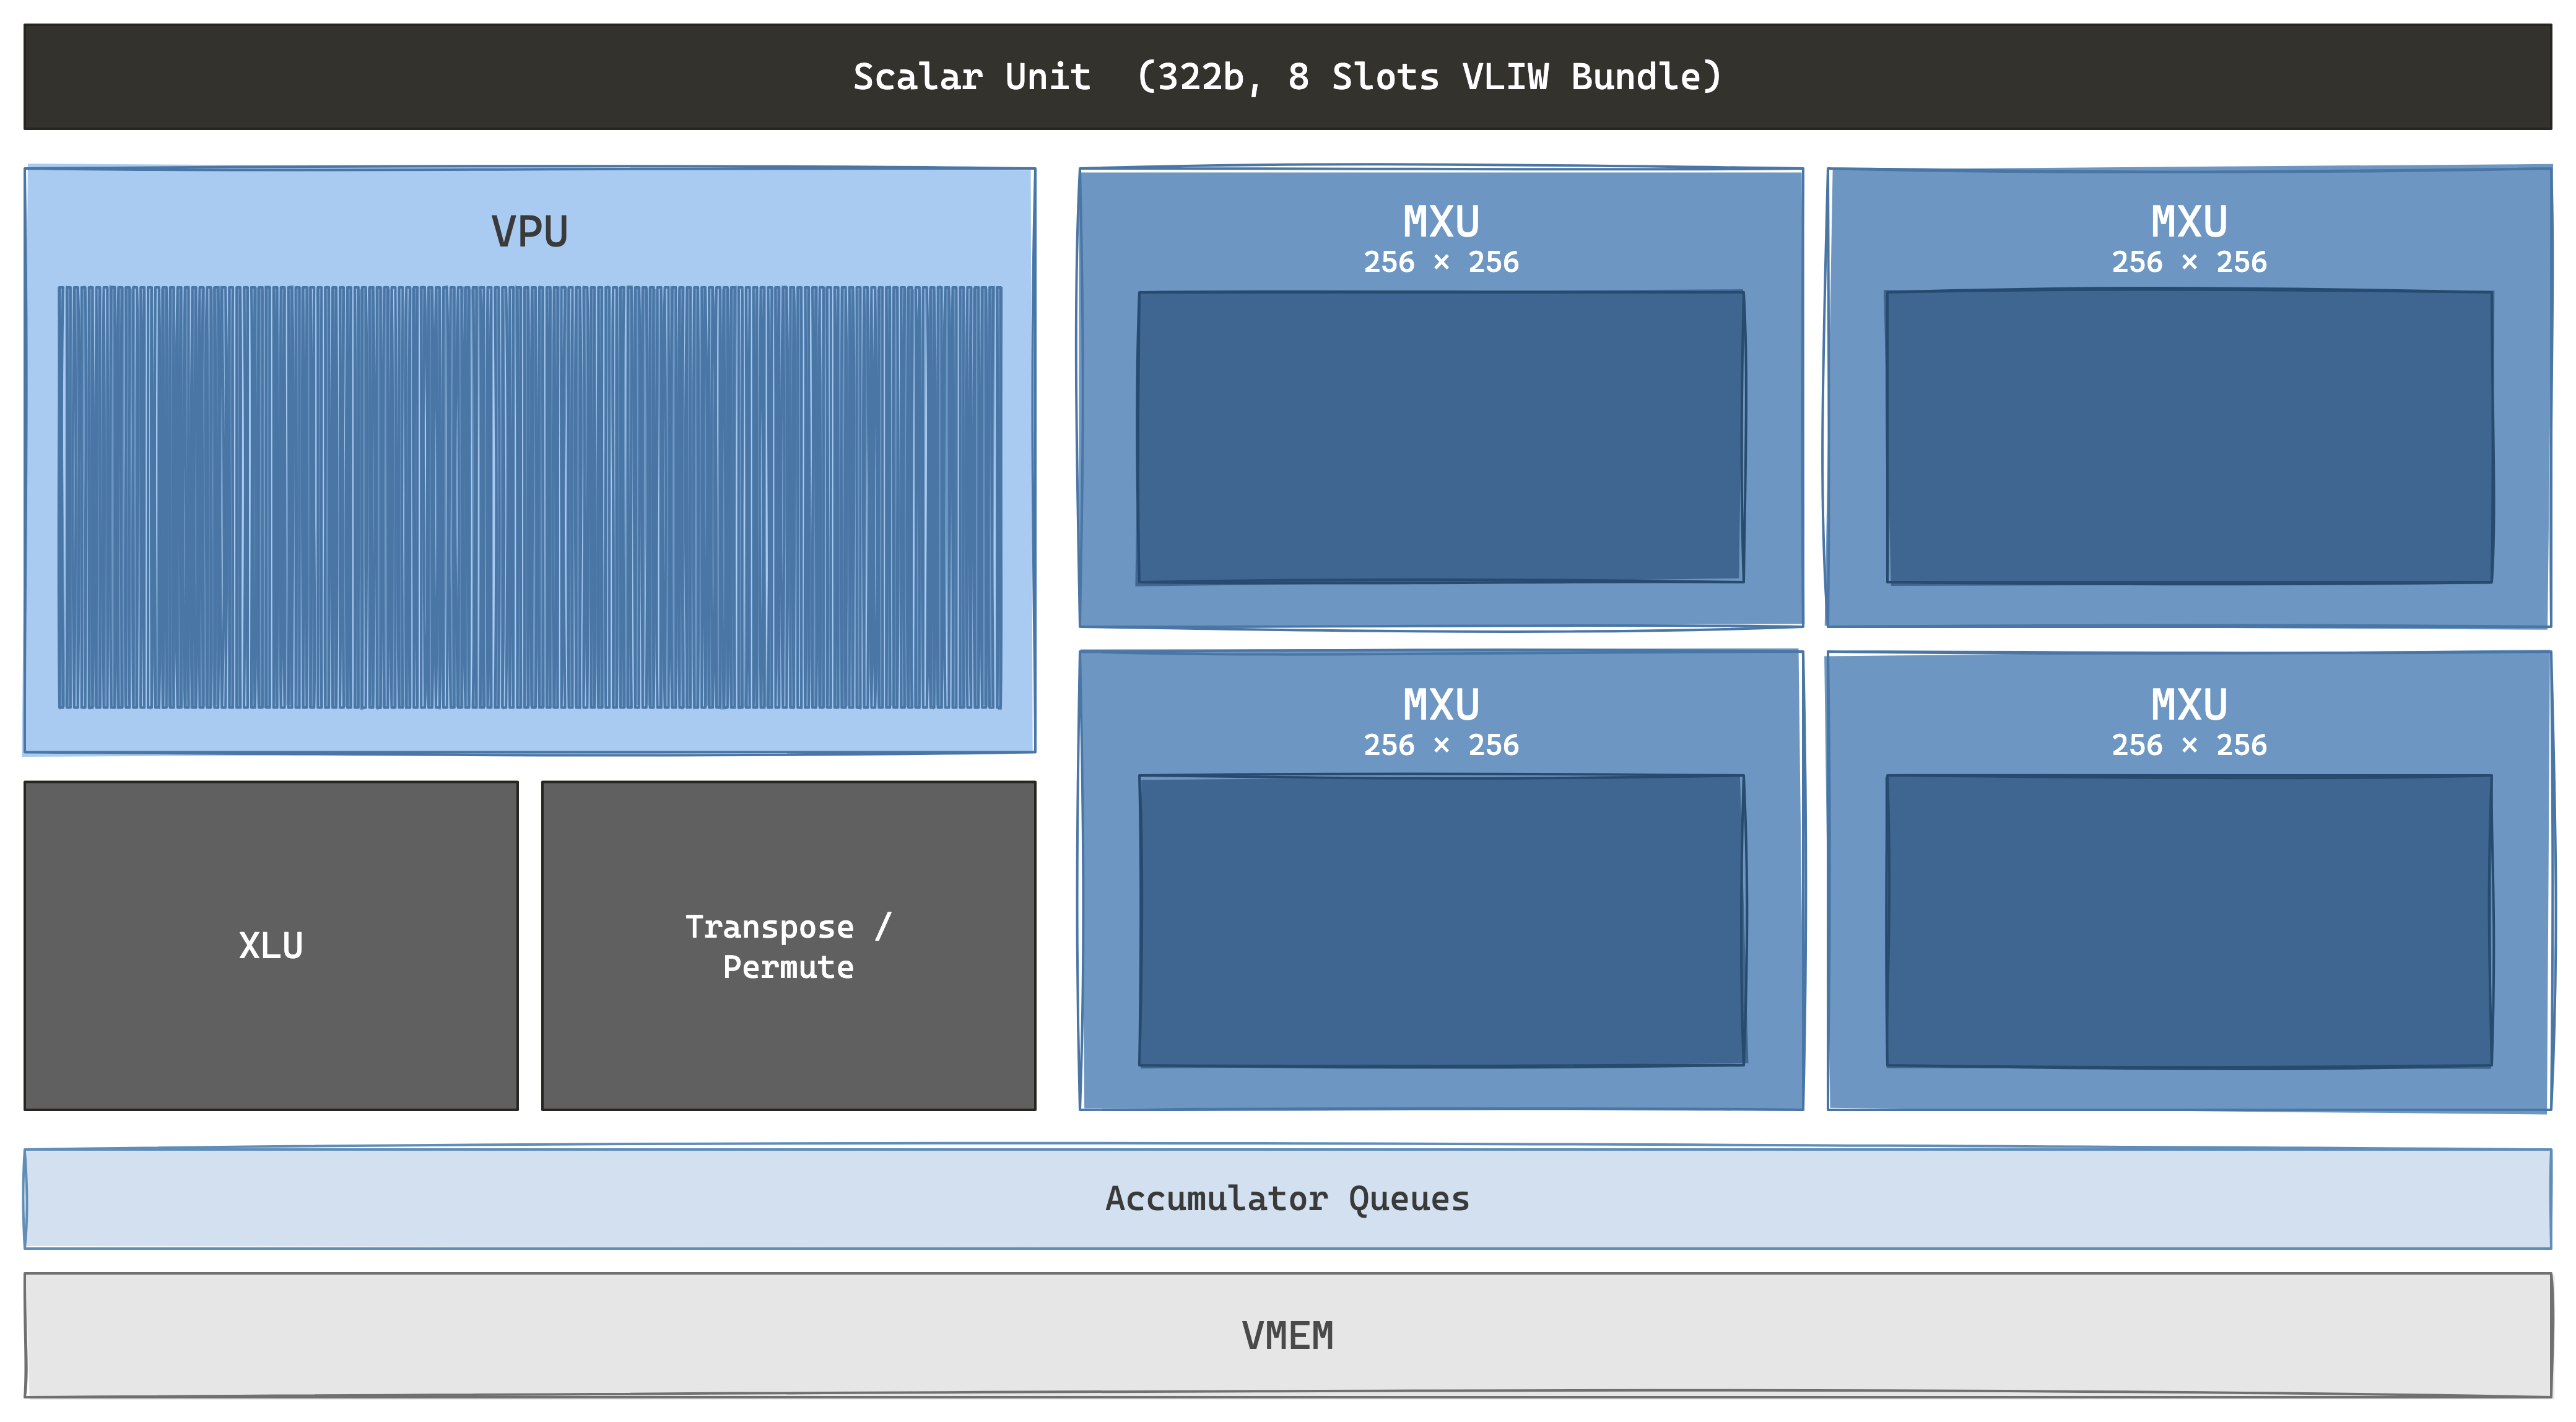
TensorCore
MXU 是脉动阵列。 v1 发货 1 个 256×256 INT8 推理阵列; v2 是第一个具有训练功能的 TPU,并引入了 128×128 个单元, BF16 与 FP32 累积(INT8 在 v4 以同等吞吐量返回到 MXU)。每个 TensorCore 的单元数量从此开始增长: v2 上有 1 个 MXU→ v3 上有 2 个→ 4 上 v4/v5e/v5p。 Trillium 回到 256×256(每个周期每个阵列 65,536 个乘法累加单元),并且 Ironwood、 8t和 8i 都保留了 256×256 形状。
计算矩阵乘法时,矩阵 B 会预先装入 systolic array 的 weight cell,这就是 weight-stationary dataflow。activation 从阵列左侧进入,每周期向右传播一列,与 cell 中驻留的 weight 相乘;partial sum 则向下流入 accumulator queue。数据一旦进入阵列,就不再访问 memory:weight 会被所有经过的 activation 复用,activation 也会沿一整行复用。矩阵乘法本身只消耗几 pJ,访问 memory 的能耗通常高出两个到三个数量级,因此 systolic array 的价值就是把 data reuse 直接做进连线。代价是 array underfill:在 256×256 array 上运行 128×128 matmul 时,75% 的计算单元处于空闲状态,所以 XLA 会把 tile、padding 和 schedule 对齐到 array dimension。
VPU 的算力不如 MXU 醒目,但它是 TPU 微架构中很关键的一部分:TPU 的 VPU 是 2D vector machine,而不是普通的 1D SIMD。VPU register file 保存二维 VREG;以 v4/v5p 为例,其 shape 为 (8, 128),即 128 个 lane、8 个 sublane。lane axis 与 MXU 的输入宽度对齐,sublane axis 则决定 VPU 向 MXU 流式提供 tile 的节奏。现代 TPU kernel 的性能很大程度来自 VPU/MXU overlap:MXU 执行 matmul 的同时,VPU 并行完成 quantization、LayerNorm、Softmax、activation 和 bias add。cross-lane reduction 对 2D vector ISA 很难高效实现,因此交给 XLU;它延迟高、代价大,也是 compiler 中常见的热点。与二维布局不一致的变换则由 Transpose/Permute Unit 处理,避免数据绕行内存。
Scalar Unit 是最小的块,并且可以说是最重要的:一个单 thread、双发出整数 ALU,具有 32 个 32 位寄存器和 4 KiB 的 SMEM 用于控制状态,与保存程序的 Imem 配对。它是唯一执行指令提取的块;每个周期它都会提取一个 322 位 VLIW 包,在本地执行自己的两个 scalar 槽(地址算术、循环计数器、分支、同步寄存器检查),并将剩余的 6 个槽分派到芯片的其余部分:2 个 vector ALU (VPU)、2 个 vector 加载/存储 (HBM↔VMEM DMA),2 个矩阵(推送/弹出 MXU 队列)。块之间的同步是显式的: 同步标志 在 MXU 和 VPU 管道繁忙时进行跟踪,并且编译器插入屏障检查而不是硬件跟踪依赖项。Scalar Unit 使 TensorCore 的其余部分看起来像固定功能数据流:每个周期,由同一个控制点决定八个 functional slot 的行为,并且没有动态 重新排序缓冲区 来撤消错误的决定。
内存
片上内存层次结构与计算端的思路相同: 没有缓存,每个级别均由软件管理。片外为 HBM (v2/v5e 上为 16 GB,v3/v4/v6e 上为 32 GB,v5p 上为 95 GB,Ironwood 上为 192 GB,v8 代上为 216–288 GB),片上是手工堆叠的可明确寻址的 scratchpad 层。最接近计算的是 VMEM,为 VPU 和 MXU 输入队列提供数据的 vector scratchpad,在 v4 上大小为 32 MiB,在 v5e 上大小为 128 MiB,在经过推理调整的 v8i 上扩展到 384 MiB 精确地在芯片上保存整个 KV 缓存 。其上方是 CMEM,随 v4 引入,大小为 128 MiB:HBM 和 VMEM 之间较慢、较大的 SRAM 暂存区域,可吸收 融合操作 中间体。 Scalar Unit 有自己的 SMEM (v4 上的控制状态约为 10 MiB)和一个微小的 scalar register file。程序中的每个张量都会在编译期绑定到确定的存储层级; XLA 的 buffer assignment 跨层调度 DMA ,以便数据恰好在循环之前到达消耗它。硬件不进行预取,不逐出,不存在 一致性;schedule 正确时,数组永远不会停止;schedule 出错时,没有后备路径。
SparseCore
TensorCore 之外最特别的单元是 SparseCore。recommendation/ranking model 的 embedding lookup 具有 irregular、indirect、all-to-all 的访问模式,和 dense matmul 完全不同,并不适合 256×256 systolic array。SparseCore 是专用 dataflow processor,包含 16 个 compute block 和独立的 SPMEM scratchpad,负责 scatter、gather、segmented reduction 以及 embedding sharding 带来的 data-dependent all-to-all。Google 报告它能以约 5% 的 die area 和 power,为 embedding-heavy model 带来 5–7× speedup。v4、v5p 和 Ironwood 每颗芯片有 4 个 SparseCore,Trillium 为 2 个;面向 inference 的 v8i 则移除了 SparseCore,改为在 I/O chiplet 上加入 CAE(Collective Acceleration Engine),针对 decode 中的 collective reduction。
数值格式
TPU v1 为 INT8-仅限推理; v2 将此切换为 BF16 作为规范训练格式:与 FP32相同的动态范围,一半的内存,无 loss scaling 技巧。 v4 重新引入了原生 INT8 支持。 Ironwood 然后添加原生 FP8 支持(E4M3 和 E5M2),吞吐量约为 2 倍 BF16 在同一地区。 v8 添加原生 FP4 加上 MXU 本身内部的 块级乘法 ,这会删除 Ironwood 仍需支付的 VPU 反量化开销。 stochastic rounding 在每个现代 TensorCore 上都受到硬件支持:由作为概率的较低尾数位做出的舍入决策,这保留了长时间训练运行中低精度累积的预期值,并且是让 BF16/FP8 缩小与 FP32 精度差距的小细节之一。
位于芯片边界 ICI 自行移植( 2D-torus 芯片上有 4 个端口 v2/v3/v5e/v6e、 3D-torus 旗舰版 v4/v5p/v7/8t 上的 6 个)以及 DCN NIC 用于横向扩展。从芯片级的角度来看,ICI 端口看起来只是另一组 DMA 引擎 核心定序器 可以在 VLIW 包中定位:远程张量发送与 VMEM 到 HBM 传输是相同的指令类,并且编译器处理 collective 作为同一总体 计划的一部分 它为计算和本地内存构建。
设计取舍
- 脉动阵列。 Matmul 主导工作负载,因此将芯片用于脉动阵列。
- 软件 scratchpad。 计算成本低廉,内存昂贵,因此重用阵列线路中的数据,并用 software-managed scratchpad 替换缓存。
- 编译器调度。 工作负载是静态可预测的,因此将调度移至编译器中:VLIW 问题,否 推测,无乱序,无 动态调度器。
- 押注 4:仅 MAC 芯片。 功率比峰值更重要,因此删除每个不 乘法添加的晶体管:每个缓存标记、每个分支预测器、每个重新排序缓冲区。
- 专用的数组外引擎。 密集的 matmul 数组对于某些实际工作负载来说是错误的形状(嵌入、 collective),因此请开发小型专用引擎(SparseCore、CAE),而不是 warp 主核心以适应它们。
扩展
TPU 的 scale-up 路线与 NVIDIA 不同。NVLink/NVSwitch 提供的是硬件管理的 coherent address space,一颗 GPU 可以直接访问另一颗 GPU 的 HBM;ICI 则是 message-passing fabric,没有 remote load/store semantics,也不提供 cache coherence。所有跨芯片操作都表现为由 XLA 编译的显式 collective。TPU 通过 ICI 把芯片直接连成 2D/3D torus,机架边界再由 Optical Circuit Switch(OCS)重构连接关系,而不是依赖传统 crossbar。
纵向扩展
ICI 链接直接来自 TPU 芯片:高速 串行 lane, 直连铜 位于 64 芯片立方体( 4×4×4 排列,位于一个液冷机架中),光学立方体之间。每芯片聚合 ICI 带宽已从 v2 上的约 250 GB/s 扩展到 1.2 TB/s 双向 Ironwood和 2× 在 v8t上。拓扑按代交替: 2D 环面 ,位于效率调整芯片上(v2, v3、 v5e、 v6e)、 3D 环面 在旗舰产品上(v4, v5p, v7、 v8t)。
Palomar OCS没有 NVIDIA 类似产品: 3D-MEMS Optical Circuit Switch(OCS) 位于立方体之间。微小的镜子通过物理旋转将任何输入光纤映射到任何输出。 v4 superpod 使用 48 个 Palomar 开关将 64 个立方体(4,096 个芯片)连接到一个 3D 环面; v5p 和 Ironwood 扩展了相同的方案。重新配置是毫秒级的,而不是纳秒级的,但这没关系,因为 OCS 是 电路交换:在作业开始时选择一个拓扑,运行一周,然后为下一个工作负载重新配置。三个问题归结为一个组件:每个工作负载的拓扑重新配置(warptorus 优化高达 70% 二分)、子 pod 按需切片 以及 容错 (当芯片失效时, OCS 光学交换到备用立方体中,并且运行继续,而不会丢失 ICI 域)。
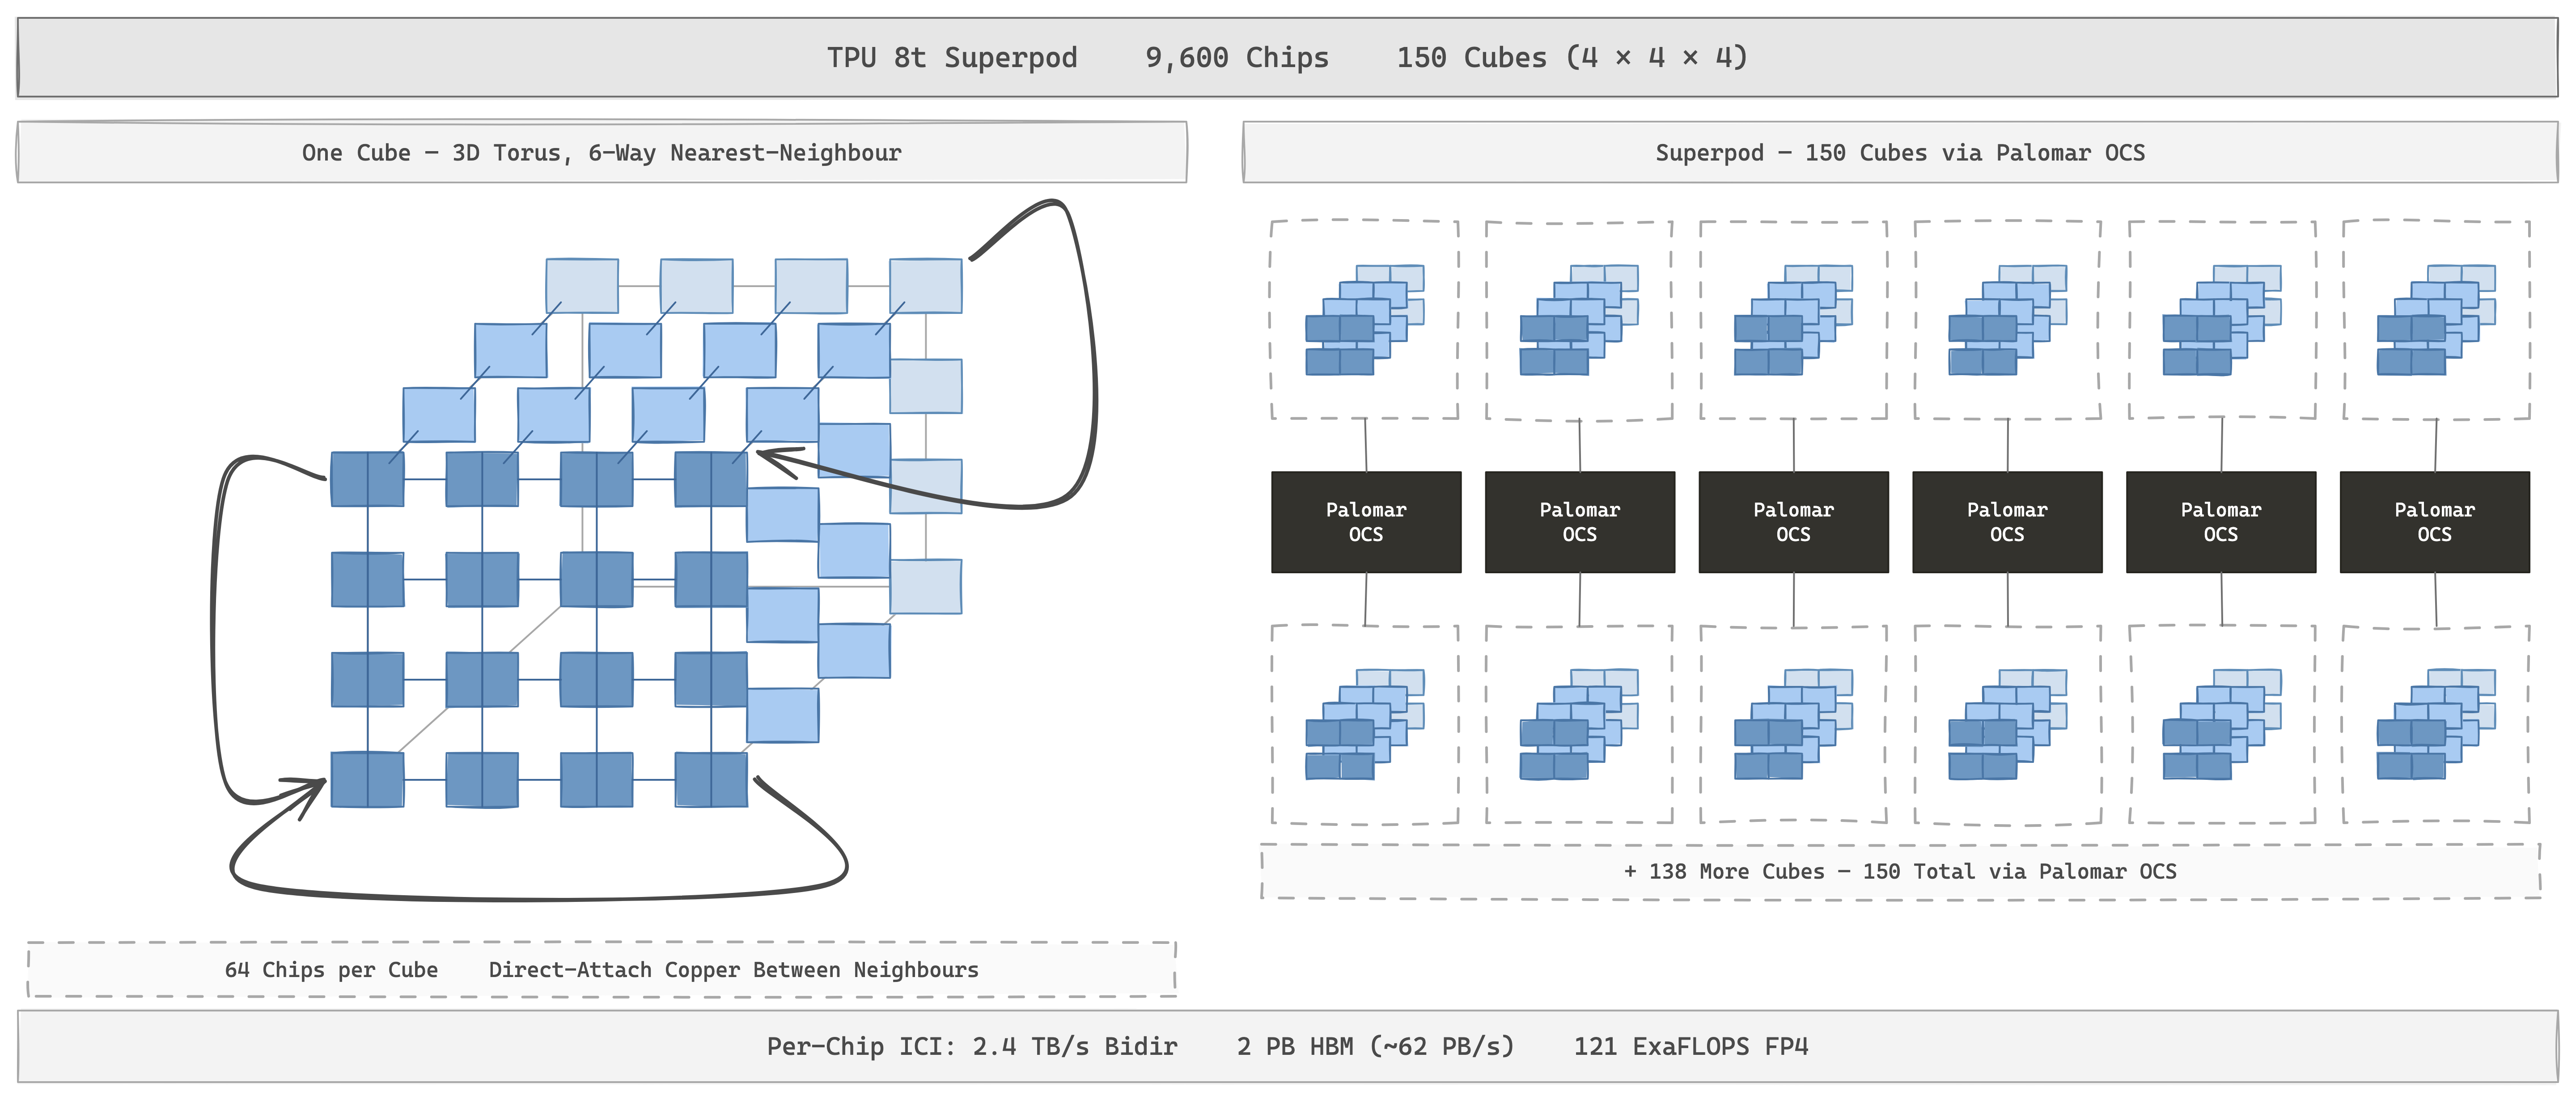
这使得 超级 Pod 扩展单位:相当于 NVIDIA 的 NVL72,大两个数量级。 v4 为 4,096 个芯片; v5p, 8,960; Ironwood (TPU v7) 是 9,216 个芯片,排列为 144 个 64 的立方体,呈现 1.77 PB 的 HBM (~68 PB/s)和 42.5 ExaFLOPS FP8 作为一个连贯的 ICI 域。
TPU 8t (Sunfish) 将其拉伸至 9,600 个芯片、2 PB 的 HBM (约 62 PB/s)和 121 ExaFLOPS FP4。 TPU 8i (Zebrafish) 拥有 1,024 个芯片,约 295 TB 的 HBM (8.8 PB/s) 和 ~10 ExaFLOPS FP4。 8i 用新的分层 高基 拓扑取代了 torus,称为 Boardfly (4 片环 → 8 片组 → 通过 OCS连接最多 36 个组)、切割 all-to-all 延迟减半。这是专为 MoE 推理而设计的。当 collective 是最近邻时,3D 环面表现出色(环 all-reduce 使用每个链接每个周期),但 MoE 专家路由 是相反的模式, all-to-all:每个芯片都向每个芯片发送独特的片段,往返延迟受最长跳对的限制。 1,024 芯片 3D 环面的直径为 16 跳; Boardfly的环 → 组 → OCS 层次结构将其压缩为 7。
横向扩展
通过 TPU v7,横向扩展在单个结构上运行: Jupiter、 自 2022 年起在脊柱上采用全光学 通过 Apollo OCS,与 Palomar相同的 3D-MEMS 系列,在整个建筑中扩展。Google 在从机架到数据中心骨干的每一层都使用相同的原语(光电路交换);这是其他人没有的建筑特征。 Jupiter 今天每颗 二分 承载着 13 Pb/s
使用 TPU 8t,横向拆分为两个结构。东西向 TPU 到 TPU 流量移至 Virgo,专用加速器结构; Jupiter 保留了 南北 角色:存储访问、通用计算、和站点间缩放。 Virgo 是 扁平, 两层、 非阻塞 拓扑构建于 high-radix 开关:每个 TPU 最多有两个开关。一个 Virgo 集群链接 134,000+ TPU 8ts,47 Pb/s 的 二分 (每芯片带宽的 4 倍,降低 40% 卸载延迟 比上一代 DCN 一代), 多平面故障隔离 和 亚毫秒遥测 让调度程序在破坏步骤之前杀死落后者。架构的回报是,每一层现在都可以独立发展:纵向扩展、东西横向扩展,前端可以以不同的节奏进行迭代,而无需重新连接其他层。
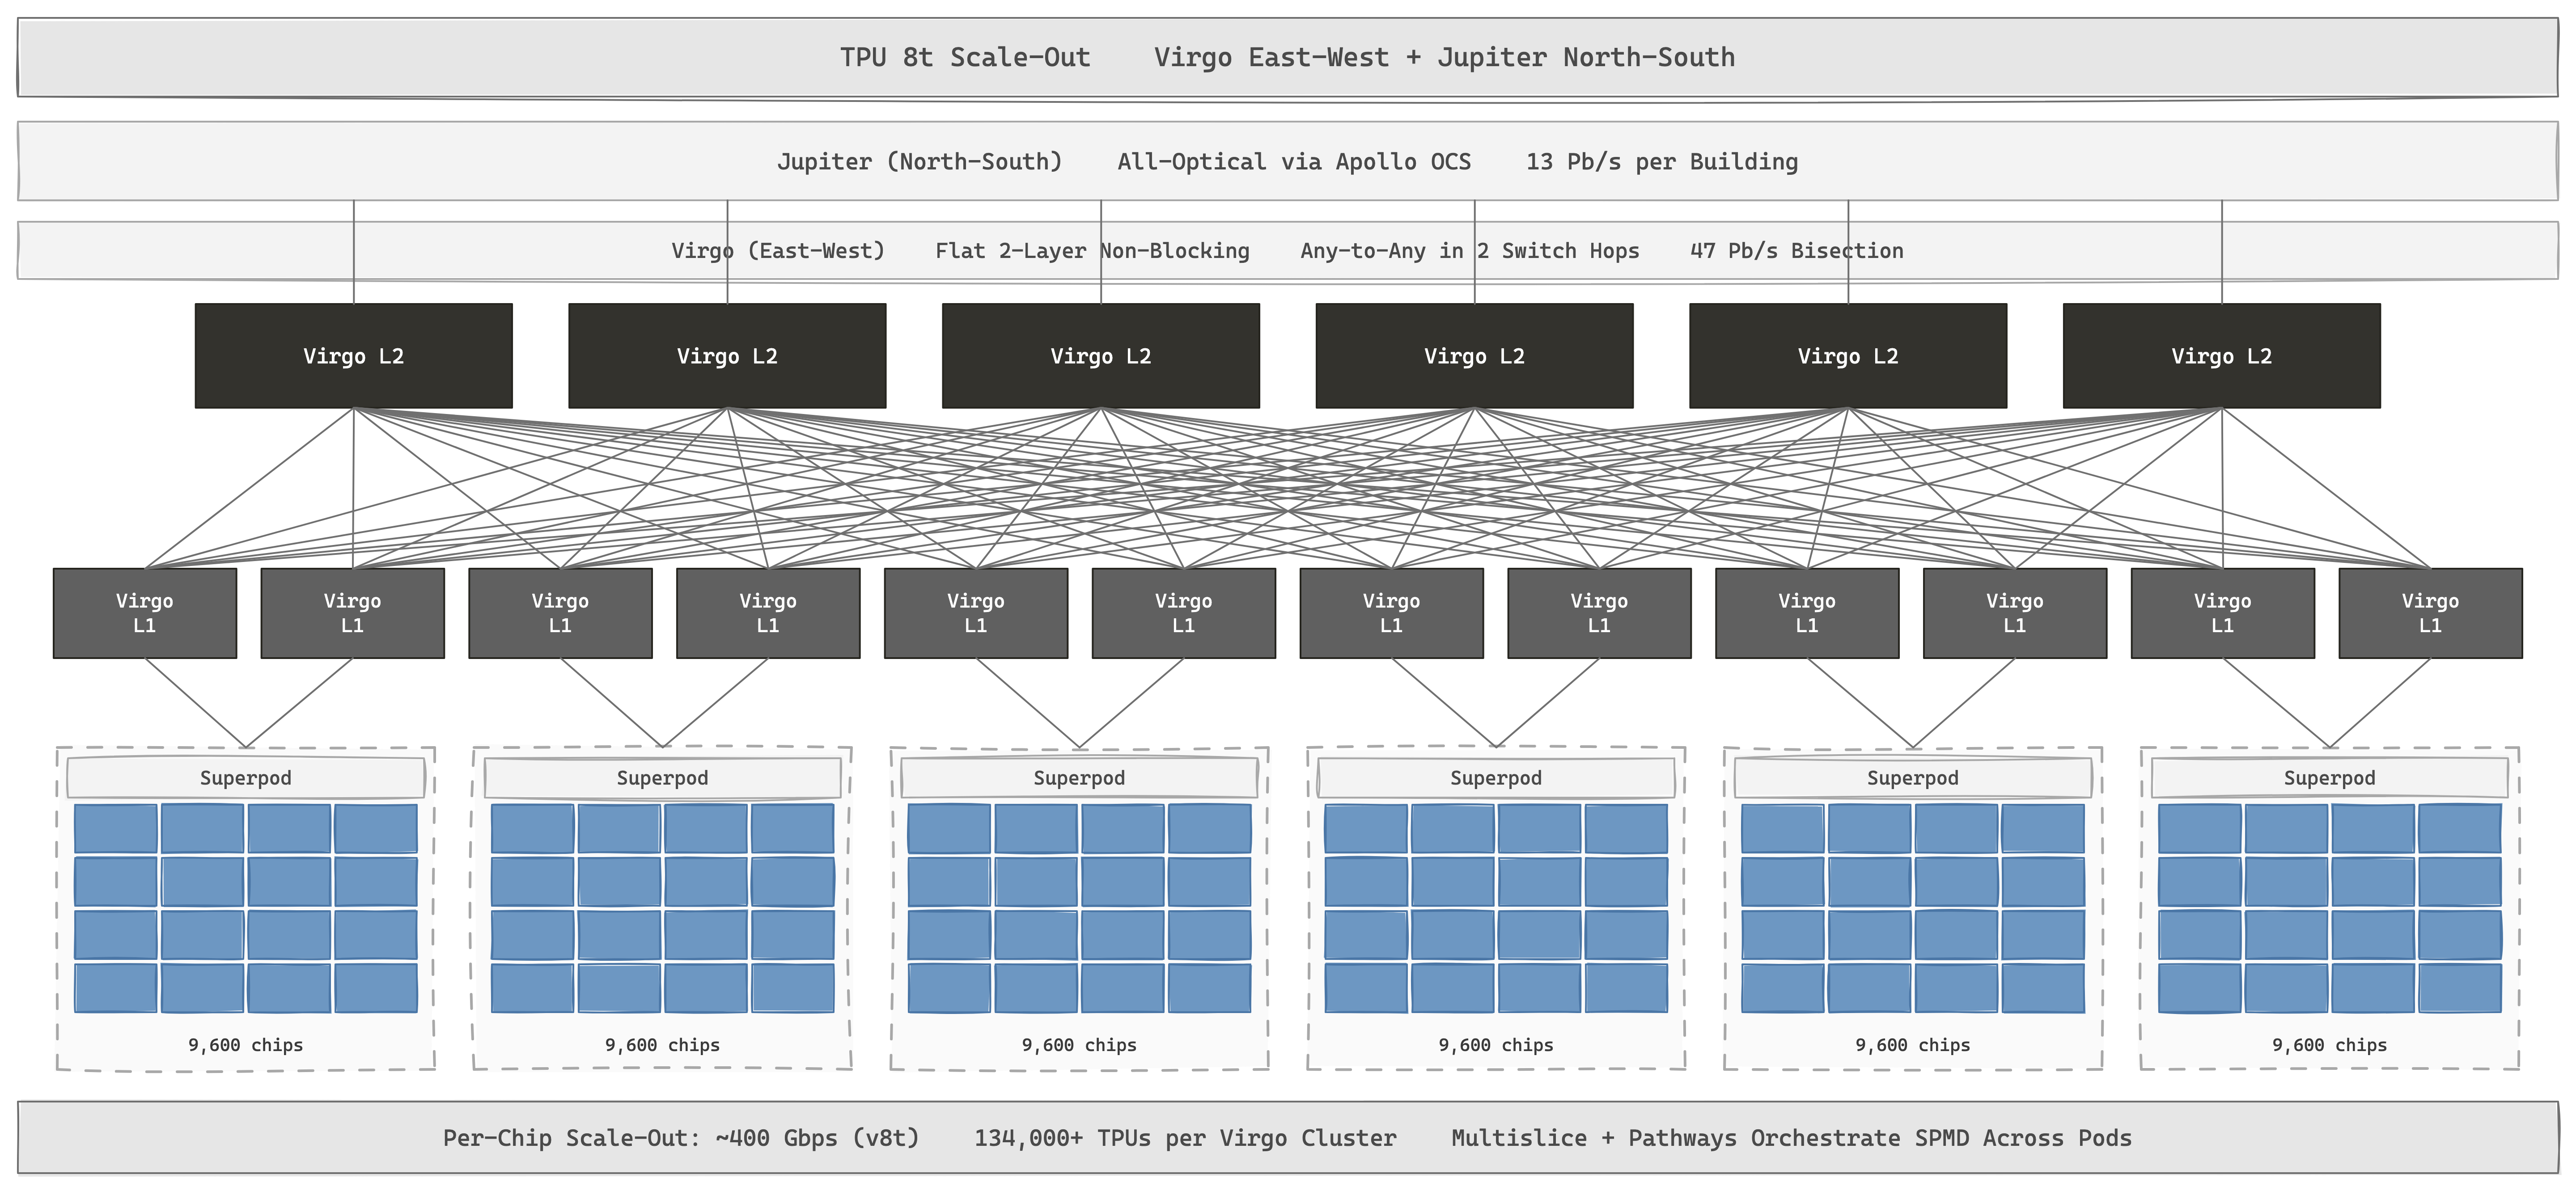
每芯片横向扩展带宽在 Ironwood 上约为100 Gbps, 4× 在 v8t上,但仍然比每芯片 ICI小两个数量级。这种带宽差距决定了分区: tensor parallel 性 和 MoE 专家路由 留在内部 ICI; 数据并行 和 管道并行性 跨横向扩展结构。
Google 的 Multislice 框架,深入 XLA,让单个 SPMD 程序跨越多个 在不同的 pod 中切片;编译器在每个切片内 issue hierarchical collective (ring all-reduce , higher-level reduction )。该结构正是隐藏 ICI/DCN 的技巧 带宽差距:在快速 ICI 上,尽可能多的工作保留在片内,仅留下跨片剩余部分来支付慢速结构成本。
更上层是 Pathways。传统 NCCL + Slurm + Megatron 系统通常由多个 controller 驱动 SPMD job;Pathways 则由单个 client 统一控制,并把多个拥有独立 ICI domain 的 pod 虚拟化成一台逻辑机器。它负责 gang scheduling、elastic training 和跨 region orchestration:某个 slice 失败后,OCS 可以重构 topology,Pathways 再从 checkpoint 在新 topology 上恢复。Gemini Ultra 是首批跨多个数据中心训练的 frontier model,Pathways 将这些数据中心组织成一个同步 SPMD job。
理念: 编译器是调度器,环面是拓扑,光开关是通用可重构器底层,位于从机架到数据中心的每一层。
软件栈
TPU software stack 是 compiler-driven,而 CUDA 更偏 kernel-driven。GPU developer 通常直接编写或调用 kernel,compiler 主要做局部优化;TPU developer 在 JAX 中描述数值程序,XLA 则负责下层大部分决策:op fusion、tensor residency、2D VREG layout、HBM↔VMEM DMA、VLIW bundle schedule,以及跨数千颗 chip 的 sharding。TPU 没有 warp scheduler、cache 或 out-of-order engine 来掩盖坏 schedule,compiler 本身就是 system。它的优势是自动化程度高,更容易接近整体 performance ceiling;代价是当自动生成结果仍有差距时,手工补齐最后一段性能更困难。
compile path 是 JAX → JAXpr → StableHLO → HLO → LLO → VLIW bundle。JAX 把 Python function trace 成 typed functional IR(JAXpr),再 lower 到 StableHLO;XLA ingest StableHLO/HLO 后执行 op fusion、layout assignment、buffer assignment 和 SPMD partitioning。随后 TPU backend lower 到 LLO,并生成最终 VLIW stream。一个高质量 schedule 会在同一时间窗口中 overlap MXU matmul、VPU element-wise ops 和 HBM↔VMEM DMA,从而让 compute engine 与 memory pipeline 同时保持 busy。
TPU 的 multi-chip execution 采用 SPMD:所有芯片运行同一个 program,但各自处理不同 shard,并通过 hierarchical collective 交换数据。GSPMD(现在逐步由 Shardy 取代)会根据用户在 Mesh 和 PartitionSpec 中给出的少量 sharding annotation,把 partitioning 传播到整张 graph,并在需要的位置插入 all-reduce、all-gather 和 reduce-scatter。如果 compiler 选择的 collective 或 layout 不理想,开发者可以使用 shard_map 编写显式 per-device code,手动指定 local shape 和 collective,同时仍然保留外围的 automatic partitioning。这与 FSDP/DeepSpeed 的抽象边界不同:后者主要在 runtime 和 module boundary 上包装 model,GSPMD/Shardy 则由 compiler 对 whole graph 做 partition。
Pallas 是 JAX 在 TPU 上的 kernel escape hatch,作用大致对应 GPU 上的 Triton。Pallas kernel 用 JAX 风格的 Python 编写,经基于 MLIR 的 Mosaic lower 到 LLO,再作为 custom op 嵌回 HLO。它解决的是 XLA 不擅长自动生成的 schedule-sensitive kernel,例如新的 attention variant、fused MoE schedule,以及需要手动控制 VMEM tiling 和 DMA 的 FlashAttention-class 优化。Mosaic GPU 使用同一套前端面向 H100/Blackwell,因此 kernel author 可以复用编程模型。更上层仍是 JAX 原生生态:Flax NNX、Optax、Orbax、Grain、Tunix、Qwix,以及用于 LLM 的 MaxText 和用于 diffusion model 的 MaxDiffusion。
PyTorch 确实可以运行在 TPU 上,但目前不是 TPU 的主力编程栈,成熟度和覆盖面都低于 JAX。torch_xla 使用 LazyTensor 记录 PyTorch operation,并在 step boundary 把 graph 交给 XLA 编译;compiled artifact 会按 graph shape hash 缓存。PyTorch/XLA 2.x 已加入 GSPMD-style sharding annotation、torch.compile backend 和 JAX bridge,graph capture 的开销也明显下降。不过,JAX primitive 与 StableHLO 的映射更直接,对复杂 parallel strategy 的支持也更完整,因此 TPU 上的大规模 training 和 inference stack 仍以 JAX/XLA 为中心。
与 CUDA 相比,TPU ecosystem 更集中:XLA、JAX、Flax、Optax、Pallas、MaxText、Pathways、Shardy、Mosaic 等关键组件大多由 Google 主导,并与 hardware 同步演进。它缺少 CUDA 数十年积累的大量 third-party kernel,因此遇到非典型 workload 时灵活性较弱;但当 workload 与 Google 自身模型相似时,chip、ICI、OCS、compiler、runtime 和 model stack 可以一起 co-design。Ironwood 所谓的“co-designed AI stack”指的正是这种整体交付方式。Triton 与 torch.compile 正在缩小不同平台的编程差异,但抽象边界仍很清楚:在 TPU 上 compiler 是主要接口;在 GPU 上,compiler 只是众多接口之一。
AMD GPU
AMD Instinct 与 NVIDIA 的关注点不同。NVIDIA 持续在每一代 SM 内加入新的 Tensor Core primitive、async mechanism 和 memory tier;AMD 则让 CU microarchitecture 相对稳定,把更多 engineering effort 投向 package、memory capacity 和 open ecosystem。CDNA 3 很早就采用 XCD/IOD chiplet 与 3D stacking,MI300A 又把 CPU 与 GPU 放入 coherent HBM address space;HBM capacity 也长期是 Instinct 的优势。software 侧,AMD 选择 ROCm、HIP、Triton、OCP MX 和 UALink 等开放接口,试图用 open stack 缩小 CUDA ecosystem 的差距。
演进路线
架构
| AMD | NVIDIA |
|---|---|
| 计算单元(CU) | Streaming Multiprocessor(SM) (SM) |
| SIMD | SM 子分区 |
| SIMD lane | CUDA Core (FP32 ALU) |
| 波前 (wave64) | warp (warp32) |
| Matrix Core | Tensor Core |
| MFMA | mma.sync / wgmma / tcgen05.mma |
| VGPR / SGPR | register file |
| LDS(本地数据共享) | SMEM(共享内存) |
| Infinity Fabric | NVLink |
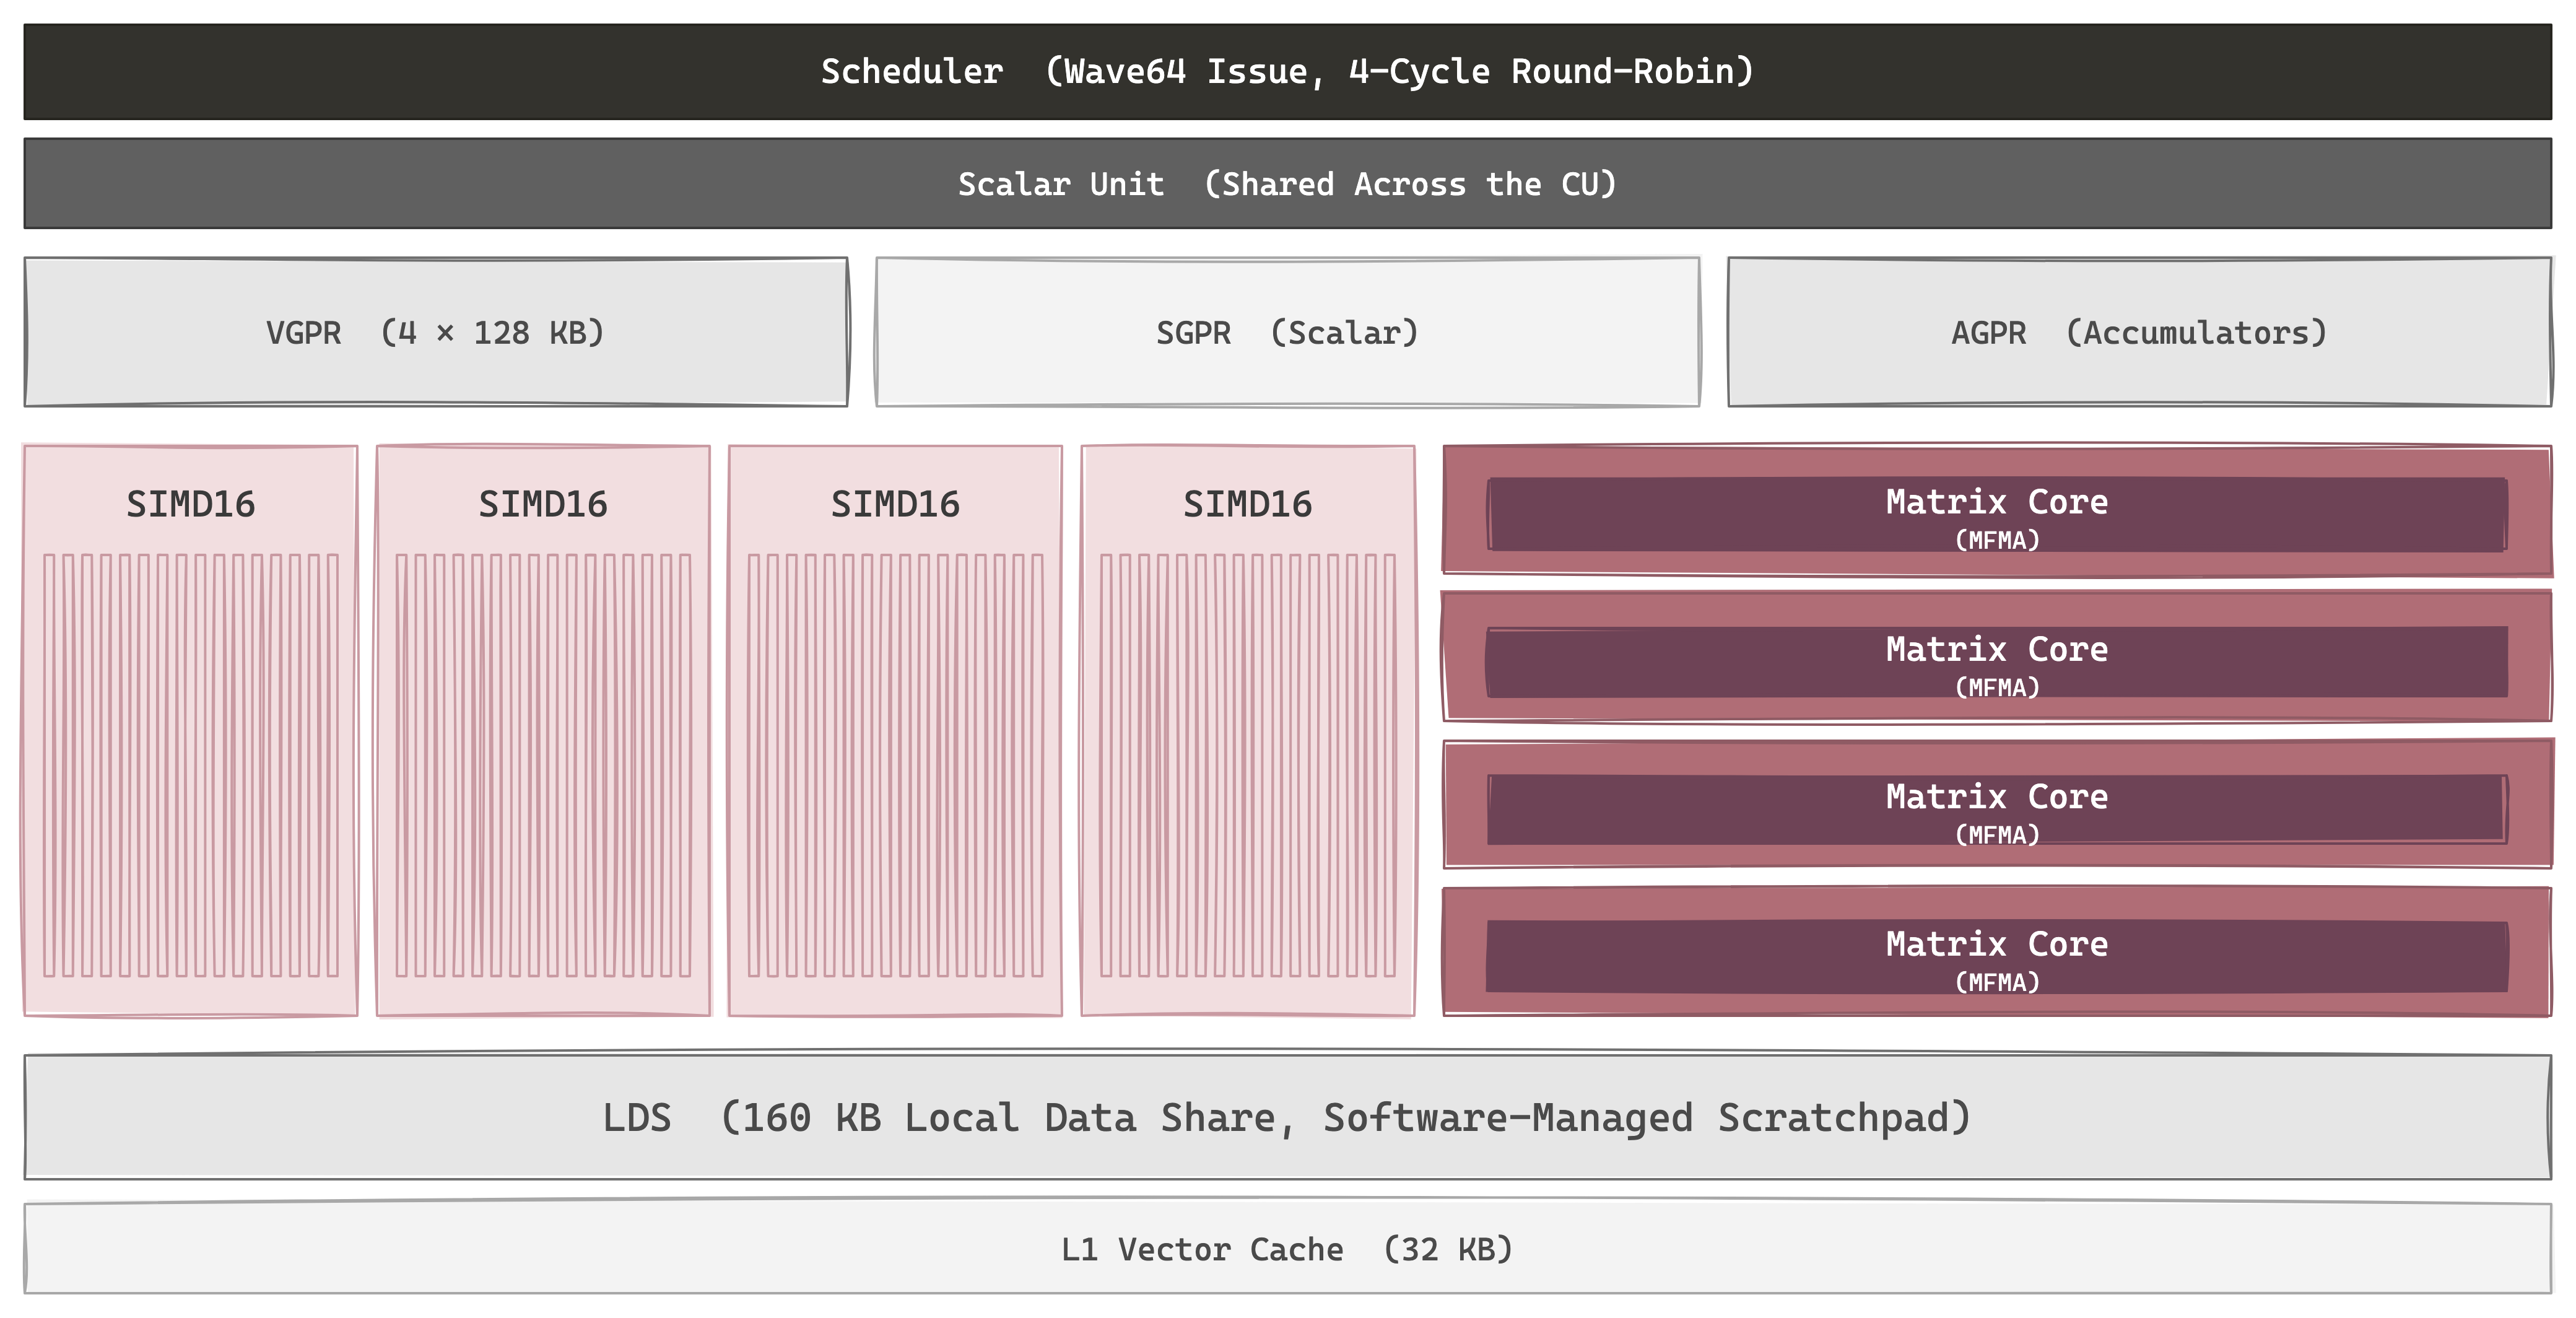
NVIDIA 的主要创新集中在 SM 内部:每一代都会增加新的 Tensor Core primitive、async data movement 机制和 operand storage。AMD CDNA 的重点则更多位于 CU 之间——如何把更多 CU、HBM 和 I/O die 组合成一个 coherent package。CU 本身相对稳定:四个 SIMD16、共享 Scalar Unit、LDS、L1 vector cache、VGPR/SGPR,以及执行 MFMA 的 Matrix Core。wave64 会在四个 cycle 内流过 16 条 SIMD lane,scheduler 在多个 resident wavefront 之间切换以隐藏 stall。CDNA 真正快速变化的是 CU 之外的 packaging 和 memory system。
计算
CU 内部、SIMD 和 Matrix Core 并排运行。四个 SIMD 按元素处理所有内容:激活、标准化、残差、地址算术。 Matrix Core 处理 matmul。拆分与 NVIDIA 的 CUDA Core / Tensor Core 拆分相同,但矩阵抽象具有沿着一条截然不同的曲线发展。
NVIDIA Tensor Core 的 issuer scope 一直在变化:Volta 由 32-thread warp 发射,Hopper 扩展到 128-thread warp group,Blackwell 又推进到 single-thread async issue,并支持 two-SM cluster。AMD Matrix Core 的抽象则更稳定:从 MI100 到 MI355X,MFMA 始终是 wavefront-scoped,一整个 wave64 共同发射 V_MFMA_*,operand 来自 VGPR,accumulator 通常位于 AGPR。instruction latency 和支持的 datatype 持续变化,但 issuer scope 没有改变。CDNA 4 增加了面向 MFMA 的 LDS transpose load,使 operand 以目标 layout 直接送入 Matrix Core;它在功能上有些类似 TMA,但 MFMA 本身仍由整个 wavefront 发射。
吞吐量数字直接说明了格式的情况。 CDNA 1 于 2020 年推出,采用 FP32 / FP16 / BF16 / INT8,每个 CU 每个周期 256 / 1024 / 512 / 1024 FLOP,具有原生 BF16 与 A100一起支持。 CDNA 2 是 FP64 的两倍 通往 256 FLOPs/CU/cycle 的全速率矩阵的路径:AMD 独有的,将 MI250X 放入 Frontier的押注。 CDNA 3 在 FP8 上与 H100 达到同等水平 在 4,096 次浮点运算 (E4M3 + E5M2) 时,添加了 2:4 structured sparsity,并添加了 TF32- 通过截断尾数以 FP64 矩阵速率运行 FP32 matmul 的等效路径。 cDNA 4 再次翻倍 FP4 16,384 FLOPs 和 FP6,具有 OCP MX 块缩放,并在一个 MFMA 中添加了可混合的 A/B 精度:FP8 × FP4,例如。同一代将每个 CU FP64 吞吐量减半,这是第一款用 HPC 密度换取 AI 密度而不是两者兼而有之的 AMD 芯片。
波前范围决策体现在两种成本上。
分歧。 半空 wave64 浪费 32 个 lane,而半空 warp32 浪费 16 个 lane。对于控制流基本一致的工作负载来说,这是一个很小的代价;
重叠。 NVIDIA 的异步、描述符驱动的 matmul 将问题与执行分离:发出 thread 触发指令并继续; Tensor Core 在后台运行; warp 可以运行 softmax、应用掩模或在前一个 matmul 仍在运行时预加载下一个 tile。 AMD 的波前集体 MFMA 没有给 Wave 提供等价物:发出 matmul 的同一波在待处理时无法同时进行有意义的 vector 工作。重叠可以跨越 单独的 波前,但必须在具有明确波前屏障的软件中进行,这更脆弱并且消耗更多的波槽和寄存器。
这种差异的重要程度取决于 workload。pure dense GEMM 中,matrix engine 已经饱和,matmul 周围几乎没有其他工作可 overlap,因此 AMD 的 wavefront-scoped MFMA 并不会吃太大亏,这也是 AMD 在 HPC workload 上长期强势的原因。FlashAttention-3/4 则不同:matmul、Softmax、mask 和 KV Cache load 必须紧密交错,async overlap 就是 kernel 的核心结构。MoE routing、paged attention 和 speculative decoding 也属于这一类 irregular workload。AMD 可以用 software pipeline 重建 overlap,但需要更多 hand-tuning,且通常落后于 NVIDIA 新 hardware primitive 的支持节奏。
NVIDIA 的矩阵指令抽象在各代中得到了进一步发展(warp → warp-group → 单 thread 异步 + 集群),而 AMD 却没有跟进。
内存
AMD 的内存层次结构 更少 比 NVIDIA 的通用层,具有 NVIDIA 根本没有的巨型缓存。从 CU 向外:一个 64 KB LDS scratchpad(软件管理、32 个库、AMD 的 NVIDIA 的 SMEM),一个 vector L1(早期 CDNA 上为 16 KB,从 MI300X 开始为 32 KB),每XCD 几 MB 的 L2。不过,L2 在 XCD 之间并不一致;一致性发生在 L2 之上的一层。
该层是 Infinity Cache:MI300X 上为 256 MB,分布在四个 IOD,16 路组关联,测得约 12 TB/s,是 MI300X 5.3 TB/s 的两倍多 HBM3。它起源于 RDNA 游戏 GPU,以补偿狭窄的 GDDR 总线; AMD 在 CDNA 3 上重用了 AI 的 IP,其中注意力 KV 重用和权重重用非常适合大型 LLC。 NVIDIA 押注于更大的 HBM 带宽( B200 上为 8 TB/s,在 Rubin 上使用 HBM4 进行缩放),AMD 则押注于缓存。
片外 HBM 容量大幅增长: MI100 上的 32 → 64 → 128 → 192 → 256 → 288 GB / MI210 / MI250X / MI300X / MI325X / MI350X,从 2021 年起的每一代产品均达到或超过当代 NVIDIA 旗舰产品。押注是推理工作负载越来越受到容量限制,并且具有更多内存的芯片会获胜。
数值格式
格式轨迹跟踪 AI 芯片中每个人共享的精度减半模式:FP32 → FP16 → FP8 → FP4,每一步恢复精度更细粒度的缩放。 AMD 特定的轴是 开放性。 CDNA 4 的 FP4 和 FP6 使用 OCP MX 块级乘法:与 Blackwell的 MXFP4 和 TPU v8 的 MXU 相同的数字格式,但由开放联盟(AMD、NVIDIA、Intel、Meta、Microsoft、高通、ARM)是 AMD 帮助创建的,而不是由任何单一供应商创建的。 MI355X 中提供的格式与 B200 和 TPU v8 中提供的格式相同。
CDNA 4 变形值得拥有自己的行:每 CU FP64 吞吐量减半。 MI300X 集训练、HPC、推理为一体; MI355X 首先是一颗 AI 芯片。为 Frontier 提供动力的全速率 FP64 矩阵押注尚未被淘汰,但它不再承载权重。
Chiplet
在包装上,CDNA 不再像 NVIDIA,而是开始变得不同。
CDNA 1 的 MI100 是整体式的 7 纳米。 CDNA 2 的 MI250X 是 AMD 首款多芯片 GPU:两个 Aldebaran GCD 并排位于 2.5D EFB 有机基板上,由 4 个封装内 Infinity Fabric 链路连接,聚合速度为 400 GB/s,但作为两个单独的 GPU 提供给软件。
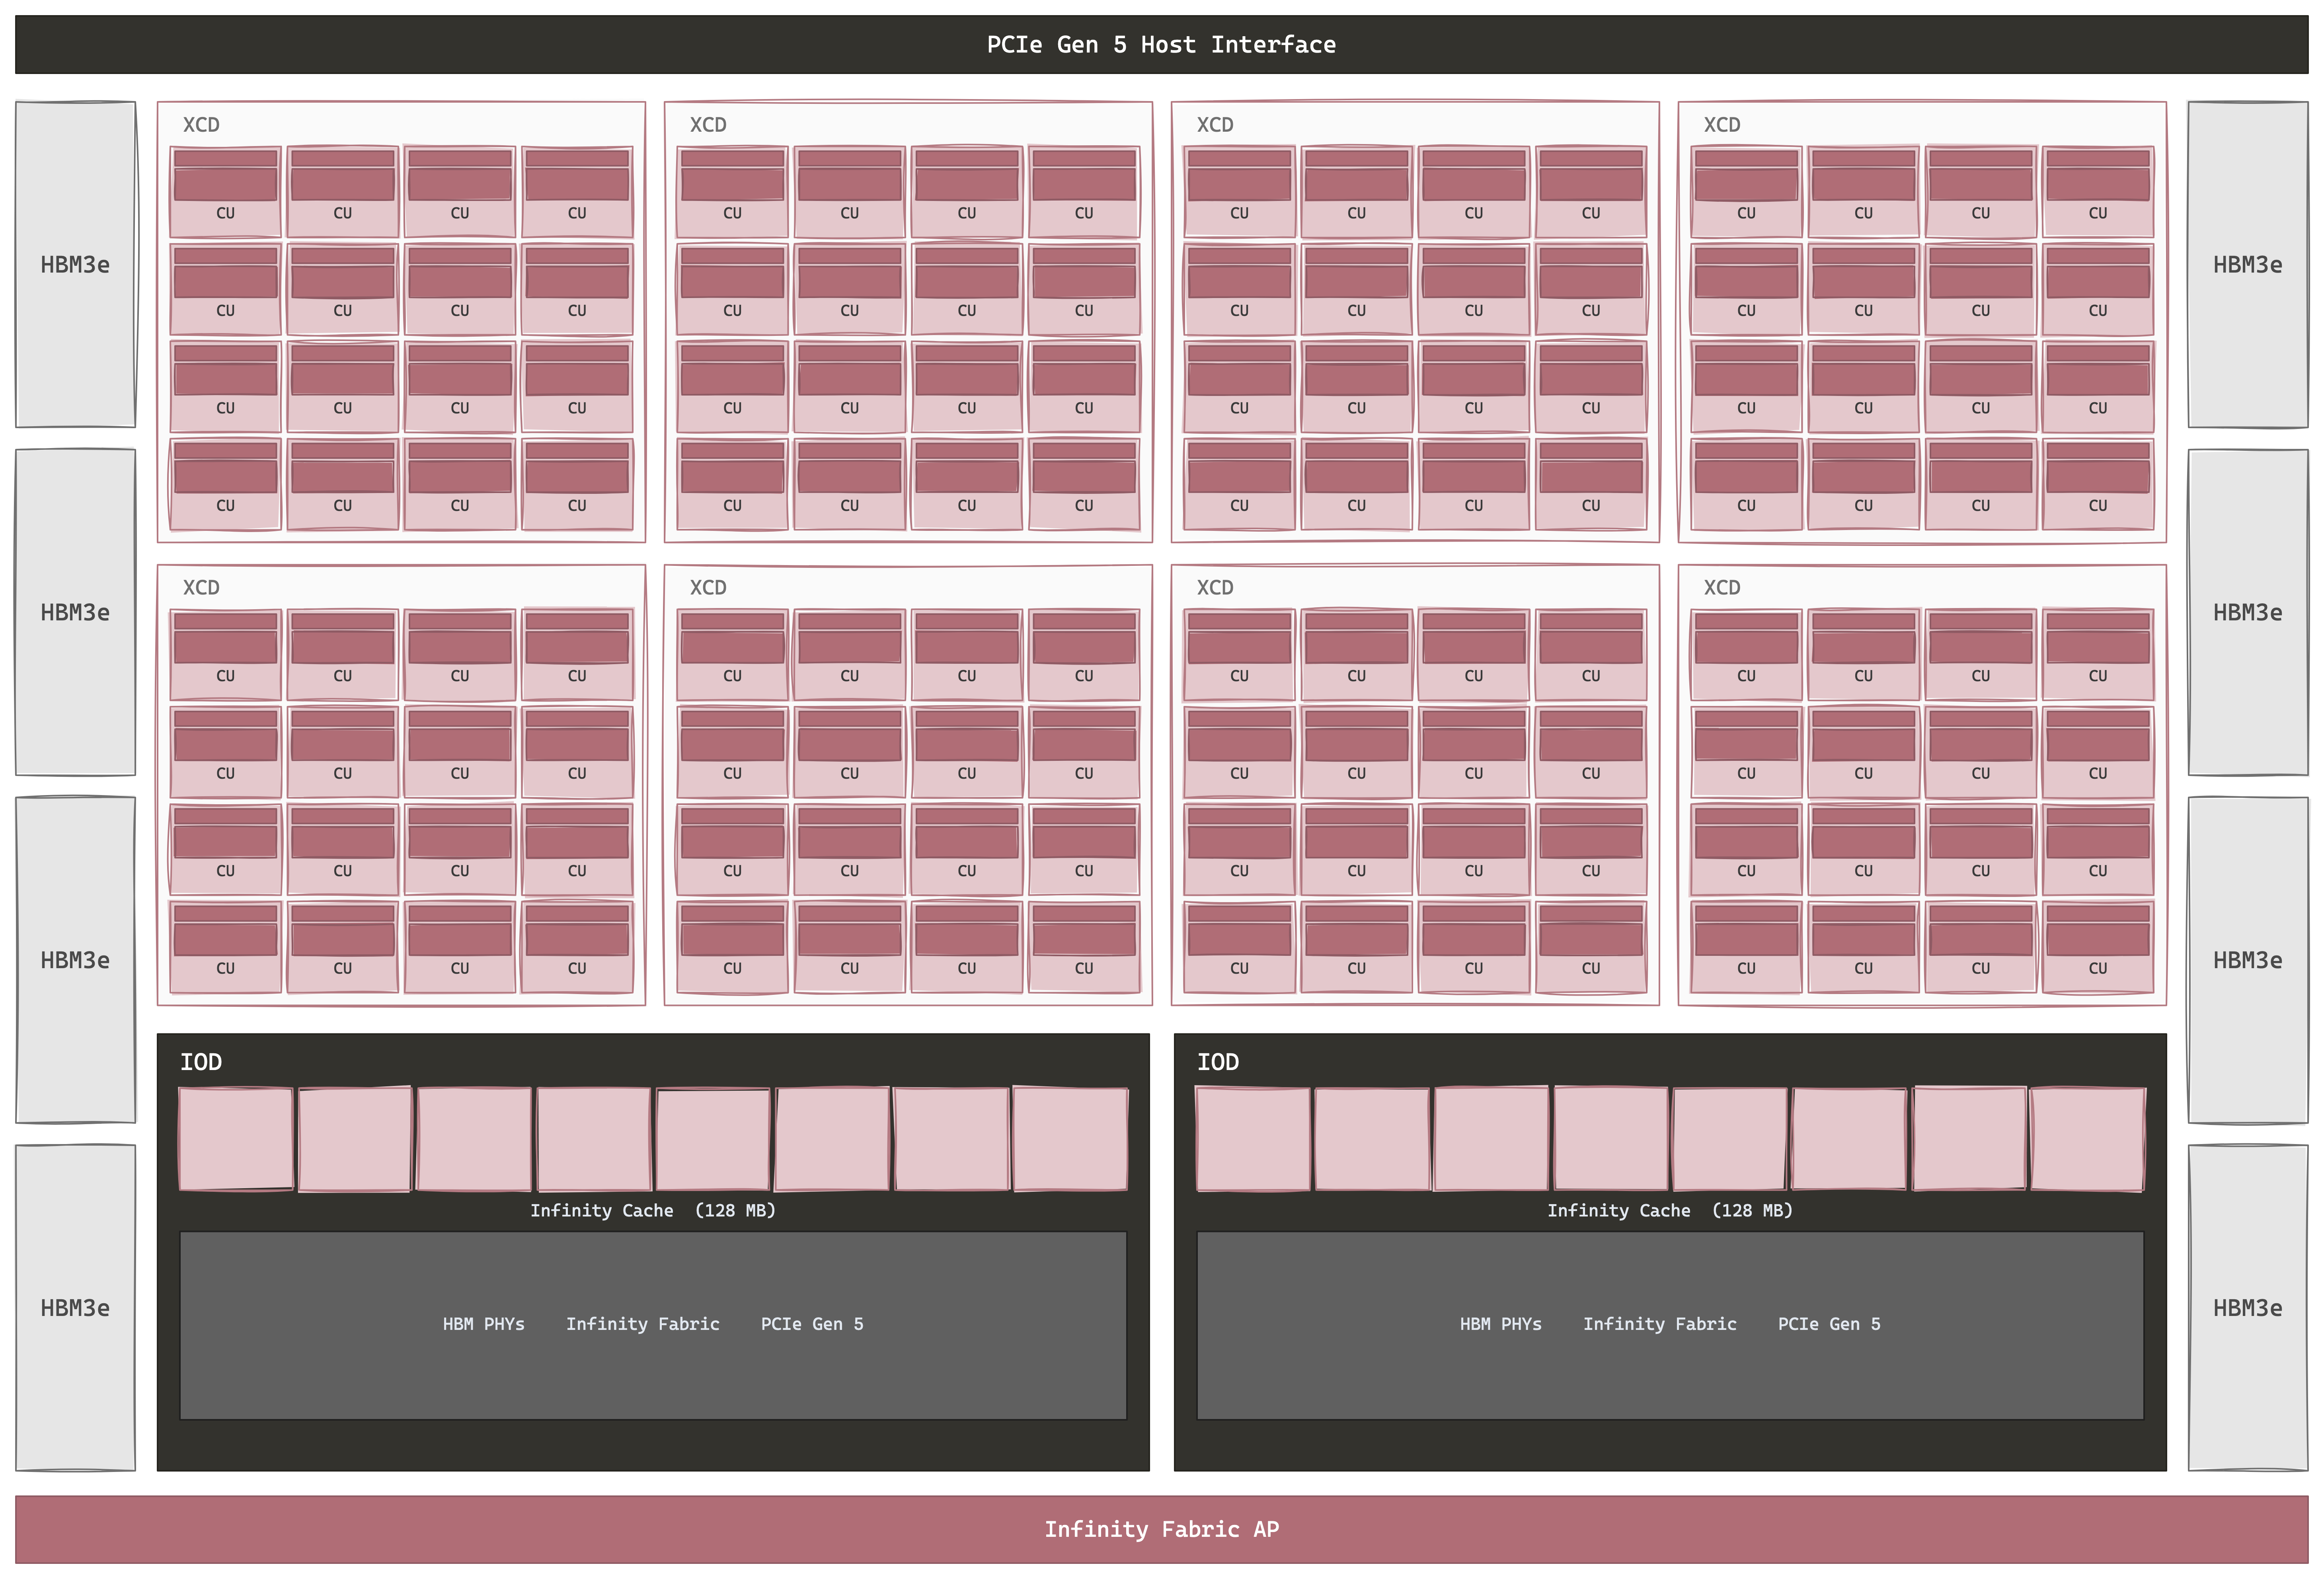
CDNA 3 是改变一切的举措。八个 XCD (TSMC N5,每个约为 115 mm²)通过 TSMC SoIC 以 3D 方式堆叠 混合键合(亚微米间距 TSV,无微凸块)到四个 I/O 芯片 (台积电 N6)如下。 IOD 承载 Infinity Cache、 HBM3 PHY、Infinity Fabric 链路和 PCIe Gen 5;每个 IOD 上面托管两个 XCD,旁边托管两个 HBM 堆栈。四个 IOD 由 Infinity Fabric AP 以 4.8 TB/s 的平分速度拼接而成,因此 1530 亿个晶体管封装对于内核来说就像一个 GPU:缓存和地址空间在 IOD 层统一。 NVIDIA 在 H100 中保持整体性,并且在 B200 上仅采用两个十字线限制芯片 2.5D CoWoS-L。 AMD 更早地在一代上实现了 3D 堆叠,每芯片面积更小:在同一封装前沿上有不同的选择。
MI300A APU 进一步推动了押注。将 8 个 XCD 中的 2 个替换为 3 个 Zen 4 CCD,保持 HBM 和 Infinity Cache 以及 IOD 完好无损,并让 CPU 和 GPU 共享一个由 HBM3 支持的物理地址空间,并具有硬件一致性。没有主机设备副本。没有固定的内存。路径中没有 PCIe。 Zen 4 核心和 CDNA 3 XCD 从同一页面读取。 NVIDIA 的 Grace-Hopper 桥 NVLink-C2C 上有两个包; MI300A 是 一个。 El Capitan (11,039 个节点,4× MI300A) 的部署证明了它的合理性。
在 CDNA 4 的 MI355X上,八个 XCD 仍然通过 SoIC 3D 堆叠到下面的基片上,但 XCD 转移到 TSMC N3P 每个有 32 个活动 CU(总共 256 个,而上层有 304 个) MI300X;对于更大的 Matrix Core 和 160 KB LDS),每个 XCD 数量下降到可用区域。四个 MI300X IOD 在 TSMC N6 上折叠为两个,每个宽度是 TSMC N6 的两倍,上面托管四个 XCD,旁边托管四个 HBM3E 堆栈。现在,每个 IOD 都拥有自己的 256 MB Infinity Cache 中的 128 MB 切片、一半的 HBM PHY、 Infinity Fabric 链接的份额以及 PCIe Gen 5. 两个 IOD 之间的 Infinity Fabric AP 以 5.5 TB/s 等分运行(比 CDNA 3 高约 15%),八个堆栈转移到 12-Hi HBM3E,以 8 TB/s 的速度提供 288 GB,比容量高 50% MI300X 具有相同的引脚数。该软件包总共有 1,850 亿个晶体管,并且仍然以一个 GPU 的形式呈现给内核。
设计取舍
- HPC 然后 AI。 HPC 和 AI 是同一个押注 直到它们不是:从 CDNA 2 到 CDNA 3 传送全速率 FP64 矩阵,然后一旦推理经济学决定性地支持低精度,就在 CDNA 4 处分叉。
- 内存 自 2021 年以来的每一代 HBM 容量都匹配或击败当代 NVIDIA 旗舰产品,并添加 256 MB 末级 Infinity Cache 吸收 H100 必须命中 HBM 的重用 for.
- 早期 3D 堆栈。 先于 NVIDIA 进行缓存和 I/O 3D 堆栈计算:台积电 SoIC 2023 年在 IOD 上采用混合键合 XCD,而 NVIDIA 一直保持单一架构直至 2025 年。
- 一致的 CPU+GPU。 MI300A APU 是有史以来对小芯片攻击性最强的产品, El Capitan 部署是证明。
- 开放扩展结构。 UALink 和 OCP MX over NVLink 和专有 FP4。
扩展
内存押注会产生缩放结果:当 8 MI300X 时 一个芯片可容纳 1.5 TB 的 HBM,8 个 MI350X 芯片可容纳 2.3 TB,您可以在其中安装 405B 参数型号 FP8 位于单个 8-GPU 盒子内(权重、KV 缓存以及用于更长上下文和更大批量的余量),其中相同模型在 8× H100 (640 GB) 上需要仔细分片。对于 2024 年至 2025 年的推理工作负载,AMD 的扩展不需要在机架上与 NVL72 相匹配即可在盒子上具有竞争力。为了 在前沿进行训练 确实如此,AMD 直到 2026 年才找到答案。
纵向扩展
通过 MI355X,AMD 的规模化意味着 8-GPU OAM 平台 超过 Infinity 面料。每个 MI300X 都有 7 个 IF 链路(一个到盒子中的每个对等点),双向 128 GB/s,在完全连接的全对所有拓扑中提供 896 GB/s 的每 GPU 网格带宽。 MI350X 将每个链接提升至 153.6 GB/s(每个 GPU 约 1,075 GB/s),但保持 8-GPU 形状。该平台符合 OCP 的 UBB 2.0:与 NVIDIA HGX 基板相同的机械插槽,因此服务器供应商可以在同一机箱上搭载 AMD 或 NVIDIA,而无需重新设计系统。
AMD 没有通过 MI355X 推出的是相当于 NVL72 的机架级产品。在 MI300X 集群上运行较大模型的客户可以通过以太网在多个 8-GPU 盒子之间进行扩展,为 NVIDIA 用户可以保留在内部扩展中的内容支付扩展延迟的费用。这是对训练至关重要的差距, Helios 就是为了弥补这一差距而设计的。
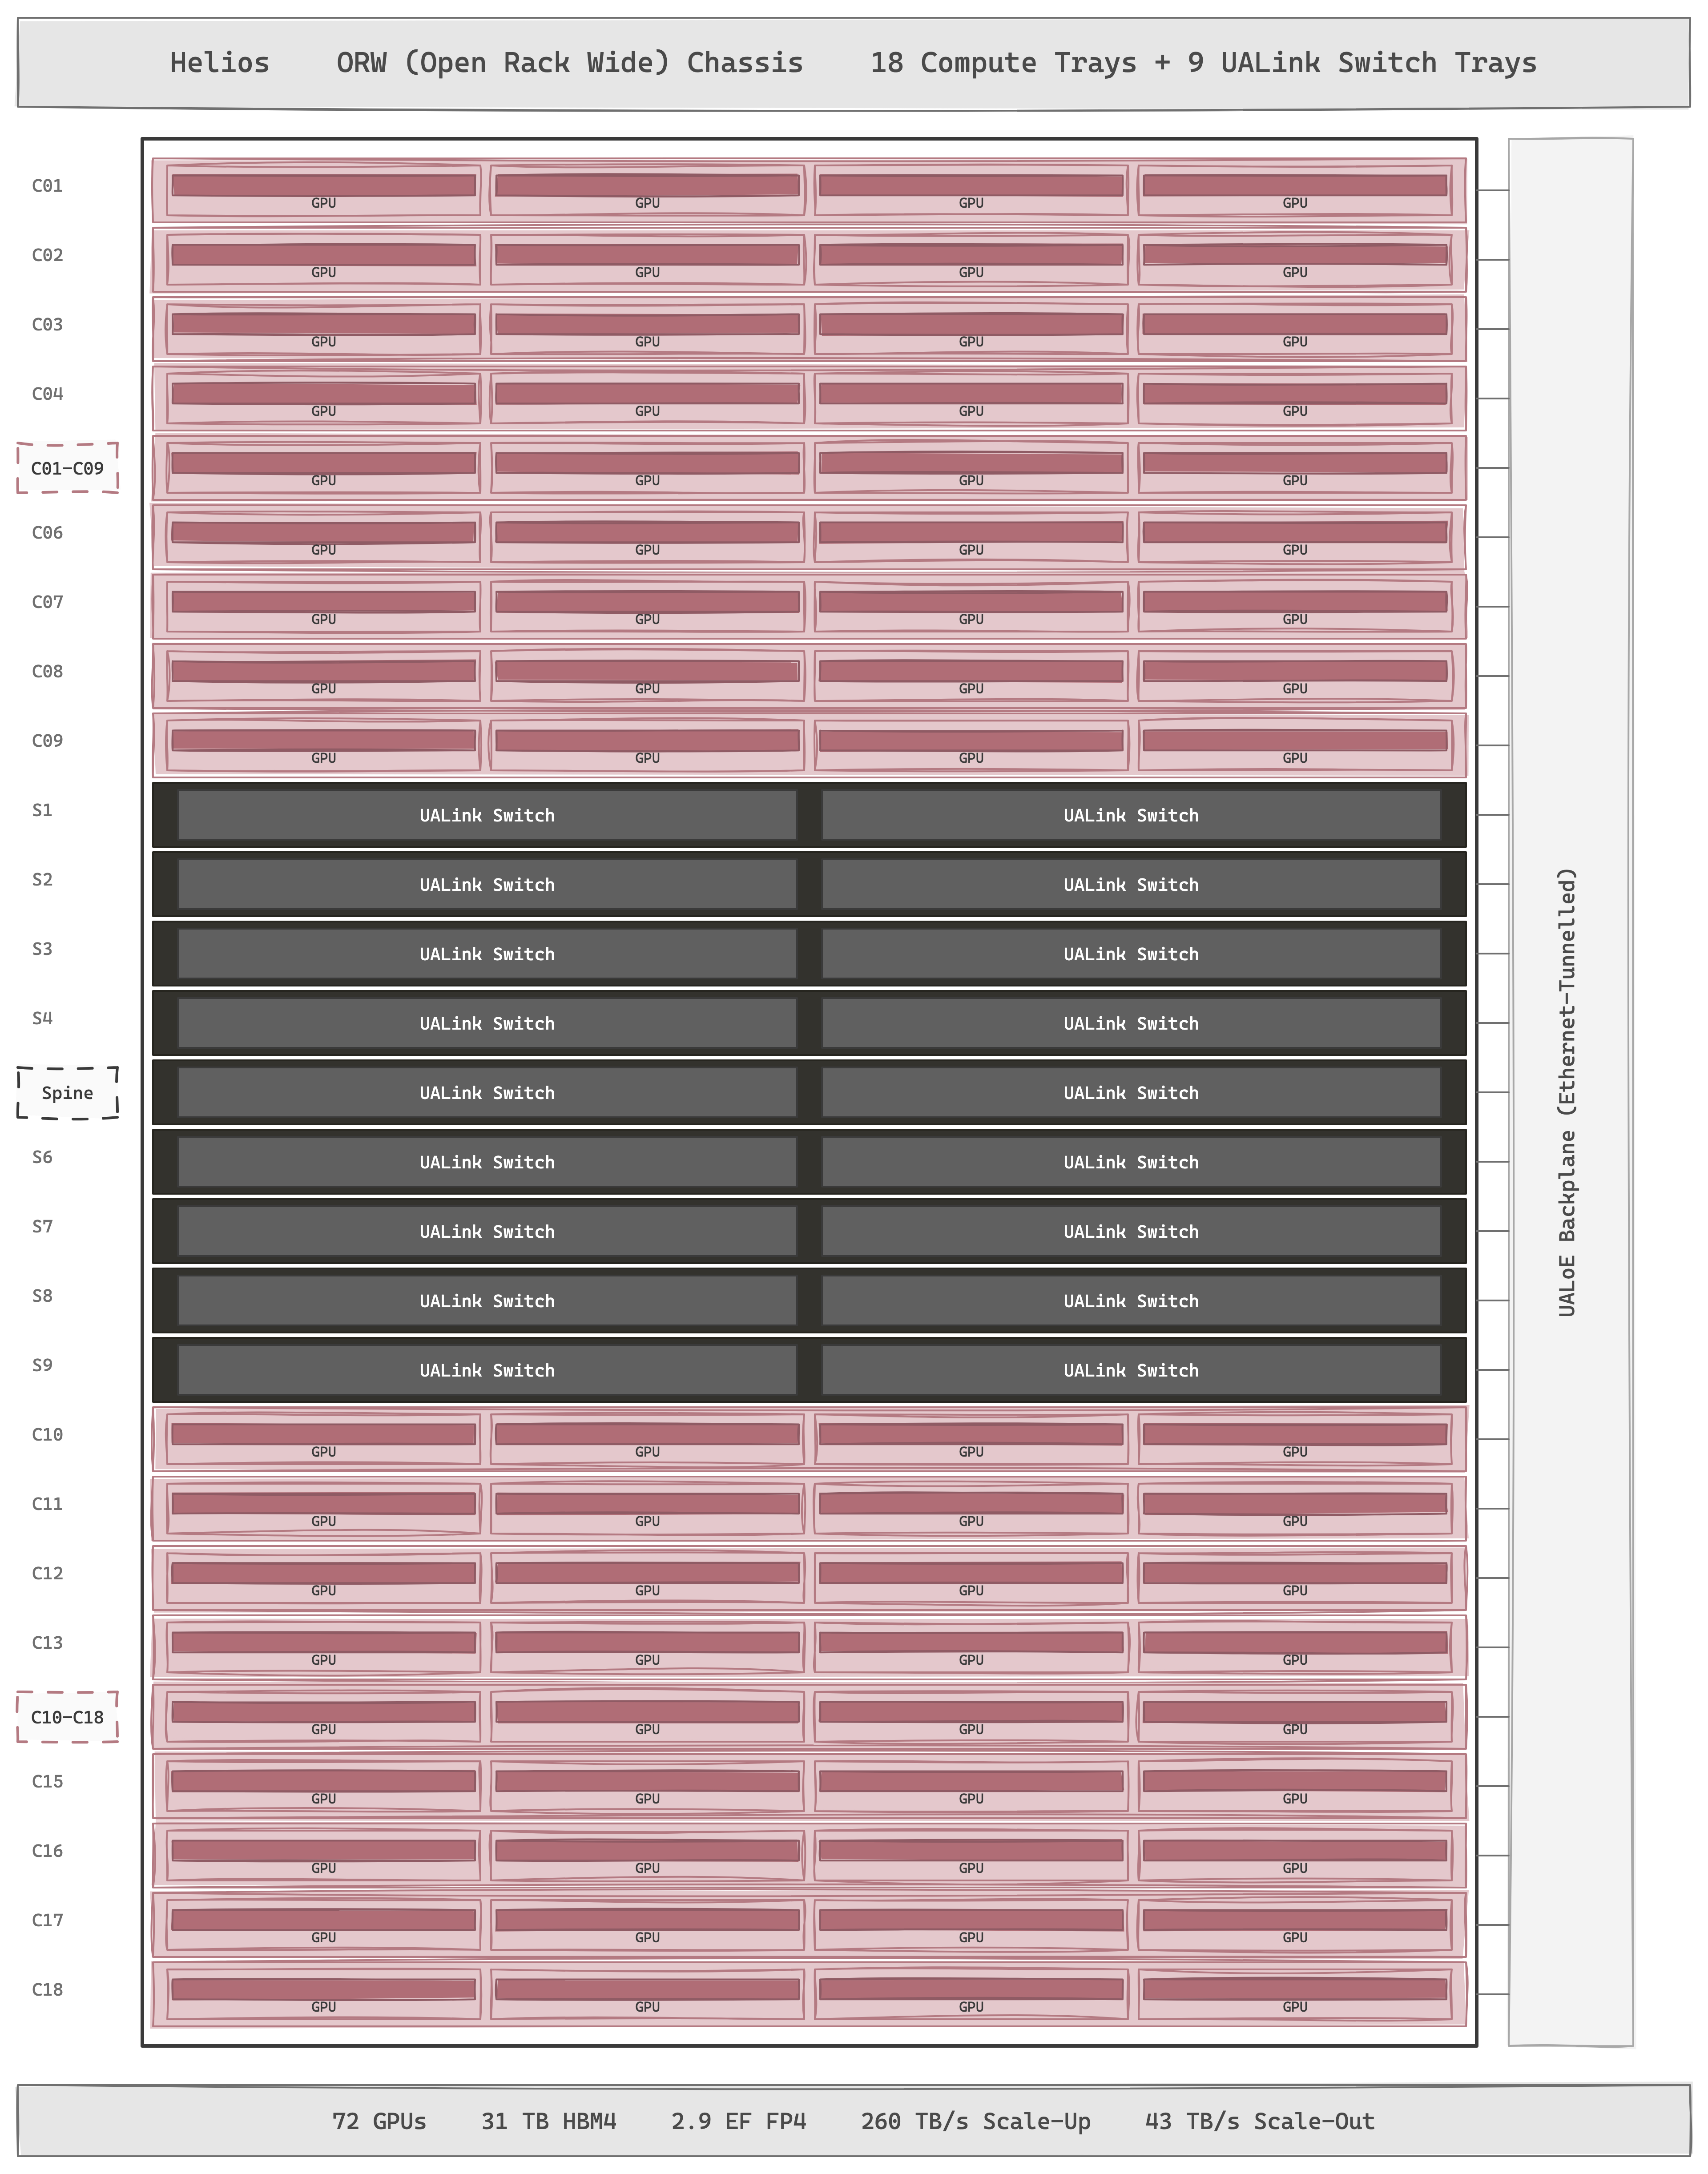
Helios 是 AMD 首款机架级扩展域,将于 2026 年 2 月与 MI455X一起发货。每机架 72 个 GPU,约 31 TB HBM4,1.4 PB/s 聚合 HBM 带宽,2.9 ExaFLOPS FP4 / 1.4 ExaFLOPS FP8,260 TB/s 纵向扩展带宽,43 TB/s 横向扩展。外形尺寸为 开放式机架宽 (ORW) (Meta 的 2025 年 OCP 提交,双宽和液冷),而不是 AMD 专有机箱。基于 Meta 的参考设计而不是从头开始设计机架是 AMD 的一个深思熟虑的押注:任何在 ORW 上标准化的超大规模企业都可以部署 Helios,而无需定制数据中心设施。
结构是 UALink:Ultra Accelerator Link 是 AMD 与 Apple、AWS、Cisco、Google、HPE、Intel、Meta、Microsoft 和 Synopsys 共同创建的开放联盟标准。 UALink 200G 1.0(2025 年 4 月)定义了 200 GT/s lane 和每个方向 800 Gbps,交换拓扑可扩展到每个 Pod 1,024 个加速器。其承诺是可与 NVLink 相媲美的缓存一致性互连,但无人拥有:任何供应商都可以构建 UALink 交换机,任何加速器都可以与 UALink 对话,该标准属于联盟而不是最强大的卖家。
现实限制是 native UALink switch silicon 要到 2027 年才会大规模供货。Astera Labs Scorpio,以及 Auradine、Enfabrica、Xconn 的同类产品,预计在 2026 年末至 2027 年部署。Helios 初期因此使用 UALoE——把 Infinity Fabric tunnel 到标准 Ethernet 上——作为过渡方案,在等待 native UALink fabric 的同时保留 programming model。也就是说,首发版 Helios 更接近高速 Ethernet-tunneled coherent cluster,而不是 NVL72 那种原生 NVLink coherent domain;这是 AMD 为了按时在 2026 年推出 rack-scale product 所做的取舍。
横向扩展
AMD 不提供 InfiniBand。整个横向扩展堆栈是以太网,基于不同的开放标准: 超以太网联盟 (UEC)。
UEC 1.0(2025 年 6 月发布)定义 超以太网传输 (UET):标准以太网上的新 RDMA 传输,具有数据包喷射、基于 SACK 的选择性重传和现代拥塞控制。 UET 不是 RoCEv2(它将 InfiniBand 传输封装在以太网帧中);它是针对横向扩展 AI 结构的 RDMA 语义的彻底重新设计。 AMD 与博通、思科、Meta 和微软一样是创始成员。与 UALink 相同:拥有标准,而不是实现。
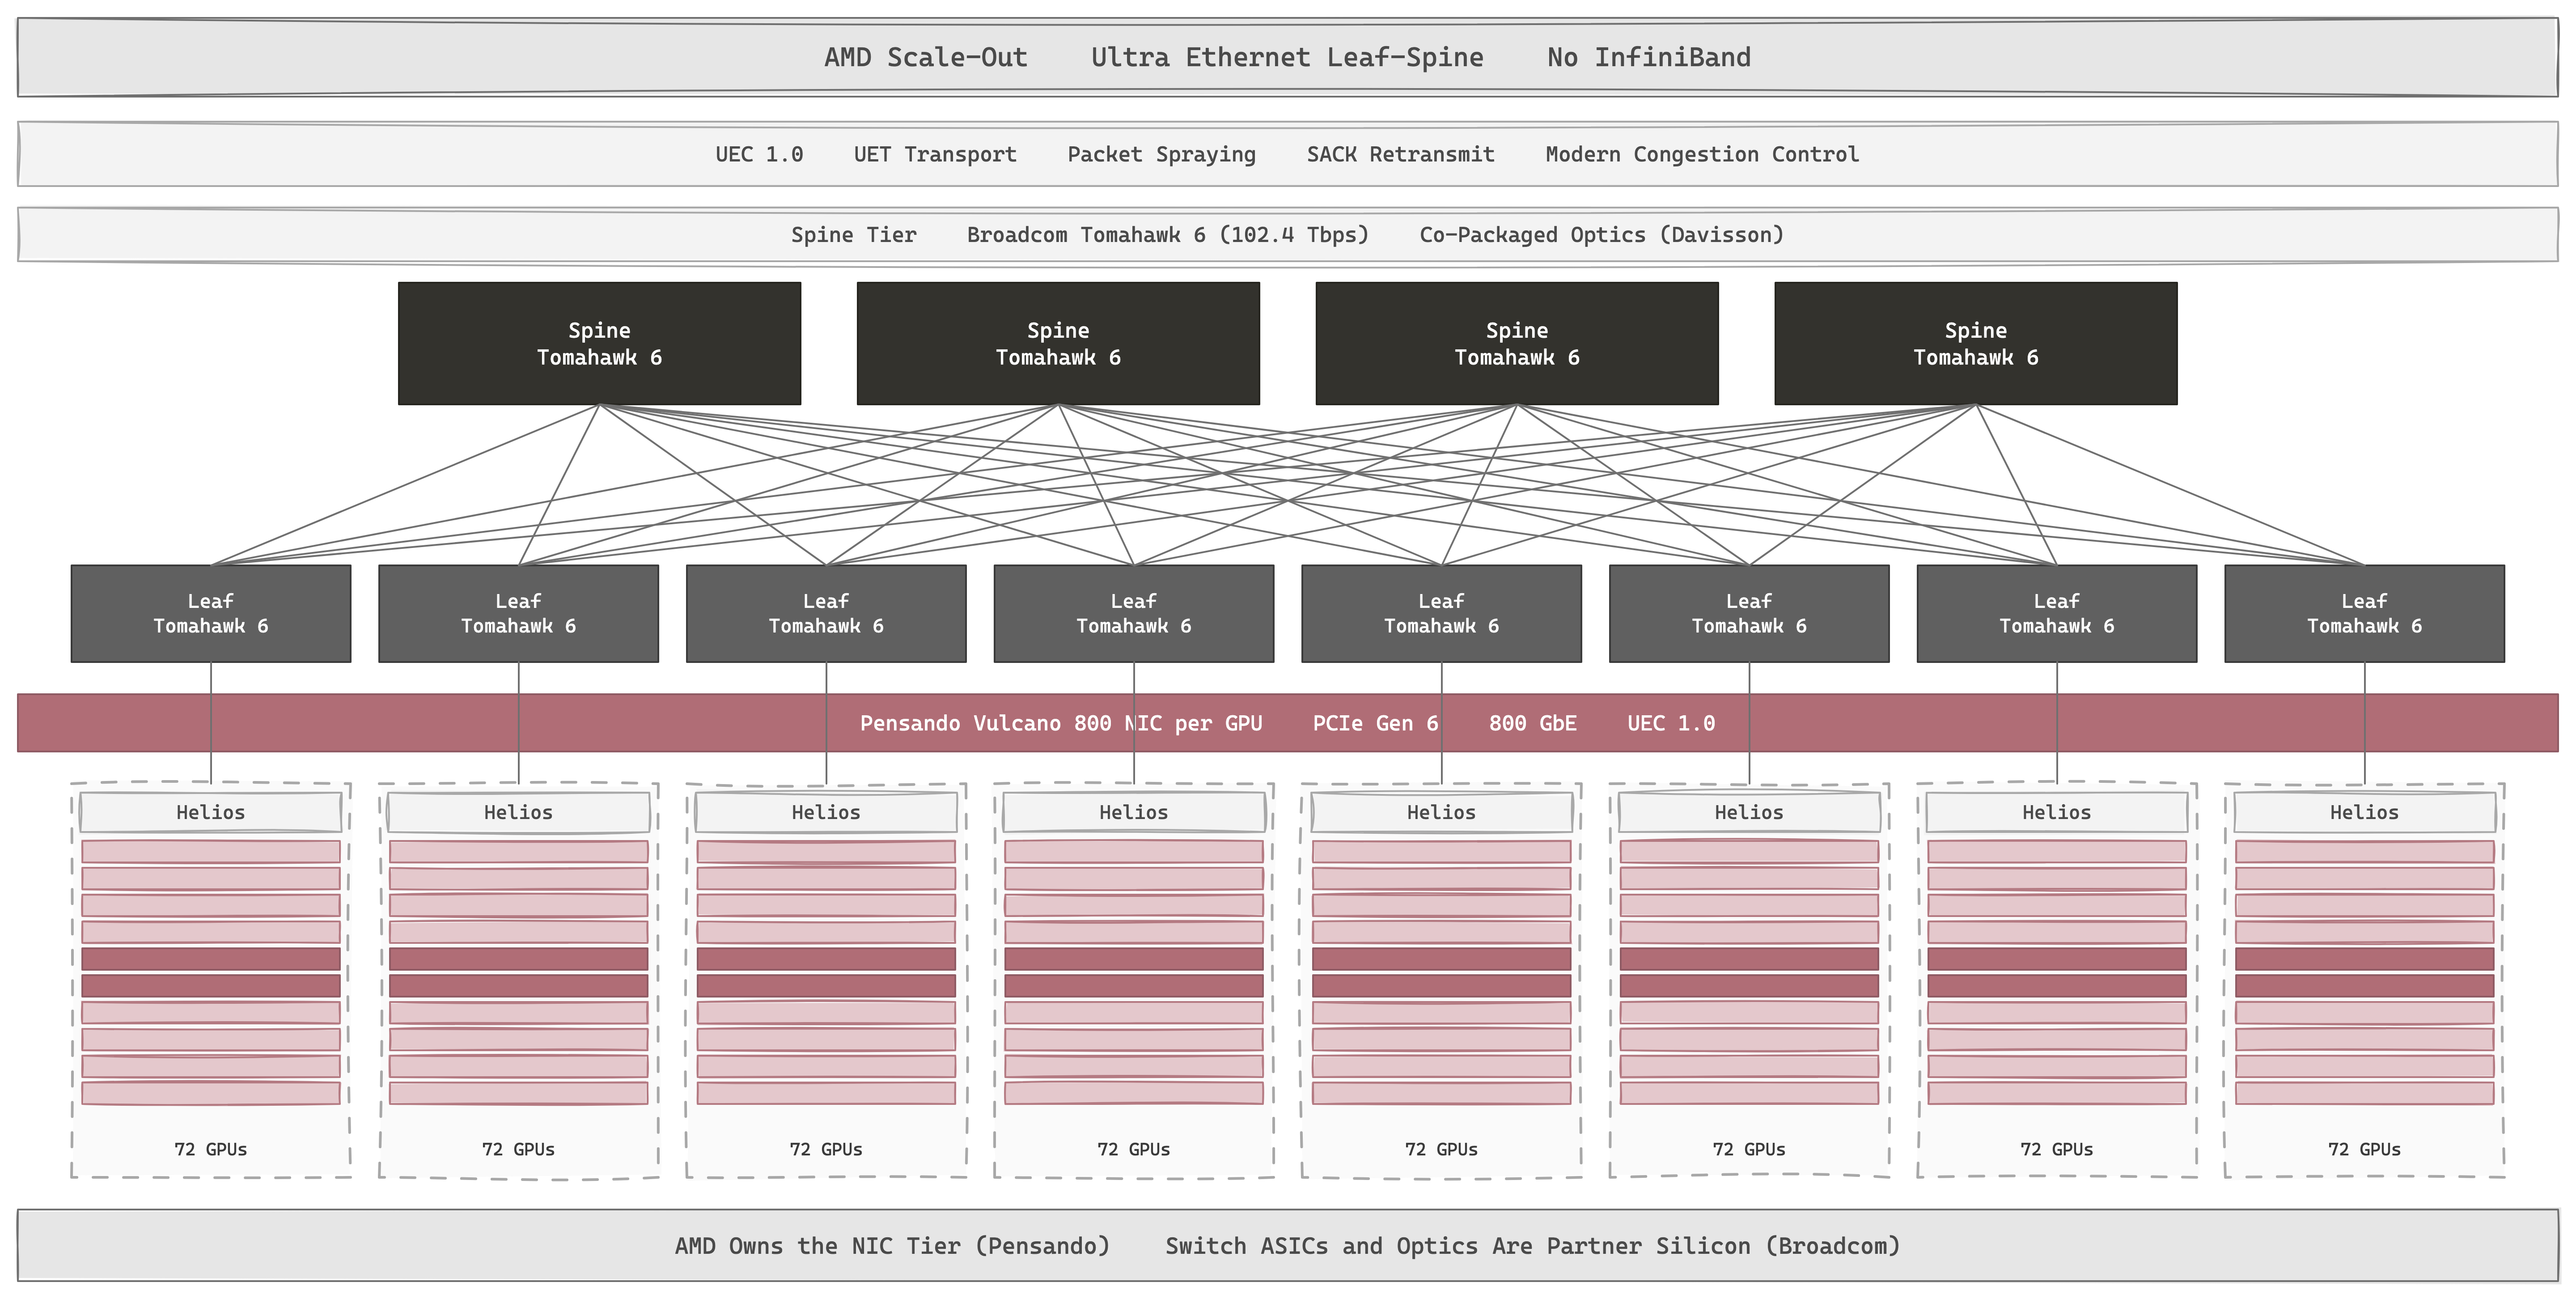
网卡是 Pensando,AMD 于 2022 年收购的网络初创公司。 Pollara 400 是当前的 AI NIC:400 GbE、P4 可编程、UEC 就绪、PCIe Gen 5,与 MI300X / MI355X 配对。 Vulcano 800 将于 2026 年与 MI455X 一起发货:符合 UEC 1.0 标准、PCIe Gen 6、原生 UALink 接口、每 GPU 横向扩展带宽是 Pollara 的 8 倍。 Salina 400 是用于存储/SDN/防火墙的前端 DPU(16× Arm Neoverse-N1,双 400 GbE),相当于 NVIDIA 的 BlueField,与 AI 后端网卡不同。
不过,开关芯片不是 AMD 的。 Helios 的 43 TB/s 横向扩展结构通过 Broadcom Tomahawk 6运行:具有共同封装光学器件的 102.4 Tbps 以太网交换机 ASIC(“Davisson”)。 AMD 没有内部 CPO ,也没有内部交换机 ASIC;光学层是伙伴硅。 NVIDIA 拥有整个堆栈:InfiniBand、Spectrum-X 以太网、ConnectX、BlueField、Quantum-X Photonics CPO,全部为内部产品。 AMD 拥有一层(NIC + DPU,通过 Pensando),并押注开放标准加上同类最佳的合作伙伴芯片将超过垂直整合。
行业已经改变了 AMD 的方式。 Dell'Oro 报告称,到 2025 年,以太网处理的 AI 横向扩展结构容量将是 InfiniBand 的两倍以上; AWS、微软、Meta、Oracle 和 xAI 都已针对其基于 AMD 的 AI 集群进行了以太网标准化。剩下的问题不是以太网是否可以在 RDMA 语义上与 InfiniBand 相匹配(UEC 缩小了这一差距),而是 Helios 是否可以足够快地缩小 机架规模 与 NVL72 的差距,从而赢得目前默认由 NVIDIA 承担的前沿训练工作负载。
软件栈
ROCm 是 AMD 面向 CUDA 提供的开源软件栈。NVIDIA 采用专有且垂直集成的模式:cuBLAS、cuDNN、TensorRT-LLM 等关键组件主要由 NVIDIA 独立开发和维护,其中不少以 binary library 的形式发布。ROCm 则以 GitHub 为主要协作平台,并优先接入 PyTorch、Triton、vLLM、OCP MX 等开放项目和标准,而不是围绕一套由单一厂商控制的专有库构建封闭生态。AMD 与 NVIDIA 之间的软件成熟度和性能仍有差距;AMD 的策略是借助 upstream project 与开源社区逐步缩小差距,而不是从头复制一套与 CUDA 平行的完整生态。
堆栈的底部是 HIP,AMD 的 CUDA 兼容 C++ 运行时。 hipify 自动将 CUDA 源转换为 HIP。批量 HPC 代码(HACC、Laghos、QMCPack)端口开箱即用率为 80–95%:CORAL-2 编号。modern AI kernel 的移植更糟糕:任何涉及 Hopper 或 Blackwell 特定原语的内容(TMA 描述符、 wgmma、 tcgen05.mma) 没有干净的 ROCm 模拟,必须手动重写。
HIP 之上有一个库层,其结构与 NVIDIA 的镜像相同,按名称一对一: rocBLAS for cuBLAS; hipBLASLt 用于 cuBLASLt; MIOpen 用于 cuDNN; RCCL 用于 NCCL; 可组合内核 (及其现代 ck-tile DSL) 用于 CUTLASS;适用于 Nsight 系列的 rocprofv3 / rocprof-sys / rocprof-compute。不过,目前还没有 TensorRT-LLM 的第一方类似产品。 AMD 的答案是支持 vLLM 作为开源服务引擎,并提供 AMD 特定的运算符 (AITER)进入其中; vLLM 专用的 ROCm CI 在 2026 年初将测试通过率从 37% 提高到 93%。
PyTorch 是 ROCm 的主力支持路径。Eager-mode PyTorch 很早就已支持 ROCm;torch.compile 通过 Triton 生成 kernel,Triton ROCm backend 也已经进入 upstream。ROCm 不采用 XLA 式 whole-graph IR,而是直接 lower 到 HIP、Triton 或 Composable Kernel。随着 Triton 成为 PyTorch 的常用 kernel path,许多 torch.compile kernel 可以在 CUDA 与 ROCm 之间复用。AMD 的设计取舍是让 Triton Python DSL 成为跨厂商的公共 kernel language,从而降低 CUDA ecosystem 带来的迁移成本。
FlashAttention 为承重案例。 FA2 正在通过可组合内核在 MI300X 上进行生产; PyTorch 在 ROCm 上默认为 CK 或 AOTriton。 FA3 (Hopper 调整)通过 AITER + CK 部分支持,但 Dao-AILab 的规范实现仍然仅支持 CUDA。 FA4 (Blackwell,2026 年 3 月)根本没有 ROCm 端口。 HipKittens是 Hazy Research 的 ThunderKittens MI355X 端口(2025 年 11 月),声称在约 500 行中与手动调整的 AITER 具有前向传递同等性。其模式是:开源学术内核在 NVIDIA 的几个月而不是几年后关闭 AMD 的尾巴。
生产部署已经验证了该策略。 Microsoft Azure 的 ND MI300X v5 实例于 2024 年 5 月正式发布; OpenAI 对它们运行 GPT 推理。 Meta 通过 Grand Teton 平台在 MI300X 上提供 Llama 3 / Llama 4 推理。 Oracle OCI 的 BM.GPU.MI300X.8 于 2024 年 9 月进入通用版本,MI355X 将于 2026 年上市。这些是超大规模的真实服务队列,而不是试点。
ROCm 的性能差距仍然存在。独立 benchmark 显示,在标准 PyTorch、vLLM 和 SGLang workload 上,ROCm 7.2 通常比同级 CUDA stack 慢约 10–25%。ROCm 已经接近 feature parity,但还没有达到 performance parity。差距在最新 research kernel 上最明显,例如依赖 Blackwell 新 primitive 的 FlashAttention-4 尚无直接 ROCm implementation,需要等待 AITER、HipKittens 或其他 hand-written kernel 补齐。常见的 Llama inference、attention 和 dense Transformer training 已能较好运行,但新的 long-tail workload 仍会带来额外 porting 和 tuning 成本。
Cerebras WSE
Cerebras 制造了目前规模最大的商用 processor。它的出发点是:memory wall 很大程度来自把 wafer 切成独立 die,再用 HBM、interposer、NVLink 和大量 cable 把这些 die 重新连接。Cerebras 选择不切 wafer。Wafer-Scale Engine(WSE)把 84 个 reticle field 连接成一整块 46,225 mm² silicon,其中包含 900,000 个 dataflow core;每个 core 都紧邻 local SRAM,使 data movement 保持在 wafer 内部。
演进路线
架构
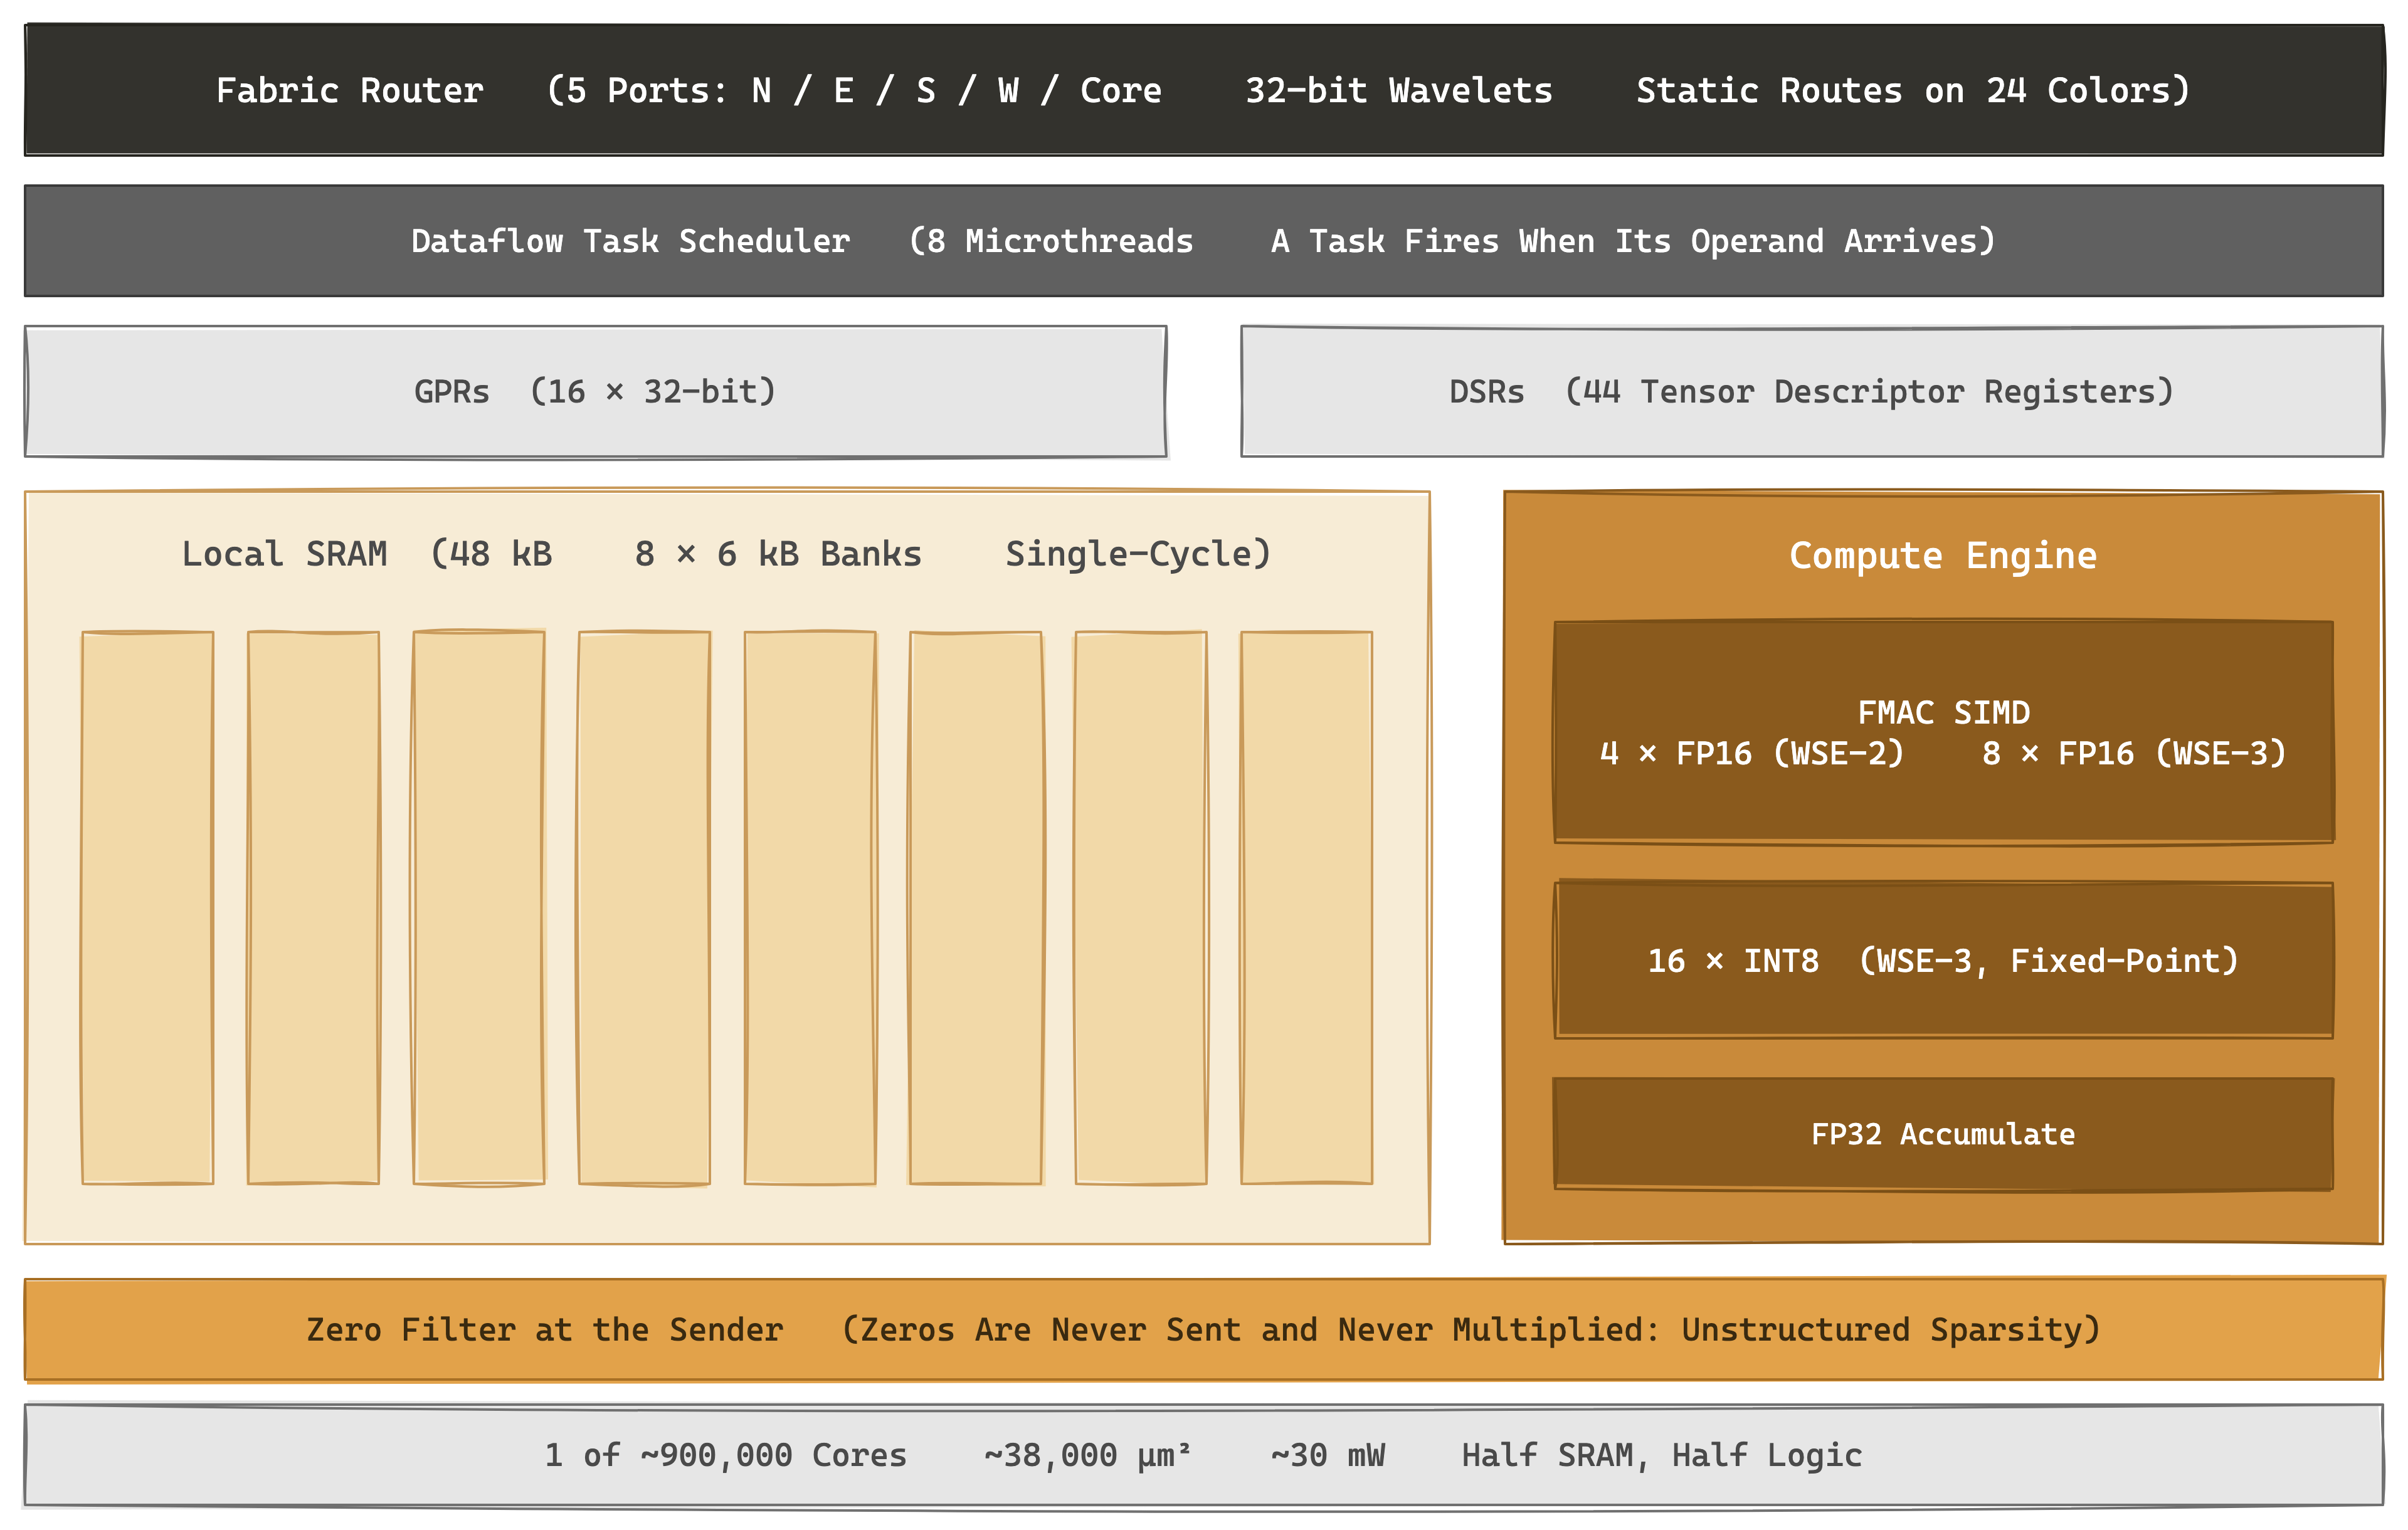
GPU 是层层嵌套的体系:thread 组成 warp,warp 运行在 SM 上,SM 位于 die 和 package 内,package 再组成 node 与 rack;每一层都有自己的带宽、延迟和编程边界。WSE 则更像一张平面:900,000 个小 core 在二维 mesh 上首尾相连,没有 shared cache,也没有传统意义上的 global memory。每个 core 都很小:包含 48 kB local SRAM、16 个 GPR、一个 6-stage pipeline、一个 FP16 FMAC SIMD,以及连接 fabric 的五端口 router。执行采用 dataflow model:core 平时保持 idle,直到 wavelet 到达;wavelet 中的控制位决定触发哪个 task,8 个 hardware microthread 根据 operand 是否就绪逐周期切换。这里没有 warp、warp scheduler、cache miss 或 reorder buffer——数据到达本身就是调度。
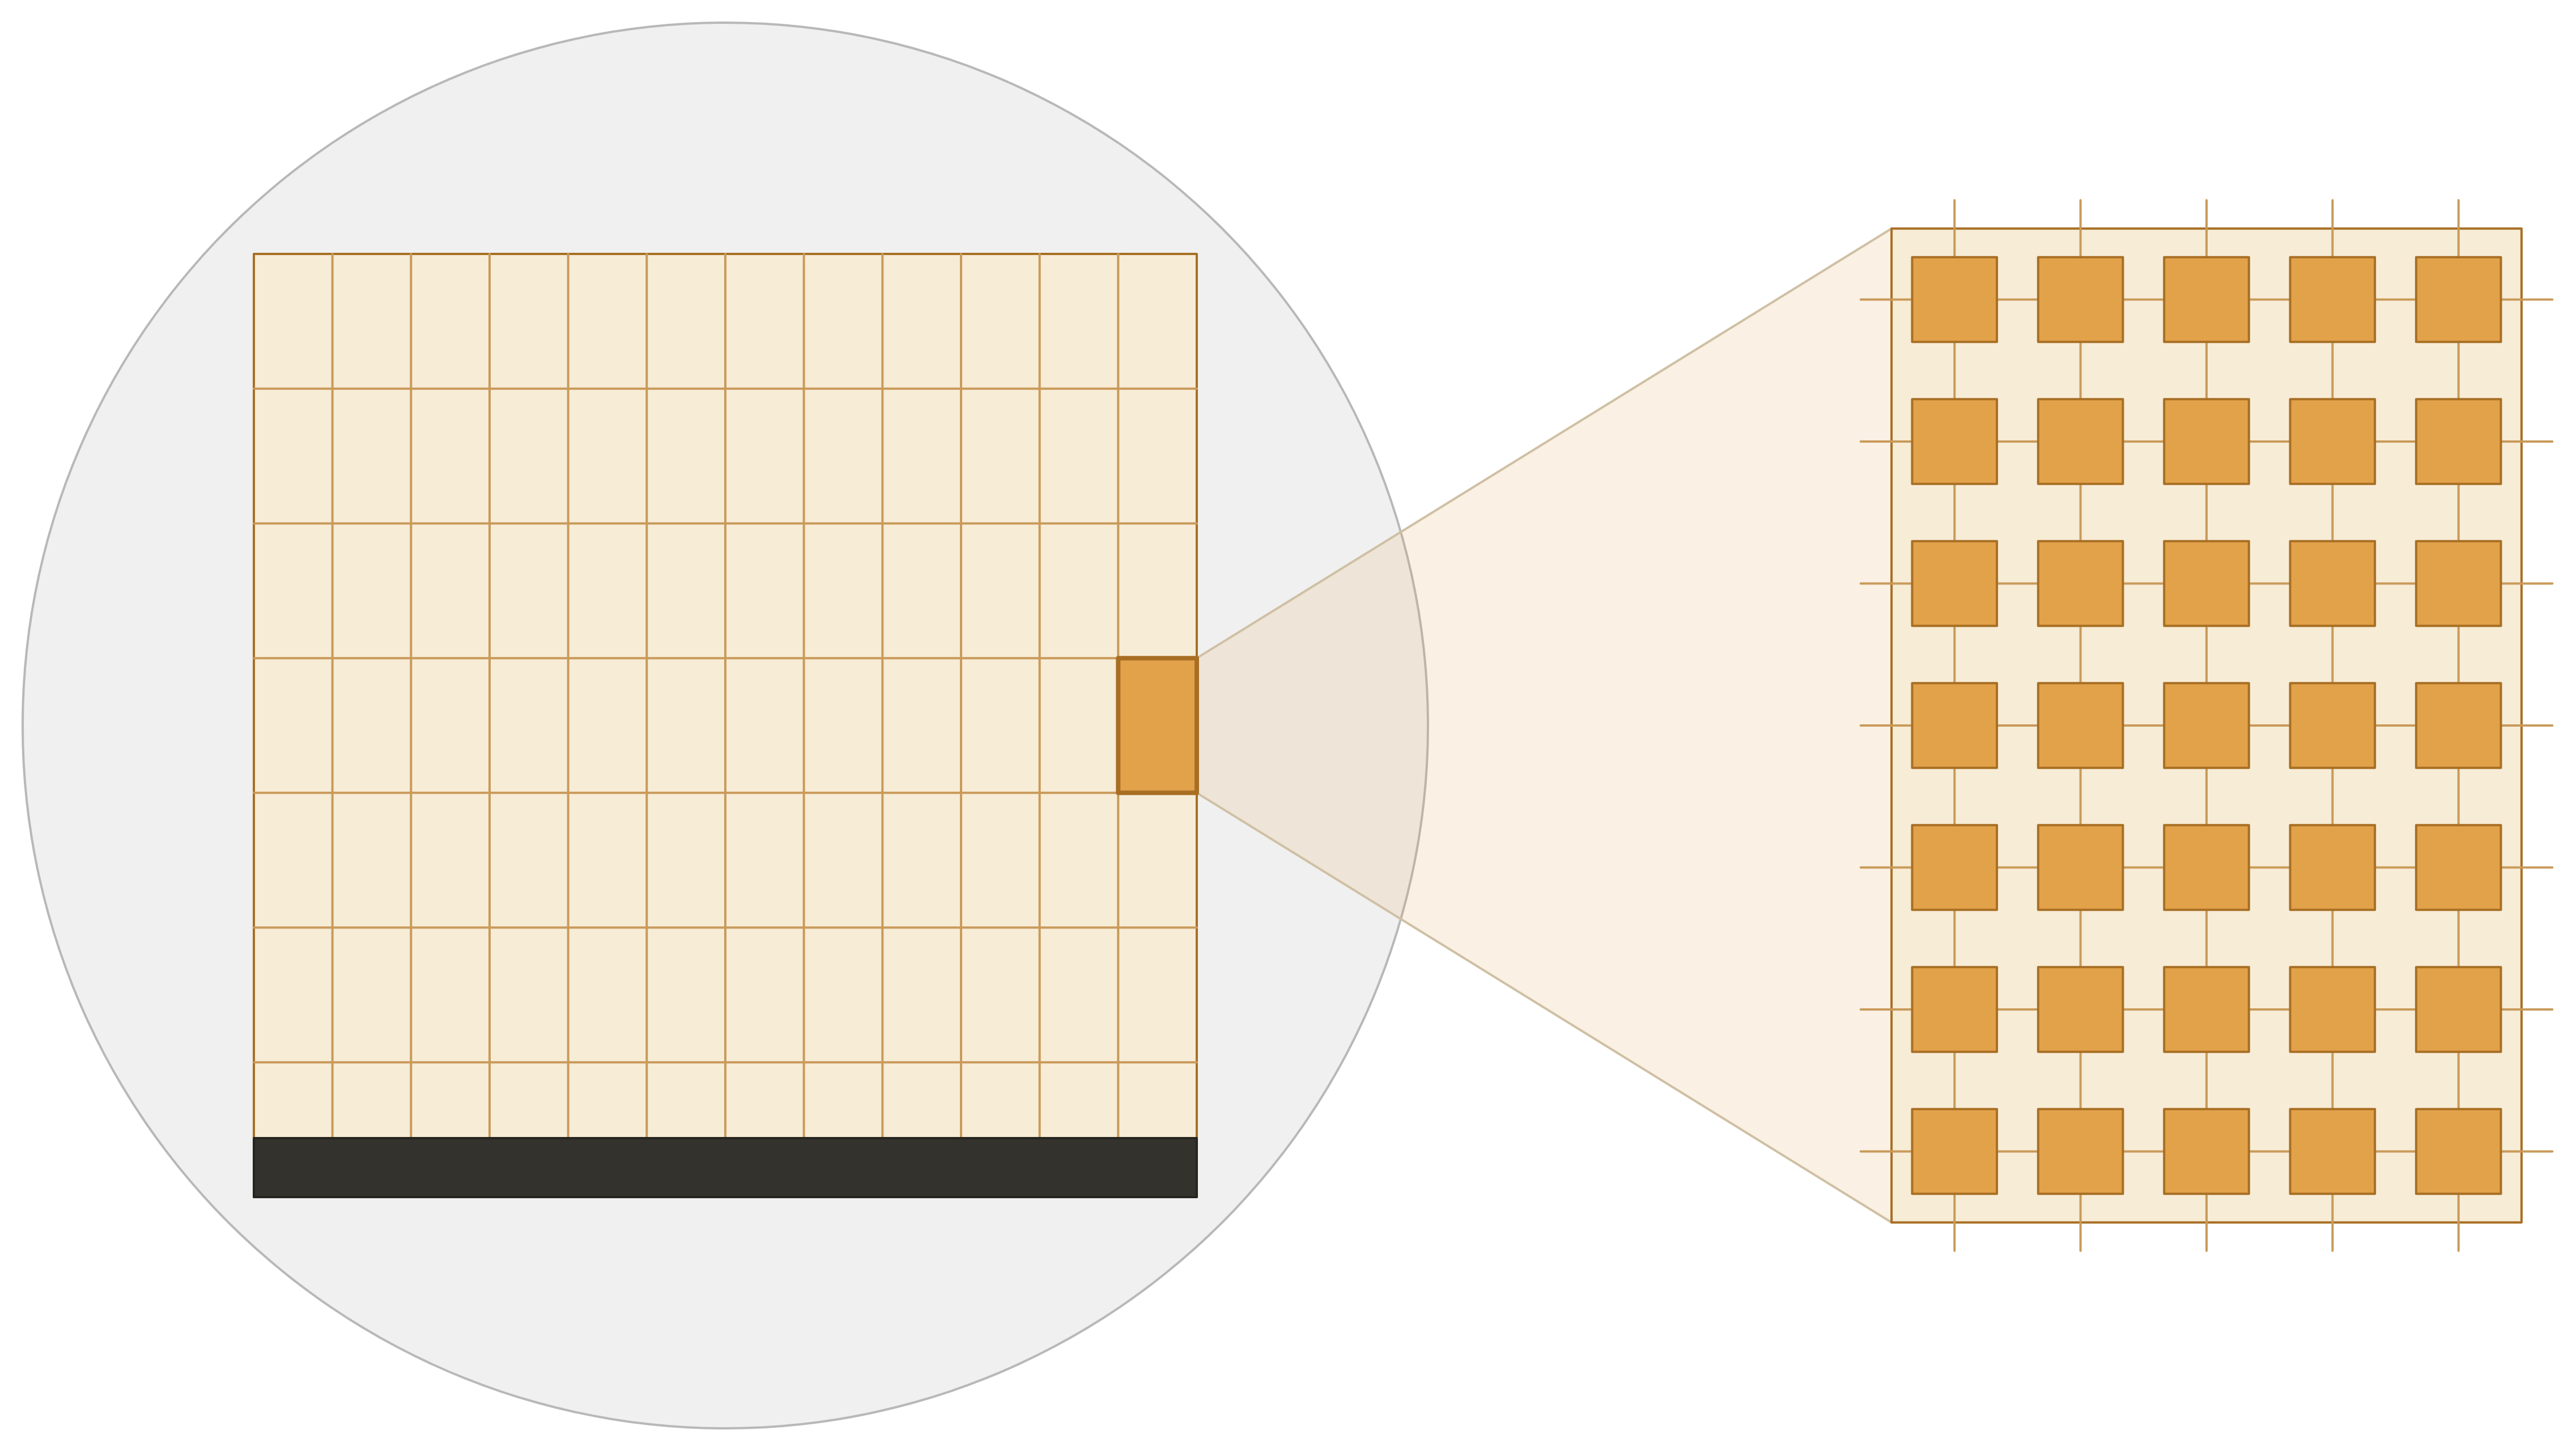
晶圆
步进机曝光晶圆一个 标线 一次,每次拍摄约 850 mm²,这就是为什么每个传统芯片都生活在这个上限之下(以及为什么 B200 变成 两个芯片 NVIDIA 向其施压的那一刻)。与台积电的任何其他客户一样,Cerebras 在 12×7 网格中打印相同的约 550 mm² 芯片 84 次,然后在与台积电共同开发的工艺中,在锯正常运行的 <1 毫米 划线 上铺设额外的高级金属。网格穿过源同步并行接口上的每个接缝(WSE-3 上每个芯片为 2,880 GB/s),整个芯片间层的成本约为 97 W。对于软件来说,接缝不存在:一个统一的网格,一个芯片。
晶圆级之前已经尝试过,但在良率上失败了:单片晶圆计算机中的单个缺陷会杀死整个晶圆,这是是什么在 20 世纪 80 年代埋葬了 这个想法 。 Cerebras 的答案是粒度。 H100 上的缺陷会导致整个 ~6 mm² SM 失效; WSE 上的相同缺陷会导致一个 0.05 mm² 核心失效。 WSE-3 制造了约 970,000 个核心,并交付了 900,000 个:约 7% 的备用池,加上冗余结构链路,使硬件能够围绕每个缺陷重新映射并恢复完整的逻辑网格。
核心
Cerebras core 最特别的地方不是 datapath,而是 instruction 如何描述数据。除 16 个 GPR 外,每个 core 还有 44 个 Data Structure Register(DSR),每个 DSR 保存一个最多四维的 tensor descriptor,包括 base address、extent 和 stride。instruction 通过 DSR 引用 operand,因此一条 FMAC instruction 就能表达“把到达的数据流与驻留 tensor 相乘并累加”,hardware 会持续处理整个 tensor,而不需要 software loop 或 element-wise instruction fetch。NVIDIA 花了多代 Tensor Core 才把 matmul 推向 descriptor-driven command;在 WSE 中,tensor instruction 从一开始就是这种形式。
execution ordering 由 fabric 完成。color 是编译期静态路由的 virtual channel,并绑定到目标 core 上的一个 handler task;向某个 color 发送 wavelet,效果就像调用目标 core 上的代码,其中 control bits 表示调用类型,data bits 携带参数。task scheduler 在 8 个 hardware microthread 之间切换,根据 operand 是否 ready 选择下一项工作。它和 GPU warp scheduler 都在隐藏 stall,只是 WSE 需要隐藏的是 local SRAM bank conflict 或邻居 hop,而不是 HBM round trip。
48 kB 本地 SRAM 是为数据路径而不是局部性而组织的:8 个单端口 6 kB 存储体每个周期提供两次 64 位读取和一次 64 位写入,恰好有两个 4 元素 FP16 operand 输入和一个结果输出,即 WSE-2 FMAC 的宽度。 256 字节软件管理的缓存(WSE-3 上为 512 B)将最热的值保留在管道旁边。这是机器原理的缩影:每个核心、内存带宽和计算能力完全匹配,而晶圆继承了这一平衡 900,000 倍。
计算
WSE 没有独立的 matrix unit。NVIDIA、Google 和 AMD 把主要 FLOPs 集中到 Tensor Core、MXU 或 Matrix Core;Cerebras 则利用 2D fabric 组合出 matmul。执行 GEMM 时,weight 沿一排保存 activation 的 core 广播,每个 core 对自己的 local slice 做 FMAC,partial sum 再沿 mesh reduction。Tensor Core 依靠 register tile 做 data reuse,MXU 依靠 systolic wiring,WSE 则依靠 spatial placement:activation 保持原地不动,只有 weight 和 partial sum 在 fabric 中流动。
解读 Cerebras 的 FLOPs 需要区分 sparse 与 dense。WSE-3 宣传的 125 PFLOPS 指 sparse FP16,并假设理想 workload 能通过 zero skipping 获得约 8× gain。按 900,000 core × 8-wide FMAC × 1.1 GHz 推算,dense FP16 约为 15.8 PFLOPS;Cerebras 没有单独公布这个数字。WSE 的重点本来也不是每瓦 dense FLOPs,而是 SRAM bandwidth:compute datapath 的规模主要是为了跟上 21 PB/s on-wafer SRAM。
零跳跃是数据流赢得其保留的地方。因为计算是由到达的数据触发的,所以零永远不会触发任何东西: 零在发送者处被过滤,并且接收核心永远不会看到它们并且永远不会花费周期。这是非结构化的元素粒度稀疏性,是 NVIDIA 2:4 structured sparsity 仅采样的一般情况。到目前为止,这也是一个尚未行使的选择权。 Cerebras 自己的稀疏预训练结果(SPDF:1.3B 参数稀疏度为 75%;后续为 6.7B)是供应商编写的且低于 7B,并且没有透露旗舰客户模型经过稀疏训练: Jais 2,硬件上最大的运行,是密集的。唯一能够获得非 structured sparsity 的芯片尚未推出使用它的头条模型。
内存
WSE 的 memory hierarchy 几乎只有一层:44 GB SRAM 分散在 900,000 个 core 内,每个 core 约 48 kB。没有 HBM、L2 或 eviction policy,local SRAM 可以单 cycle 访问。21 PB/s 是所有 local SRAM port 的 aggregate bandwidth,并不是 point-to-point link bandwidth,因此不能直接与 HBM 数字比较。更有意义的指标是 bytes per FLOP:按 dense FP16 估算,WSE 每 FLOP 可获得约 1.3 byte,而 B200 从 HBM 获得的约为 0.002 byte。decode 需要为每个 token 读取整套 weight,天然 bandwidth-bound,因此最能体现 WSE 的优势。
这层超高带宽 SRAM 的边界也很明显:整片 wafer 对外只有 12×100 GbE,也就是 1.2 Tb/s。on-wafer SRAM 与 off-wafer Ethernet 之间相差约五个数量级。GPU hierarchy 的带宽通常逐层下降,而 WSE 是 wafer 内极快、wafer 外突然变慢。换句话说,wafer 既是一座高带宽 island,也被自己的边界限制。
另一个限制是 SRAM density 的 scaling 已明显放缓。即使 WSE-3 换用更先进 process node、transistor count 增加约 54%,SRAM capacity 也只比 WSE-2 增长约 10%。logic 仍能随着 process 缩小,但 6T SRAM cell 的收益有限,因此下一代 process 不会自动带来同比例的 on-wafer capacity 增长。
权重流式传输
晶圆上的训练颠倒了其他人认为理所当然的流程:在 GPU 或 TPU 上,权重是驻留的,激活流通过;在 WSE 上, 激活是常驻的,权重通过流动。主权重位于 MemoryX中,它是集群旁边的 DRAM 和闪存设备。权重逐层流过晶圆,针对固定在 SRAM 中的激活触发乘法累加,然后离开;梯度流在后向传递中返回,优化器步骤在 CPU 上的 MemoryX 内部运行(权重更新是 O(参数)的 element-wise 工作,没有重用,因此 CPU 级计算保持同步)。晶圆从不存储权重,“即使是暂时的”(Cerebras 的短语)。模型大小受 MemoryX 限制,而不是 44 GB; 44 GB 限制激活和批处理。
这种 weight streaming 换来的是更简单的 programming model:一个 wafer 可以容纳完整一层的 activation,因此不需要 tensor parallel、pipeline parallel 或 FSDP sharding。70B model 可以按单设备程序编写;扩展到多个系统时,只需使用 SwarmX 做纯 data parallel——把同一份 weight stream 广播到 N 个 wafer,并在返回路径上聚合 gradient。GPU 训练里复杂的 parallelism strategy,在 Cerebras 上被大幅压缩。
代价体现在实际 scale 上。Cerebras 规格曾描述最多 2,048 台 CS-3,但公开披露的最大 deployment 是 64 台 Condor Galaxy 3。平台上公开的最大 from-scratch model 是 Jais 2(70B parameter、2.6T token),由 G42 与 Cerebras engineer 协同训练。另一个缺失指标是 MFU:GPU lab 通常会公开 35–45% 一类数字,但 Cerebras 尚未为这些大规模 run 披露可直接比较的利用率。
数值格式
WSE 的主计算格式是 FP16/BF16、FP32 accumulate;WSE-3 另外公开了一条 16-wide 8-bit fixed-point path,但没有 FP8、FP4 或 microscaling。其他 AI accelerator 通过降低 precision、再用 block scaling 恢复 accuracy 来提升 throughput 和 capacity,而 Cerebras 仍以 16-bit 为主,并把它作为 quality selling point。这里存在明显 tension:SRAM capacity 是 WSE 最稀缺的资源,如果能使用 8-bit weight,model 所需 wafer 数量理论上可以减半。因此,坚持 16-bit 究竟是 numerical choice 还是 datapath roadmap 的限制,仍是开放问题。
设计取舍
- 不要切割晶圆。 芯片边界是行业其他部分支付的税:SerDes、中介层、HBM 堆栈、电缆、交换机。金属中的 Stitch 84 reticle field 和竞争对手系统中的最高带宽边界根本不存在。
- SRAM 是唯一的存储器。 以业界最陡的比率交换带宽容量:44 GB,晶圆上聚合 21 PB/s。平衡机器,而不是将不平衡隐藏在层次结构后面。
- 数据流核心,无矩阵单元。 由到达的 wavelet 触发的 900,000 个微小核心,通过广播、FMAC 和网格缩减组装 matmul:跳过零是免费的,而不是特殊模式。
- 权重移动,激活保持不变。 权重流将模型大小 (MemoryX) 与晶圆内存 (44 GB) 解耦,并将集群扩展压缩为纯 data parallel。
- 销售延迟,不是吞吐量。 晶圆重新读取每个 token 的整个模型的速度比基于 HBM 构建的任何东西都要快;价格作为优质产品加速,而不是在每个 token 的成本上竞争。
扩展
在 Cerebras 上,scale-up 与 scale-out 的含义和 GPU 不同。WSE 在 fab 阶段就把 900,000 个 core 做成一个 coherent on-wafer domain,因此不存在“把 72 个 package 连接成一台机器”的 scale-up 问题。真正的边界是 wafer 外部:一旦 workload 超出单片 wafer,就必须通过带宽低得多的 Ethernet 与其他系统通信。
纵向扩展
晶圆的内部结构没有 SerDes,没有电缆,没有收发器,每条链路没有边际成本:路由被编译,每一跳都是一个周期,广播是一种原生结构原语而不是交换机功能。 NVL72 花费了 5,184 根铜缆和一个 NVSwitch 托盘 ASIC 为 72 个 GPU 提供 130 TB/s 的全对全,WSE 的等效域是单个光刻对象。问题是域的大小是一个常数。 NVIDIA 的扩展领域每一代都在增长(三年内从 NVL72 到 NVL576);自 2019 年以来,晶圆尺寸一直为 46,225 mm²,并将保持这一水平。 300 毫米是业界最大的晶圆(450 毫米过渡已于十年前消亡),因此 Cerebras 的扩展路线图取决于下一个节点的密度产量:没有更多的区域可供使用。
横向扩展
训练横向扩展 SwarmX,它只做一件事:复制。将权重流广播到 N 个晶圆,减少它们在返回路径上的梯度;批次随着系统数量的增加而增加,但模型大小却不会。声称的 2,048 个系统的上限(“256 exaFLOPS”,稀疏)从未建成; 64 有。
推理完全放弃权重流;算术是致命的。对于每个 decode 的 token,通过 ~150 GB/s 的管道从 MemoryX 流式传输 70B 模型的 140 GB 大约每个 token 花费一秒。因此,推理 将权重存储在 SRAM 中,并在层边界跨晶圆对模型进行分片:Llama 70B 位于“少至四个”CS-3 上,通过以太网进行管道并行,每个附加晶圆贡献 44 GB 的权重加 -KV 容量和 23 kW 负载。
Cerebras 的低延迟 inference 性能已经得到独立 benchmark 验证。Artificial Analysis 在 Llama 3.1 8B、70B、405B 以及 Llama 4 Maverick 上测得数百到数千 token/s 的单用户 decode speed,其中部分结果明显高于同期 GPU service。厂商公布的峰值通常更高,尤其会叠加 speculative decoding,因此比较时应区分 independent measurement 与 vendor peak。可以确认的是:在 batch-one、每用户 decode latency 这一指标上,Cerebras 确实处于领先位置。
但这种速度伴随着显著的 system cost。每片 wafer 只有 44 GB SRAM,frontier-scale model 往往需要多台 CS-3 才能容纳 weight 和 KV Cache;decode 时大量 compute unit 处于空闲,真正受限的是 SRAM capacity 与 bandwidth。Cerebras 没有公开 batch size 和 per-system aggregate throughput,公开 API 的 token price 通常也高于主流 GPU provider。长 context 还会让 KV Cache 与 weight 争夺同一片 SRAM,因此需要更多 system 才能维持 model replica。换句话说,Cerebras 优化的是极低 latency,而不是最低的 per-token cost。
市场已经诚实地定价了。 Mistral 的 Le Chat(约 1,100 个 token/秒)、Perplexity Sonar 和 Meta 的 Llama API 都为延迟付出了代价; 2026 年 1 月,OpenAI 签署了 到 2028 年将拥有 750 MW 的 CS-3 产能, 据报道超过 $10B 在签约时 自增长超过 $20B以来,成为有史以来获得的最大晶圆代言规模。第一个搭载该容量的旗舰产品是 GPT-5.6 Sol,于 2026 年 7 月推出,报价为 750 个 token/秒。
软件栈
Cerebras 的软件栈同样由 compiler 驱动,但开放面比 TPU 更窄。cerebras.pytorch 先通过 lazy tensor 把 train step 捕获为 Torch-MLIR/graph IR,再把 subgraph 匹配到手写 kernel library;没有匹配项时才回退到较慢的自动生成 kernel。公开限制包括 static graph、无 dynamic shape、无 data-dependent control flow、执行过程中不能随时读取 intermediate tensor,以及固定的 PyTorch version。换句话说,它并不是普通 PyTorch code 的 1:1 drop-in backend。
这套 ML stack 也没有面向普通用户的 kernel escape hatch。CUDA 可以自己写 kernel,TPU 有 Pallas,ROCm 有 Triton;Cerebras graph matcher 无法覆盖某个关键 operator 时,通常需要 Cerebras engineer 介入。独立的 CSL language 能直接暴露 task、wavelet 和 fabric color 等底层机制,并在 HPC workload 上取得很强结果,但它与 PyTorch model workflow 是两个相对独立的世界。
这其中有一种奇怪的免疫力。 FlashAttention,GPU 的定义内核谱系时代,是一种通过内存层次结构平铺注意力的方案,而 WSE 没有可以平铺的层次结构:导致 AMD 多年移植延迟的优化类根本不适用。但免疫力和贫困是同一个事实。在 CUDA 上复合的 third-party kernel 生态系统没有可以附着的表面;该平台历史上的每一项内核改进都有一位作者。
因此,WSE 找到的是一个边界清晰的市场:它在 batch-one decode latency 上优势明显,并且已有客户愿意为速度支付溢价;但 per-token cost、SRAM capacity、model size 和 customer concentration 都限制了适用范围。WSE 把 memory wall 视为 packaging 问题,并用整片 46,225 mm² wafer 消除了 die-to-die 边界,这是它最独特的价值,也是它最难扩展的约束。
AWS Trainium
Annapurna Labs 是 AWS Nitro 卡和 Graviton CPU 背后的芯片团队。它把 Trainium 定位为 TPU 路线的 fast follower:计算核心沿用 128×128 weight-stationary systolic array、software-managed scratchpad 和 whole-program compilation,并直接复用 XLA。Scale-out 则建立在 AWS 已有的 Nitro/EFA 网络之上。Trainium 真正独特的地方,是在这套计算核心旁加入专用 collective communication hardware,并利用 AWS 从芯片、服务器到云服务定价的垂直整合,只需要在 AWS 内部把总体成本做到优于 NVIDIA。
演进路线
架构
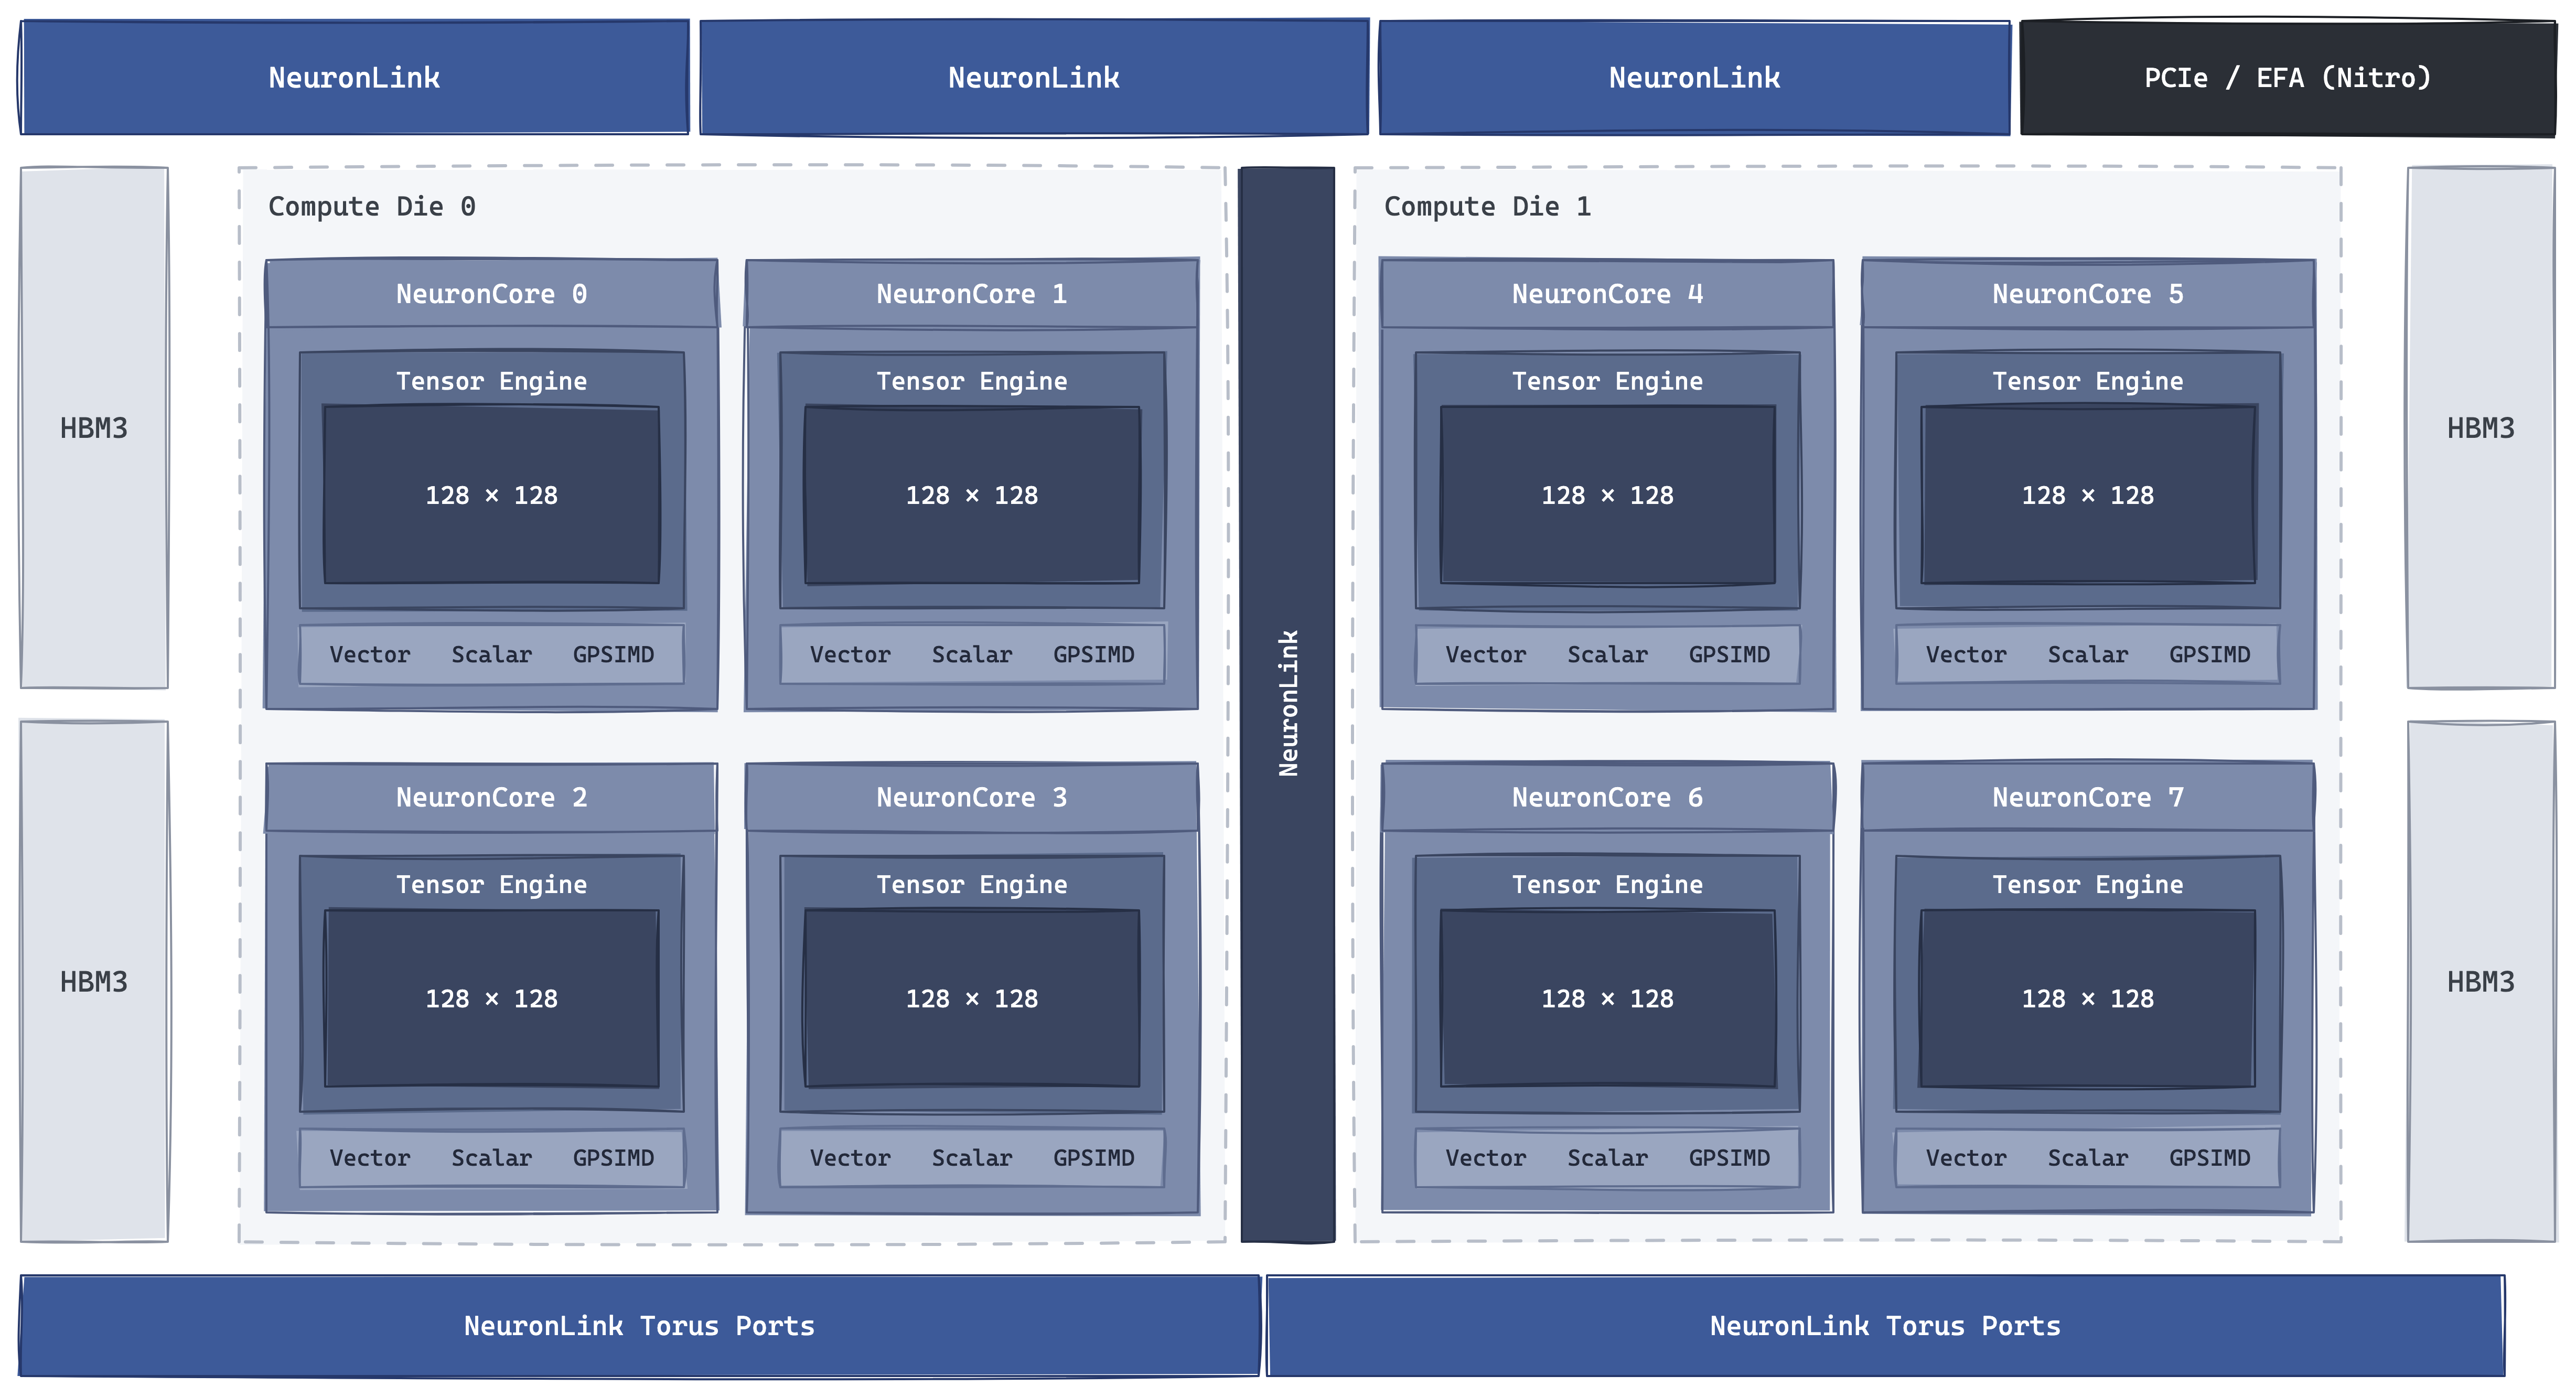
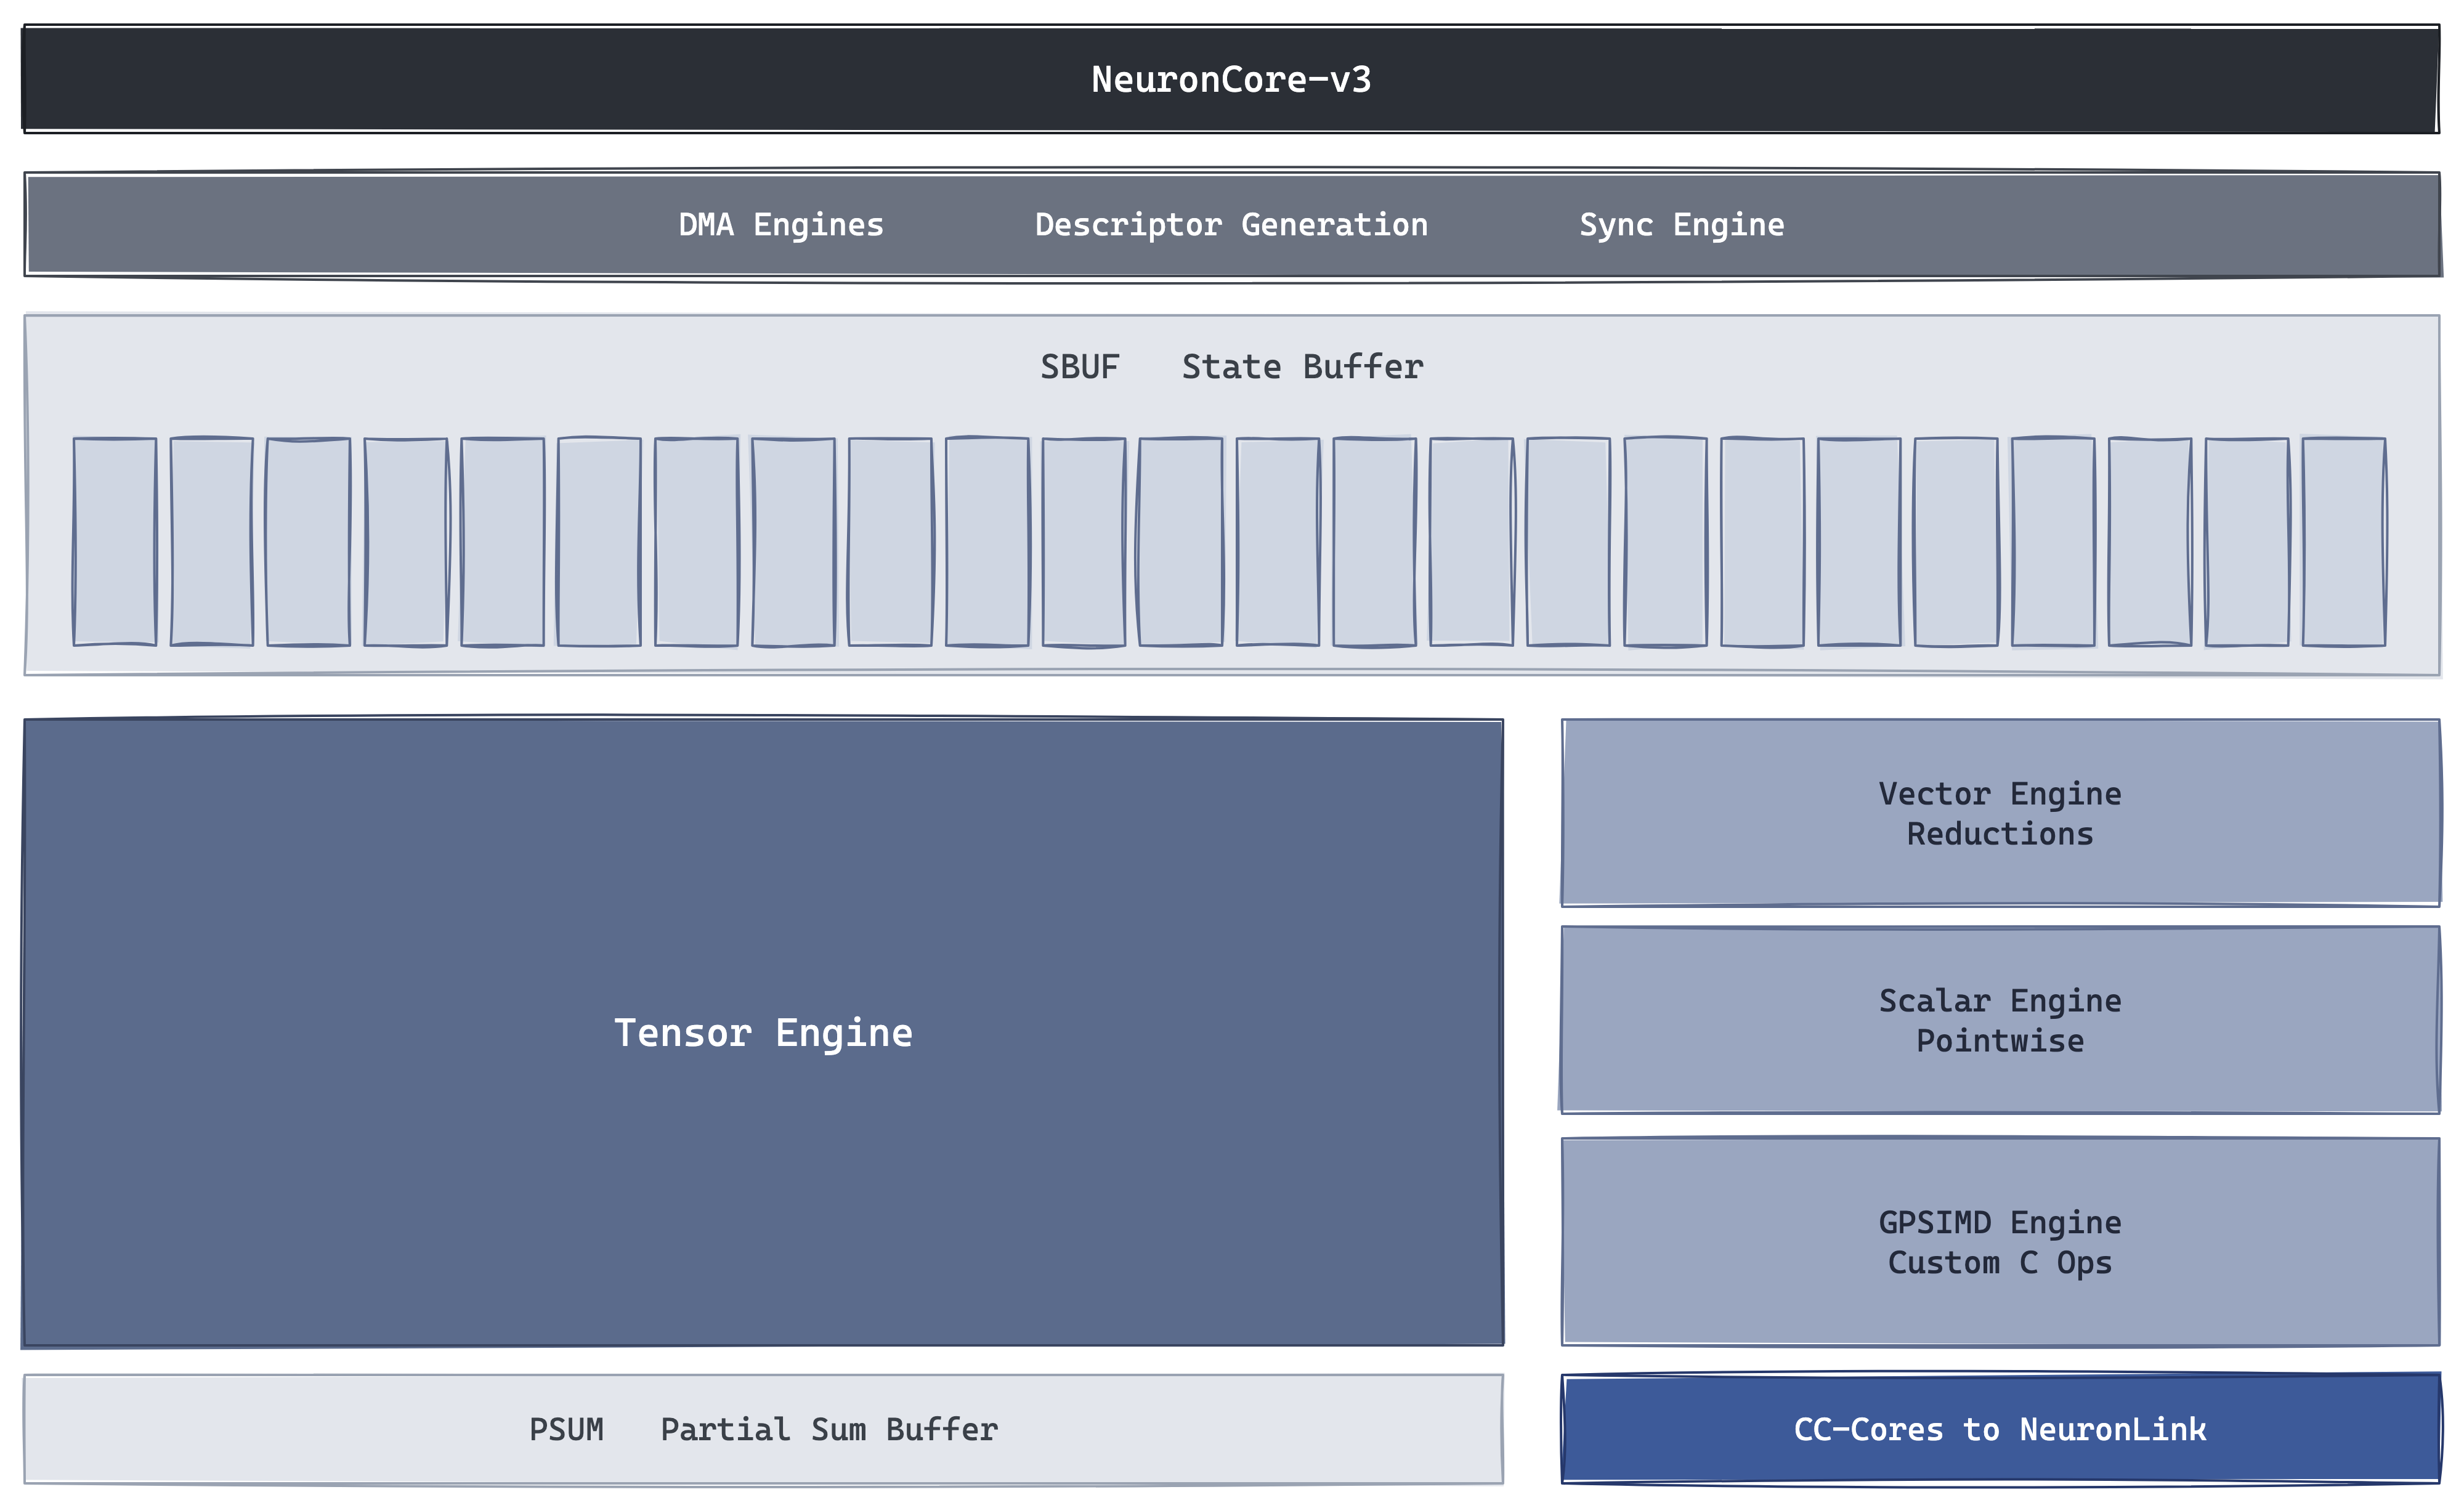
Trainium 可以看作是 AWS 按自己的系统条件重新组装了一遍 TPU playbook:没有硬件 cache,由 compiler 提前安排 software-managed SRAM 和数据搬运,但各单元的组织方式不同。每颗 Trainium 只有少量 NeuronCore(Trn1 为 2 个,Trn2/Trn3 为 8 个);每个 NeuronCore 也不是单一的 matmul engine,而是一组解耦的专用引擎:128×128 systolic array 组成的 Tensor Engine、负责 reduction 的 Vector Engine、负责 point-wise ops 的 Scalar Engine,以及 8 个可编程的 512-bit GPSIMD engine。外围还有 128 个 DMA engine、负责传输排序的 Sync Engine,以及 Trn2 开始加入的 CC-Core。系统没有 warp 或 wavefront;这些引擎按 compiler 生成的静态 dataflow schedule 并行工作。
计算
Tensor Engine 提供主要的 matmul throughput,其他 engine 负责 element-wise 与 control workload。它包含一个 128×128 weight-stationary systolic array:一块 operand 通过 LoadStationary 固定在 array 中,另一块通过 MultiplyMoving 流过阵列。partial sum 写入小型 accumulator SRAM——PSUM——并通过 read-add-write 在 K dimension 上持续累加。底层仍然是 tile MMA;区别在于 NVIDIA 把它放进 warp hierarchy,Google 由 VLIW bundle issue,而 Trainium 将其暴露成访问命名 scratchpad 的显式 instruction。
所有三代的阵列物理尺寸均固定为 128×128;变化的是每个单元装载的产品数量。 Trn1的 NeuronCore-v2 运行 BF16/FP16 和 FP32 累计提供 FP8 仅在 BF16 速率(无加速)。 Trn2的 v3 双泵 FP8 呈现有效的 256×128 阵列,第一个具有真正 2× 的 Trainium 8 位。 Trn3的 v4 包 microscaling operand 以呈现有效的 512×128,4 倍 BF16 速率。物理乘加单元的计数永远不会移动;数据路径只是为它们提供更窄的数字。
其余 engine 负责让 Tensor Engine 持续有数据可算:Vector Engine 执行 LayerNorm、Softmax、pooling 等 reduction;Scalar Engine 处理 activation、GELU 等 point-wise op;8 个 GPSIMD engine 运行可编程 C code,承接其他 engine 无法覆盖的 long-tail operator。高质量 compile schedule 会让四类 engine overlap:Tensor Engine 计算当前 matmul,Vector Engine 处理上一块 tile,DMA engine 同时搬运下一块 tile。代价也很明确:无法映射到专用 engine 的新 operator 会落到较慢的 GPSIMD path,并可能成为瓶颈。
内存
内存层次结构是应用于存储的计算原理: 三层,全部由软件管理,任何地方都没有硬件缓存。 AWS 自己的文档进行了对比,指出与 CPU 或 GPU 不同,NeuronCore 没有缓存,并且“所有内存移动在程序本身中都是明确的”。片外为 HBM (Trn1 上为 32 GB,Trn2 上为 96 GB HBM3 , Trn3 上 144 GB HBM3e )。片上最靠近引擎的是 状态缓冲区 (SBUF):主要 scratchpad,大约 20 倍 HBM 带宽,组织为 128 个分区,每个 NeuronCore 大小为 24 MiB (v2)、28 MiB (v3)、32 MiB (v4)。在数组和 SBUF 之间有 PSUM,这是一个专用于 matmul 输出的 2 MiB accumulator。数据移动 HBM → SBUF → Tensor Engine → PSUM → SBUF,每一跳均由编译器发出;硬件不会预取或逐出任何内容。
这与 Google VMEM 的思路一致:由 compiler 管理显式 scratchpad,不依赖 cache 掩盖 schedule 错误。schedule 正确时,data movement 与 compute 可以持续 overlap;schedule 错误时,则没有硬件 cache 或 prefetcher 兜底。Trainium 为相对适中的 peak FLOPs 配置了较充足的 HBM,因此每单位计算可用的 memory capacity 较高;但绝对容量仍落后于同期高端 GPU。AWS 真正利用的杠杆不是单芯片 memory leadership,而是自研芯片在 compute、HBM 和 cloud pricing 上的总体成本。
数值格式
Trainium 同样沿着 FP32 → BF16 → FP8 → FP4 演进,但有两个特点。第一是 configurable FP8:Tensor Engine 不只固定支持 E4M3/E5M2,还允许调整 exponent bias,并支持 E3M4,让 compiler 能按 tensor 在 range 与 precision 之间取舍。第二是 Trn3 的 FP4 主要节省 memory capacity 和 bandwidth,并不提高 compute throughput:MXFP4 operand 在进入 array 前会转换为 MXFP8,因此仍以 FP8 rate 执行。Trainium 也使用 microscaling 和 hardware stochastic rounding 来恢复低精度 accuracy。需要注意的是,AWS 对 sparse peak 的宣传口径与 dense datapath 并不完全一致,比较数字时必须区分 sparse 与 dense。
芯片内 collective communication
Trainium 中最没有直接 GPU 对应物的是 CC-Core。distributed training/inference 大量依赖 all-reduce、all-gather、reduce-scatter 和 all-to-all;GPU 通常通过 NCCL kernel 在 SM 上执行这些 collective,因此 communication 与 compute 会竞争同一批 execution resource。Trn2 每颗 chip 配置 20 个 CC-Core,并直接连接 NeuronLink port,使 collective 可以和 Tensor/Vector Engine 并行运行。思路与 TPU SparseCore 类似:把主 compute engine 不擅长的 workload 交给旁路专用 hardware。
设计取舍
- 押注 1:云是 Annapurna 设计芯片、服务器、机架、 Nitro 网络和云 API 作为一个堆栈,因此 Trainium 只需要在 AWS 内部的性价比上取胜,而不必在商业芯片规格表上取胜。
- 借用计算论文,不要重新发明它。 A 128×128 weight-stationary 阵列,软件管理 SBUF/PSUM scratchpad 和整个程序编译是 TPU 的押注,可重复使用以共享 Google 的 OpenXLA。节省的精力将投入到网络和机架中。
- 集体属于芯片。 专用 CC 内核 重叠 all-reduce 和 all-to-all 在硬件中进行计算,而不是将它们作为从 matmul 单元窃取 FLOP 的内核运行。
- 重用云自己的网络。 横向扩展是 EFA 与 SRD 传输:相同 Nitro-卸载、数据包喷射 RDMA 已运行 AWS 的其余部分。否 InfiniBand。
- 将拓扑移至工作负载。 Trn1 和 Trn2 复制了 TPU 的 torus; Trn3 的 NeuronSwitch 将其替换为交换 all-to-all 结构 MoE 流量超过了最近邻流量。老实说,这是遵循剧本的:首先是 Google,现在是 NVIDIA。
扩展
Trainium 把互连分成两层:紧耦合的 NeuronLink domain 连接需要协同执行的芯片,domain 之外则使用 AWS 通用的 EFA fabric。NeuronLink domain 不是 NVLink 那样的 coherent shared memory;虽然 AWS 把 UltraServer 描述为 pooled multi-TB memory system,底层语义仍是 point-to-point message passing,因此更接近 TPU ICI,而不是 NVSwitch crossbar。
纵向扩展
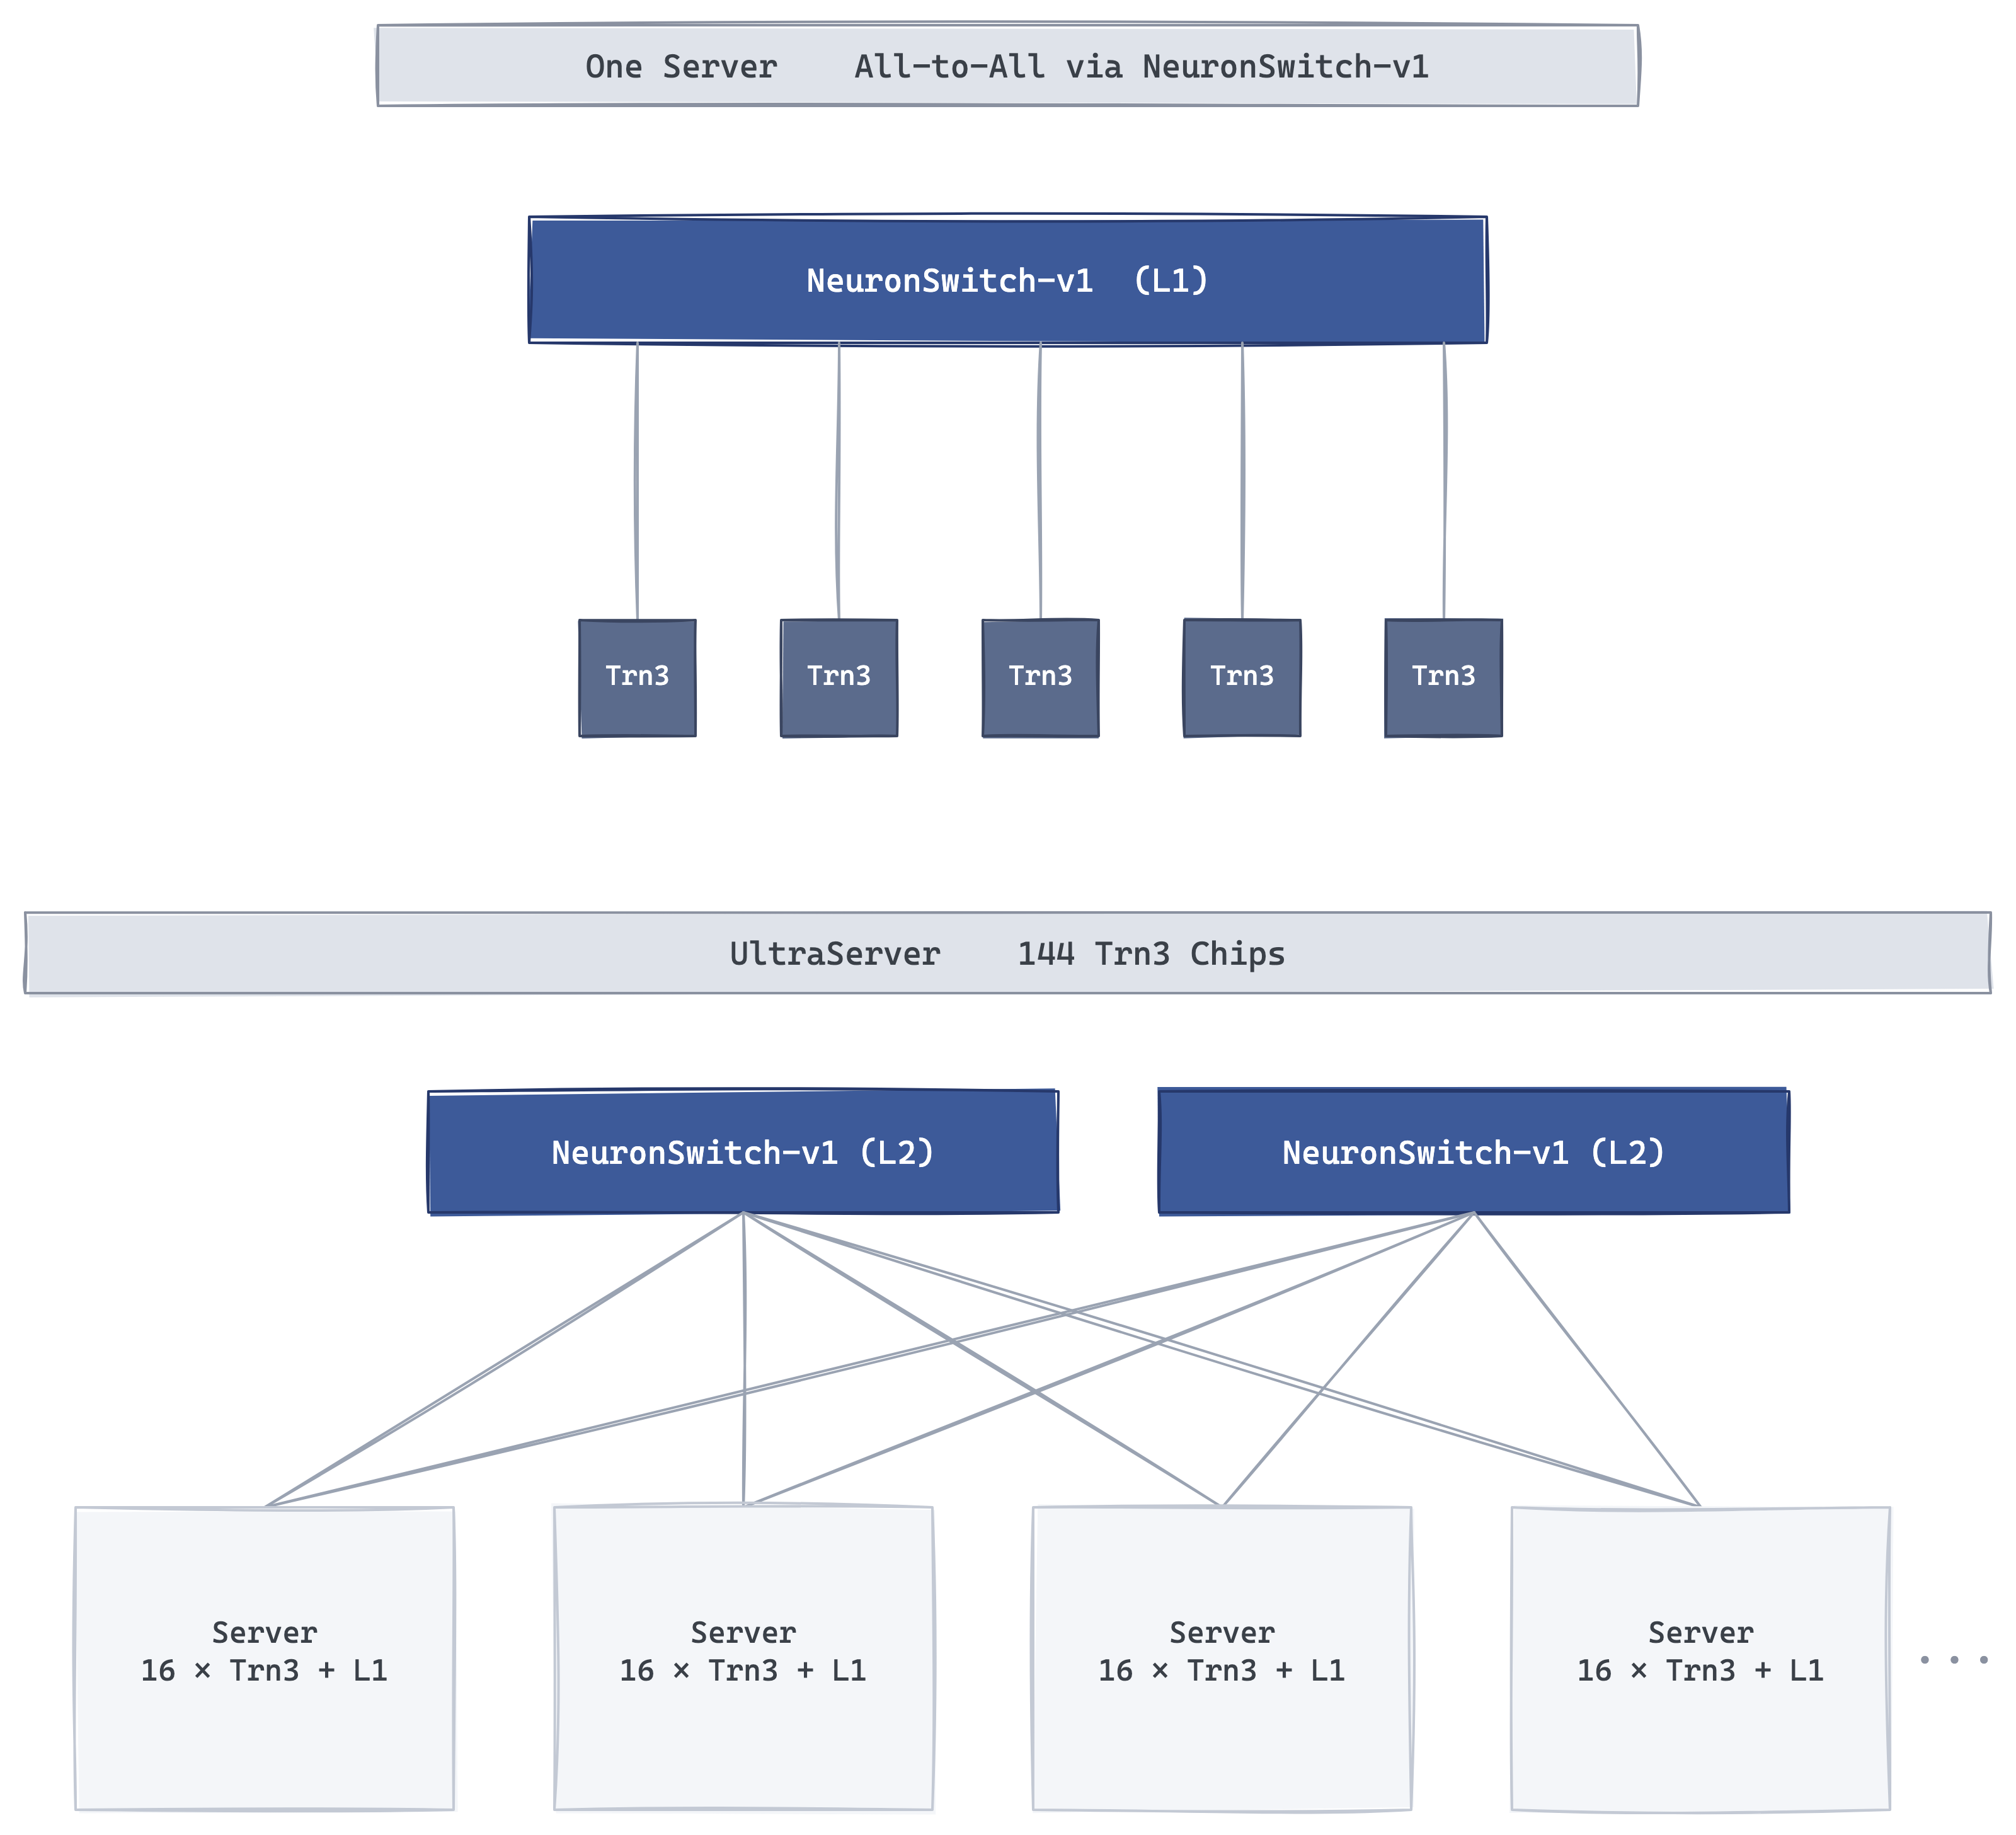
NeuronLink 是 Trainium 的在芯片到芯片结构中, NVLink 为 NVIDIA 扮演角色, ICI 为 TPU 扮演角色。通过 Trn2,它将芯片连接到 torus,这正是 TPU 的选择:单个 trn2 实例是 4×4 2D 环面中有 16 个芯片,每个芯片约为 1.28 TB/s, Trn2 UltraServer 将四个实例连接到 4×4×4 3D 环面上的 64 个芯片中,呈现 83 个密集 FP8 PetaFLOPS 和约 6 TB 的 HBM 作为一个扩展域。第三个 torus 轴故意设计得很薄(实例间环的运行速度为每个芯片约 256 GB/s,而实例内部的运行速度为 1.28 TB/s),这是 torus 的特点:廉价的布线和巨大的最近邻带宽,但代价是直径上的许多跳。 AWS 将 64 芯片 UltraServer 定位为 NVIDIA 的 72-GPU NVL72;聚合计算处于同一水平,但环面不是 crossbar,并且两者在非最近邻流量上的表现非常不同。
这种交易是 Trn3 放弃 NeuronSwitch-v1 是一种交换 全对 结构,可将芯片间带宽大致增加一倍,更重要的是,使直径变平,以便任何芯片都能在一次切换的跳跃中到达任何其他芯片。 Trn3 UltraServer 可扩展到 144 个芯片,实现 362 个密集 FP8 PetaFLOPS 和 20.7 TB 的 HBM3e。这一动机也推动 Google 走向高基数拓扑,以实现 MoE 推理: 专家路由 是 all-to-all,这是环面的最坏情况,而交换机将最长的跳跃对变成单个交叉。 Trainium 的互连路线图是行业路线图的压缩版:在工作负载为最近邻时采用环面,在不是最近邻时切换到 crossbar。
横向扩展
Scale-out 直接复用 AWS 的数据中心网络。每个 Trainium instance 通过 Elastic Fabric Adapter(EFA)接入网络,SRD transport 则由 Nitro card offload。与 RoCE 或 InfiniBand 的单条有序 flow 不同,SRD 会把 packet 分散到最多 64 条并行 path 上,可靠但乱序地送达,再由 collective library 重组,从而避免某一条拥塞 path 引发 head-of-line blocking。这套 transport 原本服务 AWS cloud network,后来直接复用于 accelerator fabric。
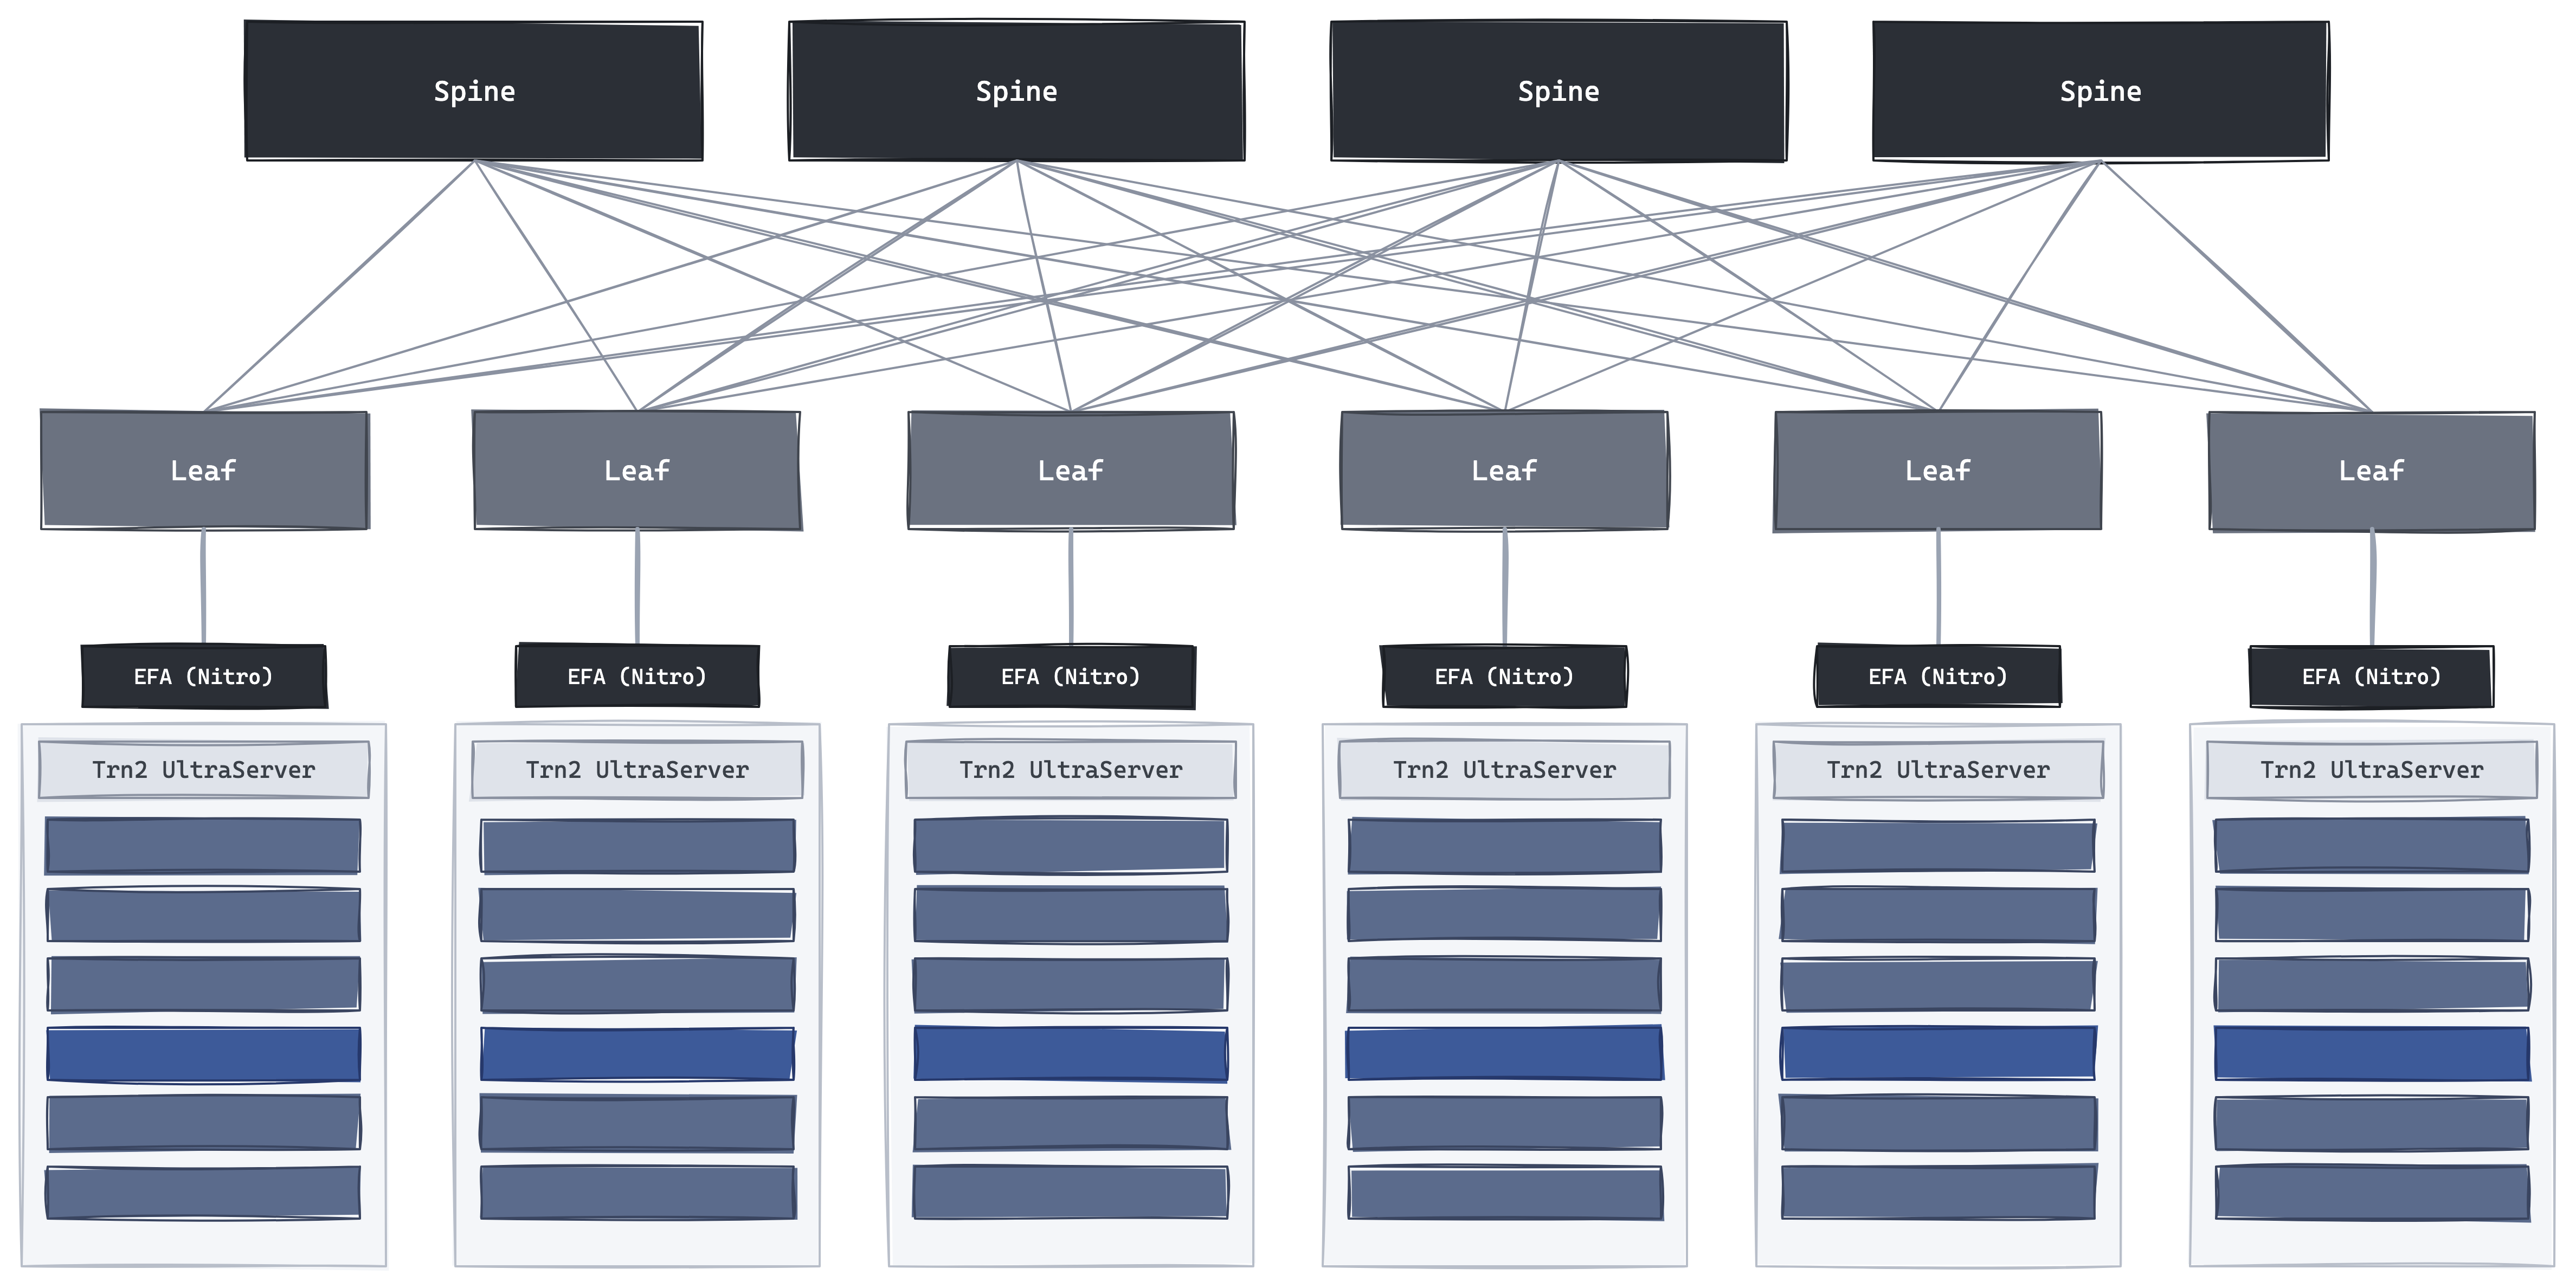
最上层是 UltraCluster,通过 10p10u network 把大量 UltraServer 连接起来;10p10u 表示整个数据中心约 10 petabits/s 的带宽和低于 10 μs 的延迟。代表性部署是 Project Rainier:约 50 万颗 Trainium2 分布在多个美国数据中心,并在 2025 年底为 Anthropic 上线;到 2026 年初,Claude 使用的 Trainium chip 已超过 100 万颗。AWS 声称 Trainium2 相比同代 Hopper instance 可提供更高 price-performance,但这个优势来自 end-to-end economics:Amazon 同时拥有 chip、Nitro network、server 和 cloud pricing。
软件栈
Trainium 的软件栈同样是 compiler-first。Neuron SDK 建立在 OpenXLA 之上:neuronx-cc 接收 XLA HLO,并 lower 成由 Neuron Runtime 加载到 NeuronCore 的 NEFF binary。torch-neuronx 通过 PyTorch/XLA 的 LazyTensor 机制记录计算图,在 step boundary 触发编译;jax-neuronx 则经 StableHLO 接入。若把 CUDA 看作 kernel-driven 的一端,把 TPU/XLA 看作 whole-program compilation 的另一端,Trainium 明显更接近后者:compiler 基本就是整个系统。
与 TPU 不同的是,Trainium 还提供更直接的 kernel escape hatch。XLA 不一定能为新的 attention variant 或 fused MoE schedule 自动生成最佳实现,因此 Neuron 提供 NKI(Neuron Kernel Interface):一种 Python tile-level kernel language,直接暴露各执行引擎以及 SBUF/PSUM scratchpad。它在 Trainium 上扮演的角色,接近 TPU 的 Pallas 或 GPU 的 Triton——当性能关键在 schedule、tiling 和 DMA,而不是代数化简时,开发者可以手动控制底层。其下的 collective communication library 把 all-reduce 和 all-to-all 映射到 CC-Core 与 NeuronLink,NeuronX Distributed 则提供上层的分布式训练与 sharding。
Trainium 与 CUDA、甚至 TPU software stack 的主要差距仍是 maturity。NKI、JAX path 和 distributed library 在较长时间内处于快速演进状态;model port 只能运行在 AWS 上,也缺少成熟的跨厂商 fallback。Anthropic 的实践最能说明这一点:它不是简单地把现有 PyTorch model 指向 Trainium,而是与 Annapurna 深度协作,自行开发低层 NKI kernel 并向 Neuron stack upstream fix。Trainium 已能支撑 frontier workload,但往往需要 hardware/software co-design,而不是开箱即用。
Groq LPU
Groq LPU 的核心是 deterministic execution。GPU/TPU 通常保留 cache、scheduler、arbitration 或 dynamic network 来容忍 latency variation;Groq 则尽量删除这些 reactive component,把 instruction、data movement 和 chip-to-chip transfer 全部交给 compiler 做 cycle-accurate scheduling。片上 memory 全部是 SRAM,network 也按静态 schedule 运行,因此一组 LPU 可以像一台大机器一样,以可预测的 latency 执行同一个 program。代价是 flexibility 较低,但优势是 batch-one autoregressive decode 的 latency 极小且稳定。
演进路线
架构
其他加速器通常先设计一个 core,再把 SM、TensorCore、CU 或 dataflow core 复制到整个 die 和整个集群。Groq LPU 采用了相反方向:它把一个传统 core 拆成贯穿芯片高度的 functional slice,分别承担 instruction control、vector ALU、matrix unit、SRAM 和 network。每个 slice 内部高度同质,但整个芯片由不同功能的 slice 横向拼接而成。数据不会停在 register file 中等待某个执行单元,而是像流水线上的部件一样,在 slice 之间向东或向西流动,每周期前进一个 register hop;VLIW instruction 则从南侧的 control plane 向北发射。compiler 在编译期知道每个 cycle、每个 operand 的确切位置,hardware 只需按确定的时序执行。这也是它最初被称为 Tensor Streaming Processor(TSP)、后来改名 Language Processing Unit 的原因。
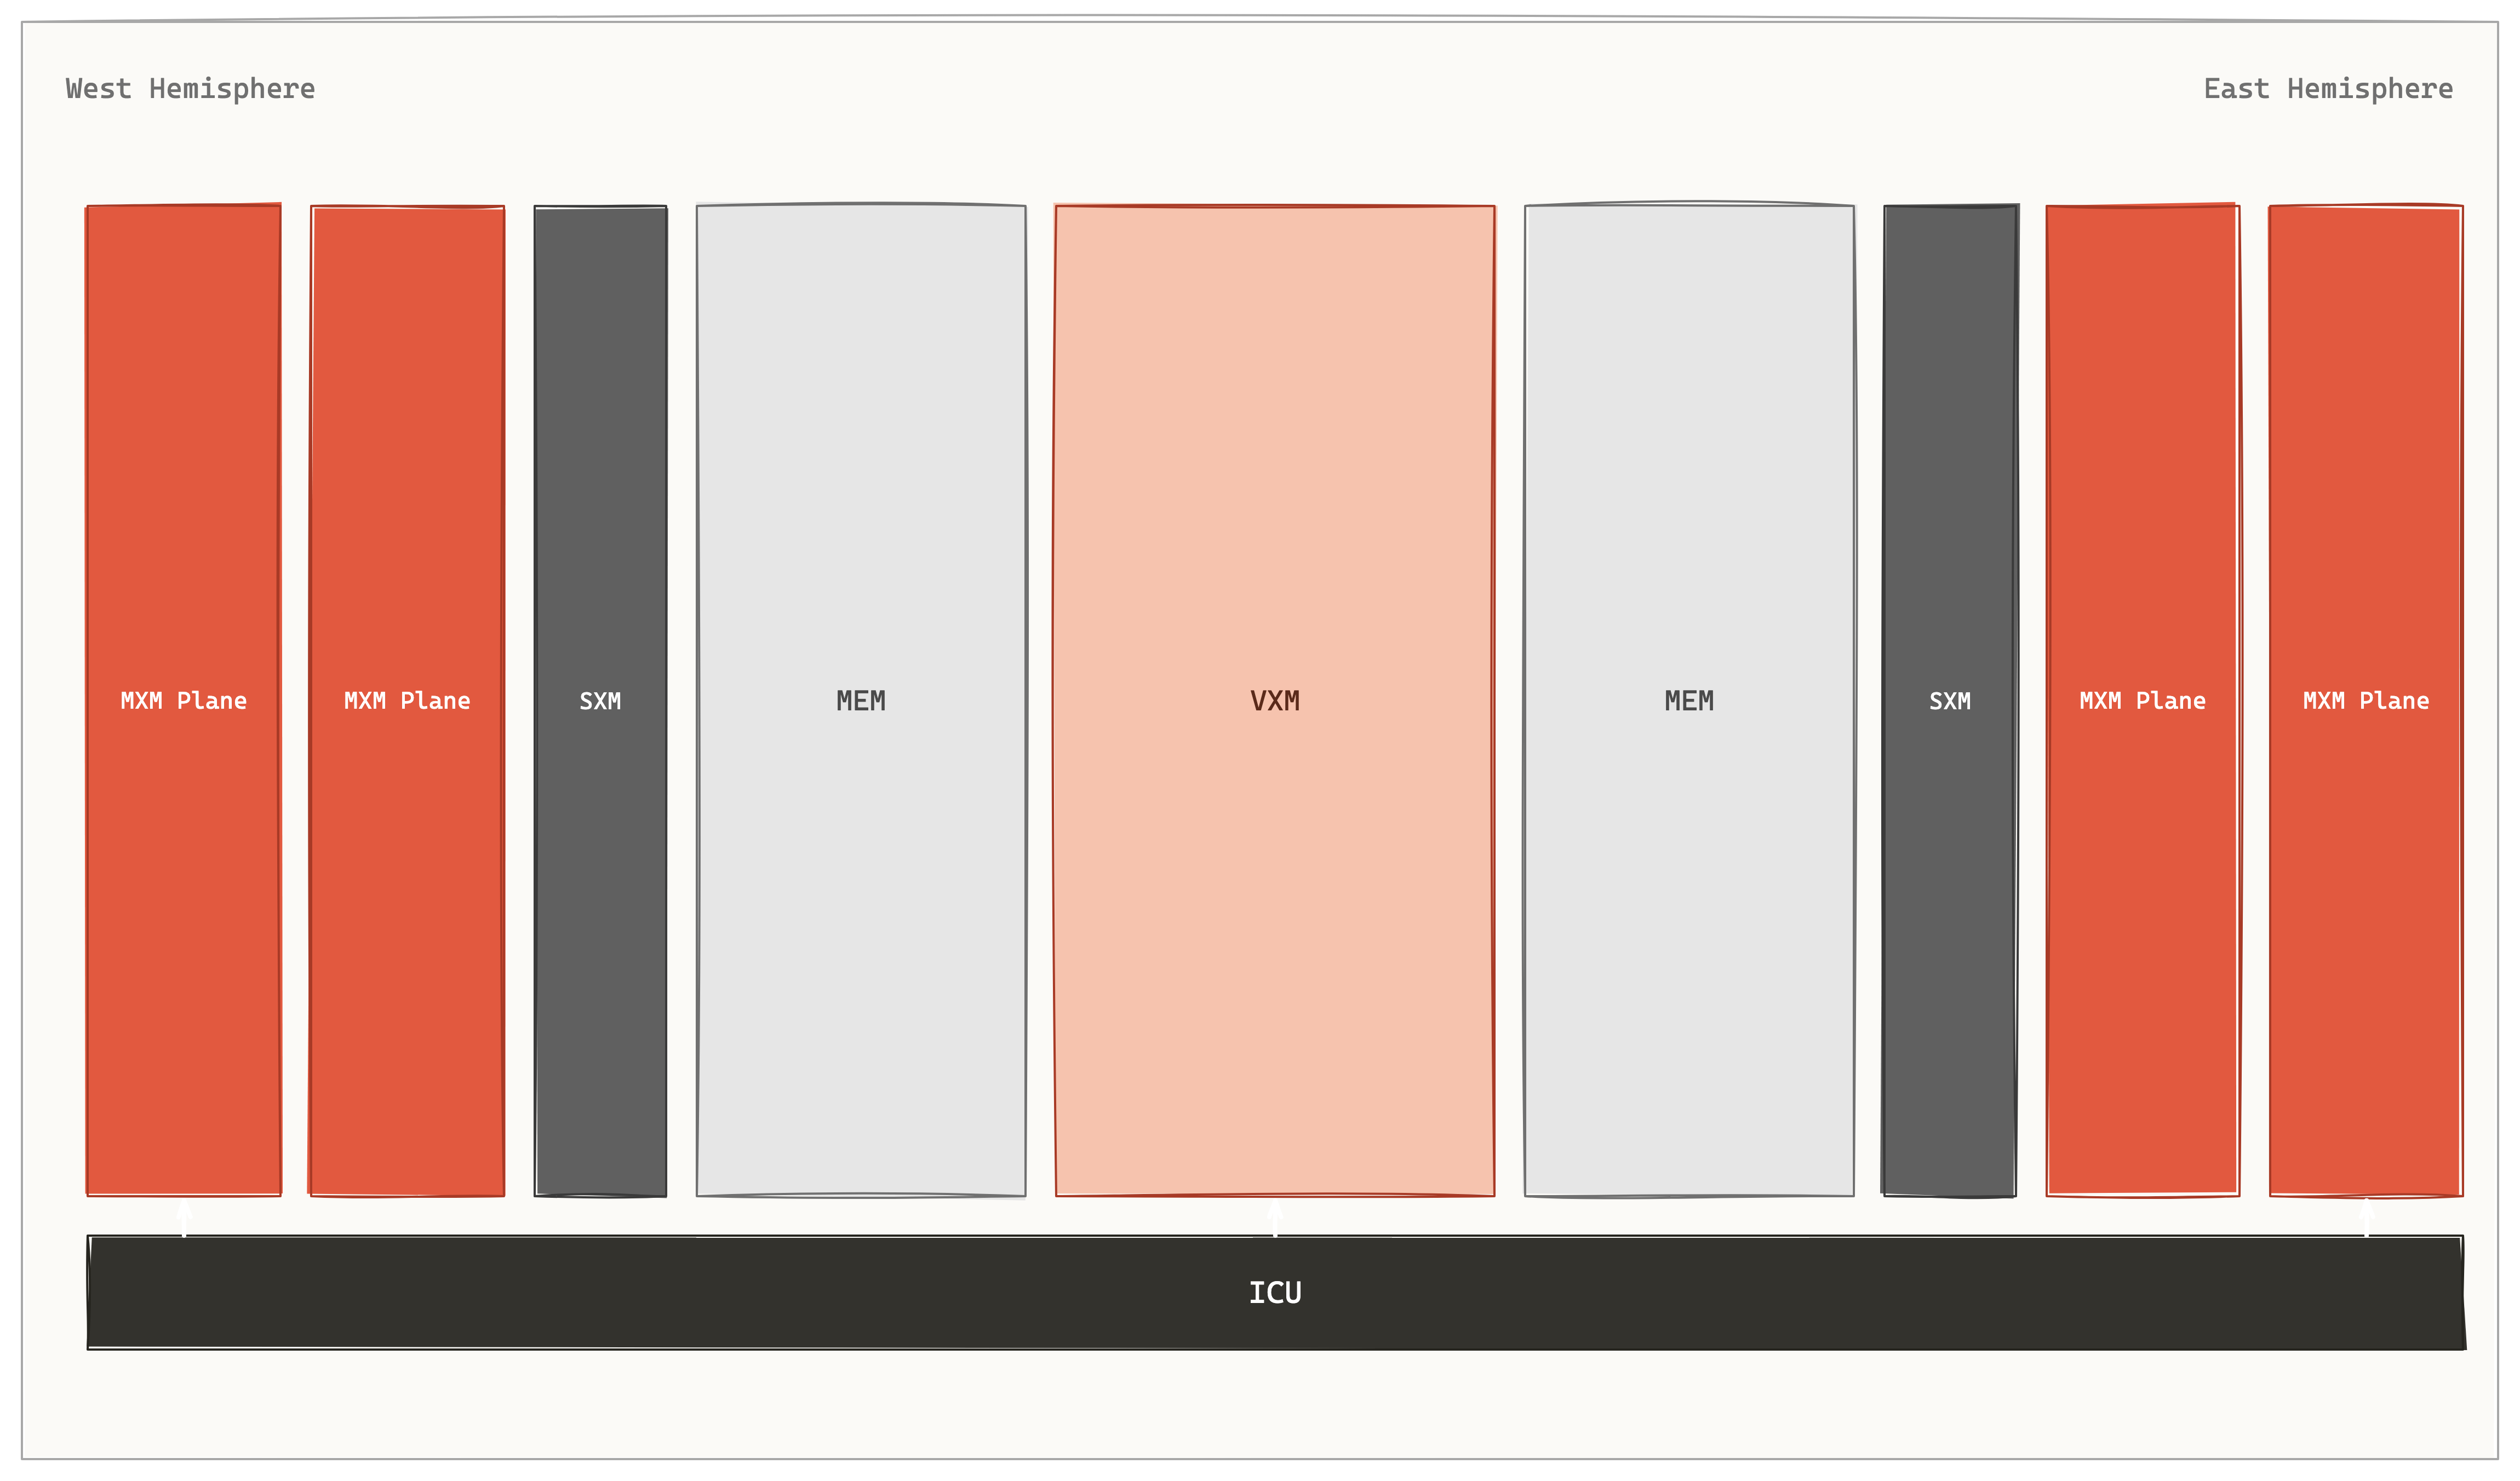
纵轴表示 SIMD width:芯片共有 320 个 lane,组织成 20 个 superlane,每个 superlane 包含 16 个 lane;额外的第 21 个 superlane 用作 yield spare,对 software 不可见。每个 functional slice 同时作用于全部 320 个 lane。横轴表示时间:每个 lane 有 64 个逻辑 stream register,其中 32 个向东、32 个向西;每个 cycle,stream register 都会沿对应方向前进一个 slice,直到被消费或离开 die。slice 从经过的数据流读取 operand,执行计算,再把结果写入继续流向下一 slice 的 stream register。芯片以中央 VXM 为轴左右镜像,因此同一个结果可以被两侧的 slice 使用。
计算
LPU 仍然把 matrix workload 放到专用单元,把其他计算放到 Vector Engine,只是两者都以 stream slice 的形式排列。matrix path 是 MXM:四个独立的 320×320 multiply-accumulate plane,每个半区两个,共包含 409,600 个 multiplier。weight 可以在 40 cycle 内装入整个 plane,随后 activation 流过并完成 accumulation。在 900 MHz 下,peak throughput 约为 750 INT8 TOPS 或 188 FP16 TFLOPS。这里没有依赖 structured sparsity 的倍率:TSP 刻意不做 data-dependent zero skipping,因为执行时间必须保持 deterministic。
芯片中央的 VXM 构成 vector path:每个 lane 有 16 个 ALU,排列成 4×4 mesh,总计 5,120 个 32-bit ALU,用于 activation、normalization、quantization 和 residual add。由于 compute unit 在空间上串联,operand 可以连续穿过多级 VXM ALU,再直接进入 MXM,而不必回写 memory;GPU kernel 需要手工实现的 operator fusion,在这里就是 slice 的物理顺序。第三类 SXM slice 负责 lane shift、320-lane permute、transpose 和 chip-to-chip link,因此 cross-lane data rearrangement 是原生 operation,不需要绕行 SRAM。
内存
没有 HBM,没有 DRAM,也没有缓存。片上是 MEM 片:88 个片(每个半球 44 个)中包含 230 MB SRAM,每个字节是计算片的单个周期,合计约为 80 TB/s。这就是整个层次结构:一层、扁平、软件寻址,没有任何会引入可变延迟访问的逐出、预取或一致性机制。
这套设计最直接的约束是容量:230 MB on-chip SRAM 根本放不下大模型。Llama-2 70B 的 FP16 权重约 140 GB,因此一个 model replica 必须切到数百颗 LPU 上,权重分布在整座机架的 SRAM 中,典型配置约需要 576 颗芯片。GPU 通常把模型放在少量 GPU 的 HBM 中,让 token 流经这些 GPU;LPU 则把模型铺在整个 SRAM cluster 上,让 token 流经整个 cluster。因此芯片数量首先由 weight capacity 决定,而不是由 compute throughput 决定。它与 Cerebras 都押注 SRAM,但方向相反:Cerebras 做一颗巨大的 wafer-scale chip,Groq 则用大量普通尺寸的 die 拼出足够大的 SRAM pool。
数值格式
数字是未走的路。这里的其他供应商每一代都将精度减半, FP16 到 FP8 到 FP4 具有块缩放功能以重新获得准确性。 TSP 停留在 FP16 和 INT8 FP32 累积,从未在芯片中交付 FP8 或 FP4。它的一个数字思想是 TruePoint:将 320 个元素的点积融合到具有 FP32 累加的单个舍入步骤中,因此 FP16 乘法器阵列在缩减方面接近 FP32 精度(Groq 报告相对于 FP32 基线)。
无论 16 位是信念还是从未获得低精度刷新的数据路径,都很难与第二代芯片从未发货的事实分开。 SRAM 容量是该架构最稀缺的资源,8 位权重将使模型所需的芯片数量减半;这种容量限制的机器有充分的理由想要 FP8,但没有将其移植到芯片上。同样的悬而未决的问题也笼罩在 Cerebras 的 16 位数据路径上,也面临同样的压力:供应商最渴望以最宽的精度进行容量计算。
确定性
所有其他加速器都隐藏延迟; LPU 公开 它。 ISA 承载每条指令的执行延迟,数据路径在构造上是固定延迟的,因此编译器会提前计算每个结果出现的确切周期。硬件中的任何东西都不会干扰该调度:没有缓存会丢失,没有仲裁器会停止,没有分支会错误预测,没有推测会展开。 Groq 自己的测量就是证明:BERT-Large 的运行在约 75 µs 的范围内返回了 24,240 次,编译器的预测延迟在测量值的 2% 以内。
这是 TPU 的本能(将调度移至编译器中,删除事后猜测的硬件)更进一步。 TPU 编译器调度芯片; LPU 编译器调度 系统,因为确定性也适用于整个网络。它与 Cerebras 完全相反,其核心是 数据流,每当 operand 恰好到达时就会触发:WSE 对数据做出反应,LPU 对其进行定时。两台机器都删除调度程序;一个将其替换为到达,另一个将其替换为时钟。
设计取舍
- 确定性优于容忍。 删除每个反应性组件(缓存、仲裁器、预测器、重新排序缓冲区)并让编译器拥有每个周期。
- 空间功能切片。 将核心分解为切片并通过它们流式传输 operand,因此融合是布局规划和数据重用,而不是 register file 舞蹈。
- SRAM 是唯一的内存。 不惜任何容量成本,无需 HBM。将保留片上模型的能力换成单周期、固定延迟访问,接受模型必须跨越数百个芯片。
- 也安排网络。 让芯片成为自己的路由器并逐周期编译通信,因此一千个芯片集群是一个确定性程序,没有交换机,也没有拥塞。
- 销售延迟,而不是吞吐量。 针对第 1 批中每个用户每秒的 token 数进行优化,该机制 GPU 最差,并且定价与产品速度相同,而不是在每个 token 的成本上进行竞争。
扩展
扩展 LPU 与这里的其他任何东西不同,因为没有单独的扩展结构需要构建:芯片已经是一个交换机。每个 LPU 最多承载 16 个芯片到芯片 RealScale 链路(11 个暴露在卡上),并同时充当计算端点和路由器。将芯片直接相互连接,集群就是一个 无缝 Multi-chip:无 NIC,无 交换机 ASIC,无架顶交换机。由于确定性贯穿这些链接,因此整个集群按照一个编译时计划运行。
纵向扩展
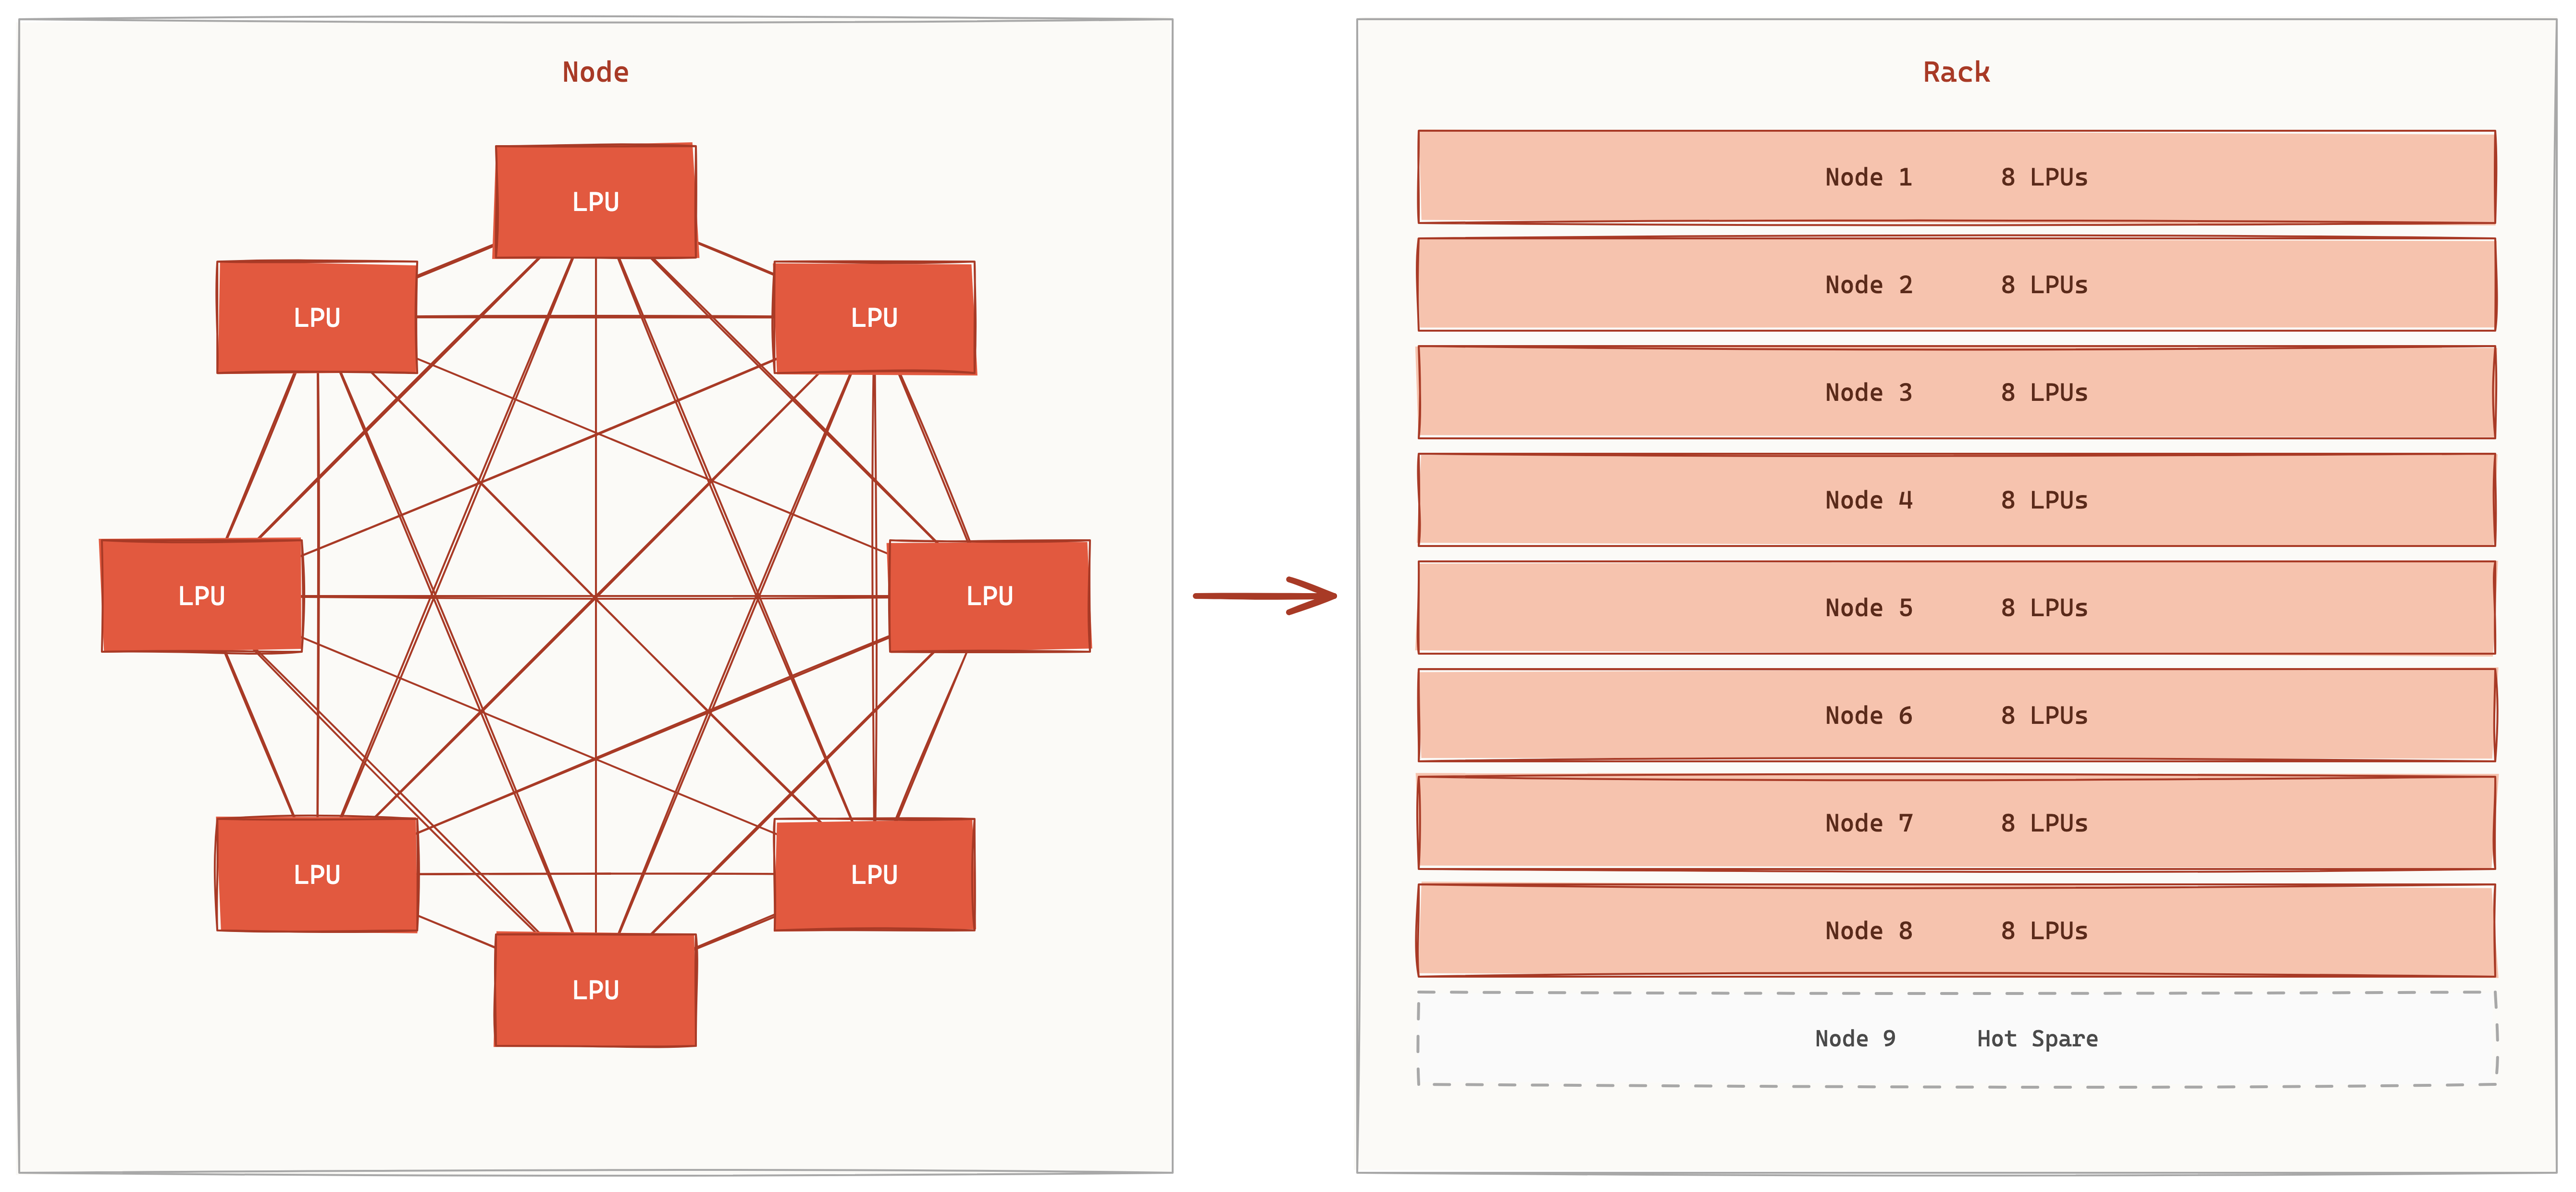
该节点有 8 个 LPU,完全连接:每个芯片的 7 个链路将其连接到其他七个芯片,因此节点中的每个芯片彼此之间都是一跳。每个芯片上剩余的 4 个链路(跨节点的 32 个链路)捆绑到 ISCA 论文中所谓的 32 端口虚拟路由器中,将节点的上行链路连接到更大的结构中。没有底板交换机,也没有一致的地址空间;远程 operand 未加载,它按 计划 到达,由源芯片在编译器选择的周期上注入,并由目标在其到达的周期上消耗。
横向扩展
在节点之外,节点连接到 Dragonfly:9 个节点构成一个 72 芯片机架(第 9 个是热备用,因此 64 个活动),并且拓扑可扩展到指定的 10,440 个芯片,其中任何两个节点相距六跳以下。结构是 软件调度:路由和流量控制移至编译时,论文的框架很生硬, 已安排,未路由。没有背压,也没有动态仲裁,因为编译器已经证明接收器已经准备好;链接携带 前向纠错 而不是重传,因为重试会扰乱时间表。保持独立时钟芯片机架同步本身就有问题:链接是 准同步的,并且该结构通过 硬件对齐计数器 在生成树上每 256 个周期进行交换来保持全局共识时间,并通过定期去歪斜指令使每个芯片恢复对齐。 Groq 报告的回报是 8 路 all-reduce 匹配 A100/NVSwitch 节点在大张量上,并在小张量上击败它,其中预定的结构不会支付动态张量所需要的握手延迟。
这种 SRAM-first 设计的成本最终体现在系统规模上。根据 SemiAnalysis 的估算,一个 Llama-2 70B replica 需要约 576 颗 LPU,并配套大量 host CPU 和 host memory;而 GPU 方案可能只需要一个 8-GPU server。单颗 14 nm LPU die 的成本不高,但完整系统需要数百颗芯片,而且 decode 时大部分 matrix compute 会空闲,真正繁忙的是 SRAM bandwidth。结论很直接:当目标是最低 latency 时,LPU 很有优势;一旦通过 batching 追求每美元 throughput,GPU 通常更划算。Groq 竞争的核心不是最低 token cost,而是响应速度。
软件栈
Groq 的 programming model 最能体现“compiler is the machine”。平台没有用户手写 kernel API:开发者输入 PyTorch、TensorFlow 或 ONNX model,compiler 将其 lower 到较小的 tensor op set,再静态安排每条 instruction、每个 stream 以及每次 chip-to-chip transfer。由于 hardware 中不存在需要动态调度的部分,开发者也不需要直接编写 wgmma 或手调 tile。优势是 compiler 可以一次性看到全局 schedule;代价是 compiler、profiler 和 runtime 都由 Groq 控制,生态规模远小于 CUDA。
该枢纽是讲述架构的用途。 LPU 的构造是 仅推理 (Ross 的框架是训练是本地游戏,推理是全局游戏),而且它在单用户 decode 延迟这一点上是不败的。独立测量支持了这一说法, 人工分析 将 Groq 列为开放模型上每秒 token 速度最快的提供商之一。它与其他部分的匹配度很差:不适合 SRAM 机架的模型、需要大批量实现每美元吞吐量的工作负载,或者静态调度无法表达的动态控制流。 MoE 提供了服务,但其依赖于数据的专家路由对于想要了解所有内容的编译器来说很尴尬。进展,Groq 几乎没有发表关于如何协调两者的文章。
故事的结尾是 NVIDIA 接手了这套技术。2025 年 12 月,NVIDIA 获得 LPU 技术的 非独占许可,并聘用了 Jonathan Ross 和团队的大部分成员。按 NVIDIA 10-K 的表述,这不是公司收购:产品、客户合同和股权都没有转移,只是交易金额让很多媒体把它简称为 acquisition。到 GTC 2026,这项技术以 NVIDIA Groq 3 LPU 的形式重新出现:一组纯 SRAM inference chip 与 Rubin NVL72 配合,GPU 执行 attention,LPU 执行 FFN 和 MoE,由 Dynamo 协调两侧切换。高度 deterministic 的 LPU 最终成为通用 GPU 系统中的 latency coprocessor;GroqCloud 则继续在原来的 14 nm 芯片上提供 token service。
对比
表中的算力均为相应精度下的 peak dense throughput;若厂商没有公开底层数据,则单独标记。Memory bandwidth 取各架构最主要的存储层:GPU、TPU、Trainium 使用 HBM,Cerebras 和 Groq 使用聚合 on-chip SRAM bandwidth,因此这些数字不能直接横向比较。Scale-up bandwidth 也沿用各厂商自己的口径,可能表示 per-chip aggregate、rack aggregate,或真正的 bisection bandwidth。
单芯片
| 公司 | 年份 | 芯片 | 加速器内存 | 内存带宽 | 旗舰密集 FLOPs | TDP | 纵向扩展带宽 |
|---|---|---|---|---|---|---|---|
 | 2023 | H100 SXM5 | 80 GB HBM3 | 3.4 TB/s | 1.98 PetaFLOPS FP8 | 700 W | 900 GB/s |
| 2024 | H200 SXM | 141 GB HBM3e | 4.8 TB/s | 1.98 PetaFLOPS FP8 | 700 W | 900 GB/s | |
| 2024 | B200 | 192 GB HBM3e | 8 TB/s | 4.5 PetaFLOPS FP8 / 9 PetaFLOPS FP4 | 1,000 W | 1.8 TB/s | |
| 2025 | B300 | 288 GB HBM3e | 8 TB/s | 7.5 PetaFLOPS FP8 / 15 PetaFLOPS FP4 | 1,400 W | 1.8 TB/s | |
| 2026 | Rubin | 288 GB HBM4* | ~13 TB/s* | ~17 PetaFLOPS FP8* / ~50 PetaFLOPS FP4* | ~1,500 W* | 3.6 TB/s | |
| 2027 | Rubin Ultra | 1 TB HBM4e* | ~32 TB/s* | ~33 PetaFLOPS FP8* / ~100 PetaFLOPS FP4* | ~1,800 W* | 3.6 TB/s | |
 | 2023 | TPU v5p | 95 GB HBM2e | 2.8 TB/s | 0.46 PetaFLOPS BF16 | n/d | 1.2 TB/s |
| 2025 | TPU Ironwood (v7) | 192 GB HBM3e | 7.4 TB/s | 4.6 PetaFLOPS FP8 | n/d | 1.2 TB/s | |
| 2026 | TPU v8t Sunfish | 216 GB HBM3e | 6.5 TB/s | 12.6 PetaFLOPS FP4 | n/d | n/d | |
| 2023 | MI300X | 192 GB HBM3 | 5.3 TB/s | 2.6 PetaFLOPS FP8 | 750 W | 896 GB/s | |
| 2024 | MI325X | 256 GB HBM3e | 6.0 TB/s | 2.6 PetaFLOPS FP8 | 1,000 W | 896 GB/s | |
| 2025 | MI355X | 288 GB HBM3e | 8 TB/s | 10 PetaFLOPS FP8 / 20 PetaFLOPS FP4 | 1,400 W | 1,075 GB/s | |
| 2026 | MI455X | 待定 | 待定 | ~40 PetaFLOPS FP4* | 待定 | n/d | |
 | 2021 | WSE-2 | 40 GB SRAM(晶圆上) | 20 PB/s(聚合) | 7.5 PetaFLOPS FP16 | 23 kW(系统) | (域 = 晶圆) |
| 2024 | WSE-3 | 44 GB SRAM(晶圆上) | 21 PB/s(聚合) | ~15.8 PetaFLOPS FP16* | 23 kW(系统) | (域 = 晶圆) | |
 | 2022 | Trainium1 | 32 GB HBM2e* | 820 GB/s | 0.19 PetaFLOPS BF16/FP8 | 不适用 | 不适用 |
| 2024 | Trainium2 | 96 GB HBM3 | 2.9 TB/s | 1.3 PetaFLOPS FP8 | ~500 W* | 1.28 TB/s | |
| 2025 | Trainium3 | 144 GB HBM3e | 4.9 TB/s | 2.5 PetaFLOPS FP8 | n/d | n/d | |
 | 2020 | GroqChip (第一代 TSP/LPU) | 230 MB SRAM | 80 TB/s(片上聚合) | 0.188 PetaFLOPS FP16 | 215 W | 330 GB/s(11 链路卡) |
| 2026 | NVIDIA Groq 3 LP30 | 500 MB SRAM | 150 TB/s(片上聚合) | ~1.2 PetaFLOPS FP8* | n/d | 2.5 TB/s |
单机架 / Pod
| 公司 | 年 | 系统 | 芯片 | 聚合密集 FLOP | 加速器内存总计 | 扩展结构 BW | 每芯片 NIC | 电源 | 冷却 |
|---|---|---|---|---|---|---|---|---|---|
| 2023 | HGX H100 | 8 | 16 PetaFLOPS FP8 | 640 GB | 7.2 TB/s | 400 Gbps (CX-7) | ~10 kW | 风冷 |
| 2024 | HGX H200 | 8 | 16 PetaFLOPS FP8 | 1.1 TB | 7.2 TB/s | 400 Gbps | ~10 kW | 风冷 | |
| 2024 | GB200 NVL72 | 72 | 360 PetaFLOPS FP8 / 720 PetaFLOPS FP4 | 13.4 TB | 130 TB/s | 800 Gbps (CX-8) | ~120 kW | 液体 | |
| 2025 | GB300 NVL72 | 72 | 540 PetaFLOPS FP8 / 1,100 PetaFLOPS FP4 | 20.7 TB | 130 TB/s | 800 Gbps | ~120 kW | 液体 | |
| 2026 | NVL144 | 144 | ~1.2 ExaFLOPS FP8 / ~3.6 ExaFLOPS FP4 | ~21 TB | ~260 TB/s* | 1.6 Tbps (CX-9) | ~200 kW* | 液体 | |
| 2027 | NVL576 (Kyber) | 576 | ~5 ExaFLOPS FP8 / ~15 ExaFLOPS FP4 | ~144 TB | n/d | 1.6 Tbps | ~600 kW* | 液冷 | |
| 2023 | TPU v5p Pod | 8,960 | 4.1 ExaFLOPS BF16 | 852 TB | (3D 环面) | (ICI = 纵向扩展 + 横向扩展) | n/d | 液体 |
| 2025 | TPU Ironwood Pod | 9,216 | 42.5 ExaFLOPS FP8 | 1.77 PB | (3D 环面) | 光学 OCS | ~10 MW* | 液体 | |
| 2026 | TPU v8t Sunfish Pod | 9,600 | 121 ExaFLOPS FP4 | ~2 PB | (Boardfly) | 光学 OCS | n/d | 液体 | |
| 2023 | MI300X 8-GPU OAM | 8 | 21 PetaFLOPS FP8 | 1.5 TB | 7.2 TB/s | 400 Gbps | ~10 kW | 风冷 | |
| 2024 | MI325X 8-GPU OAM | 8 | 21 PetaFLOPS FP8 | 2.0 TB | 7.2 TB/s | 400 Gbps | ~12 kW* | 风冷 | |
| 2025 | MI355X 8-GPU OAM | 8 | 80 PetaFLOPS FP8 / 160 PetaFLOPS FP4 | 2.3 TB | 8.6 TB/s | 400 Gbps | ~16 kW* | 液体 | |
| 2026 | Helios (MI455X) | 72 | 1.4 ExaFLOPS FP8 / 2.9 ExaFLOPS FP4 | 31 TB | 260 TB/s | n/d | n/d | 液体 | |
| 2024 | Condor Galaxy 3 | 64 晶圆 | ~1 ExaFLOPS FP16* | 2.8 TB SRAM + MemoryX | (以太网树) | 1.2 Tb/s 以太网 | ~1.5 MW* | 液体 |
| 2022 | Trn1 实例 | 16 | 3 PetaFLOPS BF16 | 512 GB | (2D 环面) | ~50 Gbps (EFA) | n/d | 风冷 |
| 2024 | Trn2 UltraServer | 64 | 83 PetaFLOPS FP8 | 6.1 TB | (3D 环形) | 200 Gbps (EFAv3) | n/d | 风冷 | |
| 2025 | Trn3 UltraServer | 144 | 362 PetaFLOPS FP8 | 20.7 TB | (NeuronSwitch) | n/d | n/d | 液体 | |
| 2022 | GroqRack | 64 个活跃(已安装 72 个) | 12 PetaFLOPS FP16 | 14 GB SRAM | 3.2 TB/s 二分 | (RealScale;无每芯片 NIC) | n/d | 风冷 |
| 2026 | NVIDIA Groq 3 LPX | 256 | 315 PetaFLOPS FP8 | 128 GB SRAM + 12 TB DDR5 | n/d(640 TB/s 聚合 C2C) | n/d | n/d | 液冷 |
* 标记由分析师得出、由时代推断或由供应商聚合得出数字; n/d 标记供应商尚未披露的规格。
这些数据说明了什么
- 每芯片 FP8 已收敛。 B200 (4.5 PF)、Ironwood (4.6 PF) 和 MI355X (10 PF) 彼此相差约 2 倍以内。单芯片军备竞赛已经接近尾声;机架和 Pod 是架构的分歧点。
- HBM 容量是 AMD 的持久胜利。 从 2023 年到 2025 年,每代产品的 192 → 256 → 288 GB 都可以与 NVIDIA 相媲美或击败。 NVIDIA 仅通过 B300(2025 年末)就达到了 288 GB; Rubin Ultra 将于 2026 年以 1 TB/封装重新占据领先地位。
- 机架规模扩展是 NVIDIA 在 2026 年之前的胜利。 GB200 / GB300 NVL72 是唯一一款在 2026 年出货的连贯机架规模域。 2024–2025; AMD 在盒子上进行了扩展,直到 Helios 才达到机架规模。 TPU 回避了这个问题:它的 torus 既是机架又是集群。
- TPU pod 的芯片数量让任何 NVIDIA 机架相形见绌。 Ironwood pod = 9,216 个芯片,实现 42.5 ExaFLOPS FP8; NVL576 = 576 个 GPU,可实现约 5 ExaFLOPS FP8。 TPU 的单芯片统一速率 × 大规模 Pod 方案可以为每个系统带来更多的聚合计算,但代价是每芯片带宽。
- 每个芯片的功耗正在快速上升。 700 W(Hopper)→ 1,000 W(Blackwell、MI325X)→ 1,400 W(B300、MI355X)→ ~1,800 W(Rubin Ultra,分析师)。超过 ~1,000 W 时必须采用液体冷却;空气冷却有效地以 Hopper 结束。
- 横向扩展 NIC 带宽使每一代 NVIDIA 翻倍。 400 Gbps(CX-7、Hopper)→ 800 Gbps(CX-8、Blackwell)→ 1.6 Tbps(CX-9、Rubin)。 AMD 落后一代(Pollara 400 → Vulcano 800),反映出 Pensando 较小的安装基础和较晚的集成。
- Cerebras 打破了桌子的轴。 完全没有 HBM:44 GB 晶圆上 SRAM,总计 21 PB/s,每个密集 FLOP 约 1.3 字节,其中 GPU 行数接近 0.002。成本在同一行中显而易见:比单个 H200 更少的总内存、每个现代 GPU 后面的每瓦密集 FLOP 以及一个空的扩展列,因为相干域是晶圆本身。
- Trainium 在经济上竞争,而不是规格表。 它落后的每个芯片(Trn2 的 1.3 PF FP8 大约是 MI355X 的四分之一),但 Trn2 UltraServer 在 2024 年与 NVL72 一起达到了 64 芯片机架规模扩展,作为消息传递环面而不是相干 crossbar,并且 Trn3 转向交换 NeuronSwitch 结构。 AWS 拥有从 Nitro 卡到 API 的每一层,并且由一个主力租户(Anthropic,超过一百万个 Trainium2 芯片)对其进行前沿规模验证。
- Groq 用容量换取 SRAM 带宽,然后根据芯片数量扩展内存池。 第一个 GroqRack 仅公开 14 个 GB 跨 64 个活动芯片; Groq 3 LPX 在 256 个芯片上以 40 PB/s 的总 SRAM 带宽将其容量增加到 128 GB。其 12 TB DDR5 层以及与 Rubin 的搭配表明,LPU 是对大内存 GPU 机架的补充,而不是取代。